让AI读懂Unity场景:实时导出JSON打通信息鸿沟

痛点:AI IDE只能看到代码,看不到场景
用Unity做游戏的开发者可能都遇到过一个尴尬的场景:我们用各种AI编程工具(AI IDE)来辅助写代码,AI可以根据脚本告诉我们问题在哪、帮我们设计架构。但问题是,AI只能拿到Assets目录下的脚本资产,却完全不知道这些脚本最终挂载到了哪些物体上、场景的层级结构是什么样的。
当前主流的AI编程助手(如Cursor、Windsurf、GitHub Copilot等)主要通过读取项目文件系统中的代码文件来构建上下文。它们的工作方式是对代码仓库建立索引,然后根据当前编辑的文件和用户的提问,检索相关的代码片段填入大模型的上下文窗口。这种机制天然适合纯代码项目,但对于Unity这类重度依赖可视化编辑器配置的项目,文件系统中的.cs脚本文件只代表了项目信息的一小部分,大量关键信息被锁在二进制资产和编辑器状态中。
从技术架构来看,这些AI编程助手的核心基于RAG(Retrieval-Augmented Generation,检索增强生成)范式。它们首先对项目中的所有文件建立向量嵌入索引(Vector Embedding Index),将代码片段转化为高维向量空间中的点,然后在用户提问时通过语义相似度检索最相关的代码块。Cursor使用的是基于Tree-sitter的AST解析来理解代码结构,Windsurf则强调其对整个代码库的深度索引能力。但这些工具的共同前提是:项目信息必须以可解析的文本文件形式存在于磁盘上。对于Unity项目而言,.meta文件中的GUID映射、ScriptableObject的序列化数据、Animator Controller的状态机配置等,虽然技术上是文本文件,但其结构对于基于代码训练的语言模型来说几乎等同于黑箱。
这是一个被很多人忽视的信息鸿沟。在Unity中,脚本写完后并不会自动生效,它必须挂载到具体的GameObject上才能运行。Unity采用组件式架构(Component-Based Architecture),游戏对象本身只是一个容器,所有功能都通过挂载不同的组件来实现。这种架构源于对传统面向对象继承体系的反思——在早期游戏引擎中,角色类往往通过深层继承链来扩展功能,容易导致「钻石继承」等结构性问题。Unity选择了组合优于继承(Composition over Inheritance)的设计哲学,每个GameObject本质上只是一个Entity ID加Transform组件,所有行为通过附加Component来实现。这种设计意味着同一份脚本代码可以被挂载到完全不同的物体上,产生截然不同的行为。而层级结构、组件挂载关系、参数配置,这些都是游戏制作者在Unity编辑器里手动完成的工作——AI对此一无所知。
Unity将场景数据序列化存储在.unity文件或.prefab文件中,这些文件虽然是YAML格式的文本文件,但结构极其复杂且充满GUID引用,对AI来说几乎不可读。Unity使用的YAML序列化格式遵循YAML 1.1规范,但加入了大量Unity特有的标记。每个序列化对象以--- !u!开头,后跟classID(标识组件类型的数字编号,如MonoBehaviour是114,Transform是4),然后是该组件实例的fileID。对象间的引用通过{fileID: xxx, guid: yyy, type: z}的结构表示,其中guid指向.meta文件中定义的资产唯一标识符。这意味着要完整解析一个prefab中脚本组件引用了哪个C#类,需要先找到该引用的guid,再从对应的.meta文件中定位到实际的.cs文件。这种间接引用机制虽然保证了资产重命名和移动时引用不断裂,但也使得静态文本分析变得异常困难。即使AI尝试解析这些文件,也很难从中还原出人类在编辑器中看到的直观层级关系。这就是问题的根源所在。
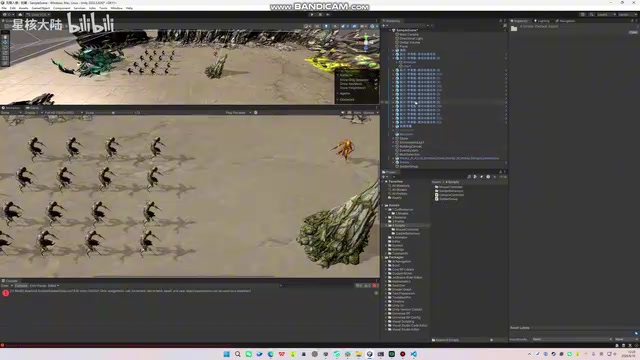
层级结构:AI看不见的关键信息
以一个普通的士兵单位为例,它的层级结构其实相当复杂。最外层不是模型本体,而是负责碰撞、导航、状态机管理、移动射击等逻辑的空物体;再往下才是各个骨骼层级,末端还挂载着近战武器(左手、右手),最底层则是负责整个身体表现的节点。

这套层级设定完全由游戏制作者自行设计,每一层负责什么、挂载哪些脚本或Unity内置组件,都是人为决策的结果。换句话说,大量的核心工作其实是在Unity编辑器里完成的,而非纯代码层面。
当AI只能看到脚本文件时,它得到的信息是极不全面的。比如一个真实案例:人物移动使用了NavMesh Agent(导航网格代理),但总感觉手感不跟手。NavMesh Agent是Unity内置的AI导航系统组件,底层基于Mikko Mononen开发的开源Recast & Detour库构建。Recast负责导航网格的生成:首先将场景几何体体素化(Voxelization)为高度场(Heightfield),然后通过区域分割、轮廓提取、多边形网格化等步骤生成最终的导航网格。Detour则负责运行时的路径查询,使用A*算法在多边形网格上进行寻路,并通过字符串拉直(String Pulling/Funnel Algorithm)将多边形路径转化为平滑的路径点序列。NavMesh Agent组件在此基础上添加了局部避障(基于RVO——Reciprocal Velocity Obstacles算法)和路径平滑功能。开发者需要在编辑器中设置Agent的半径、高度、速度、加速度、角速度、停止距离等参数,这些参数直接影响角色的移动手感。
所谓「不跟手」的问题,通常与加速度(Acceleration)、角速度(Angular Speed)和停止距离(Stopping Distance)的数值配置有关。这些参数之间存在微妙的耦合关系——例如高加速度配合低角速度会导致角色冲过弯道,而过小的停止距离则会引起目标点附近的抖动。Speed决定最大移动速度,Acceleration影响启停的响应感,Angular Speed控制转向灵敏度,Stopping Distance定义到达目标前的减速区间,Auto Braking决定是否在接近目标时自动减速。这类调优工作本质上是数值设计,需要反复试验。而这些数值完全存储在组件的Inspector面板中,不会出现在任何C#脚本文件里。这也解释了为什么Agent的参数调优如此依赖Inspector中的数值配置——因为这些参数直接影响RVO避障的计算半径和A*寻路的代价估算。
要让AI帮忙调优,开发者不得不反复截图——把层级结构截图给AI、把每个层级挂载的脚本截图给AI、把用到的参数数值也截图给AI。来回沟通,效率极低。
解决方案:用脚本实时导出场景为JSON
思路很直接:既然AI拿不到编辑器里的信息,那就写个脚本,把这些信息实时导出成AI能读懂的格式。

具体做法是编写一个Unity Editor脚本,实时获取层级面板下的完整模型树,以及每个层级下挂载的组件名称、组件参数、参数的当前值。这里需要解释一下Editor脚本的特殊性:它是仅在编辑器环境下运行的特殊脚本,通常放置在名为Editor的文件夹中,不会被打包到最终的游戏构建中。这类脚本可以访问UnityEditor命名空间下的API,包括获取当前打开的场景、遍历层级面板中的所有GameObject、读取组件的序列化属性等。
在技术实现层面,核心API包括:EditorSceneManager.GetActiveScene()获取当前场景,scene.GetRootGameObjects()获取根节点,然后递归遍历Transform.childCount来构建层级树。对于组件属性的读取,SerializedObject和SerializedProperty API允许以统一方式访问所有可序列化字段,包括公开变量、带[SerializeField]标记的私有变量,甚至是Unity内置组件的属性。
值得深入理解的是,Unity的序列化系统是一个独立于C#反射机制的底层数据管理系统。当Unity保存场景或prefab时,它不是通过.NET反射来遍历对象字段,而是通过自己的序列化后端(基于C++实现的SerializedFile系统)来读写数据。SerializedObject API提供了对这个底层系统的托管代码访问接口。与反射相比,它的优势在于:能访问Unity内置C++组件的属性(如Rigidbody的mass字段实际存储在C++层);能正确处理多对象编辑、Prefab覆盖(Override)和撤销系统;能获取属性的元数据如Range、Tooltip等Attribute信息。SerializedProperty还支持迭代器模式,可以通过Next()方法遍历一个组件的所有可序列化属性,无需预先知道类型定义。这比通过反射读取更可靠,因为它直接访问Unity的序列化层,能获取到Inspector面板中显示的完整信息。
通过EditorApplication.hierarchyChanged等事件回调,脚本可以监听场景变化并自动触发重新序列化。
这些信息会被导出到工程目录下的Scene Live.json文件中。打开这个JSON文件,可以看到完整的场景快照:从Sample Scene场景根节点开始,包含每个对象的路径(如Main Camera)、挂载的组件(如Transform、Camera及其数值)、地形(Global Volume)、建筑物挂载的各类脚本等等。整个模型树、组件挂载关系、参数数值,一目了然。
关键在于**「实时获取」**这四个字——JSON文件会随着编辑器中的改动同步更新,而不是一次性的静态快照。
效果:给AI开放更多「视野」
有了这个JSON文件后,工作流就变得简单了:只需要把JSON的路径丢给AI,AI就能拿到整个游戏的完整信息——不再只是脚本资产,还包括场景的实际使用情况、层级结构和组件配置。

实际测试表明,把JSON交给AI后,它确实能够准确读取并理解完整的层级树和组件挂载情况。这意味着:
- 架构设计更精准:AI了解了真实的场景组织方式,给出的建议更贴合实际工程;
- 定位Bug更高效:不再需要反复截图沟通,AI能直接看到参数配置,快速判断问题所在;
- 调优更省心:像NavMesh Agent手感调整这类涉及具体数值的问题,AI可以直接基于当前数值给出修改建议。
本质就是**「给AI开放的权限更多了」**——信息越完整,AI能提供的帮助就越有价值。
值得注意的是,这种方案在实际应用中也面临上下文窗口的工程挑战。当前大语言模型的上下文窗口虽然已扩展到128K甚至更长token,但有效利用率仍然是关键问题。研究表明,模型在处理超长上下文时存在「中间遗忘」(Lost in the Middle)现象——这一现象由Stanford和UC Berkeley的研究者在2023年的论文中系统性地证实。实验表明,当关键信息被放置在长文档的中间位置时,模型的检索准确率可能从首尾位置的90%以上骤降至中间位置的50%左右。这一现象的根源在于Transformer架构的注意力机制——虽然理论上Self-Attention可以关注任意位置的token,但训练过程中形成的位置偏好(Positional Bias)使模型倾向于更关注输入的开头和结尾。
一个中等规模的Unity场景可能包含数千个GameObject,完整序列化后的JSON可能达到数MB,远超上下文窗口容量。因此,实际使用时可能需要智能的过滤和摘要策略:省略默认值参数、按逻辑相关性组织层级结构、支持按区域或功能模块进行局部导出等。更好的实践是将用户当前关注的GameObject及其父子链放在输入的显著位置,使用摘要性的场景概览作为开头,以及实现按需查询的分层检索机制。
一点延伸思考
这个小工具虽然简单,却点出了当前AI辅助开发的一个普遍局限:AI的能力上限,往往取决于它能获取到多少上下文信息。在游戏开发这种「代码+编辑器」双轨并行的场景里,纯代码维度的信息只是冰山一角。
随着MCP(Model Context Protocol)等上下文协议的兴起,未来或许会有更标准化的方案让AI直接接入Unity编辑器、Unreal引擎等工具的运行时状态。MCP是Anthropic在2024年底提出的开放协议,旨在为AI大模型提供标准化的上下文接入方式。它采用客户端-服务器架构,AI模型作为客户端通过JSON-RPC 2.0协议与MCP Server通信。Server负责暴露工具(Tools)、资源(Resources)和提示模板(Prompts)三类能力。
MCP的通信层基于JSON-RPC 2.0规范,这是一个轻量级的远程过程调用协议,每个请求包含method(方法名)、params(参数)和id(请求标识符)三个核心字段。MCP在此基础上定义了三种传输方式:stdio(标准输入输出,适合本地进程间通信)、HTTP with SSE(Server-Sent Events,适合远程服务)和WebSocket。对于Unity编辑器场景,最自然的实现方式是将MCP Server作为Editor插件运行,通过stdio与AI客户端通信。Server暴露的Tools可以包括:query_hierarchy(查询场景层级)、get_component_properties(获取组件属性)、modify_property(修改属性值)、instantiate_prefab(实例化预制体)等。每个Tool都有JSON Schema定义的输入输出规范,AI模型可以通过Function Calling机制自主决定何时调用哪个工具。
在游戏开发领域,MCP的潜力在于让AI直接读取引擎的运行时状态、资产数据库、构建配置等信息,甚至可以反向操作编辑器。与本文介绍的JSON导出方案相比,MCP的核心优势在于支持双向交互——AI不仅能读取场景状态,还能通过调用工具来修改参数、创建对象、触发构建等操作,实现真正的AI驱动开发工作流。这种架构的关键优势在于支持多轮交互——AI可以先查询场景概览,再根据结果深入查询特定物体的详细信息,而不需要一次性加载所有数据。目前已有社区开发者在尝试为Unity和Unreal构建MCP Server,但尚未形成成熟的生态。
但在此之前,像这样「把编辑器状态序列化为JSON喂给AI」的朴素做法,恰恰是最实用、最容易上手的过渡方案。
它给我们的启示是:想让AI更好地帮你,先想办法把你的完整工作上下文「翻译」成AI能理解的形式。
核心要点
- Unity的组件式架构导致大量关键信息存储在编辑器配置中而非代码文件里,AI编程工具基于RAG范式的文件系统索引机制无法触及这些信息,即使YAML格式的场景文件也因复杂的GUID间接引用而难以被语言模型有效理解
- 通过编写Editor脚本,利用SerializedObject API(直接访问Unity底层C++序列化系统而非.NET反射)实时将场景层级结构、组件挂载和参数数值导出为结构化JSON,弥合了AI与编辑器之间的信息鸿沟
- 这种方案在实际使用中需要关注上下文窗口的容量限制和「中间遗忘」效应,可能需要智能过滤策略(如省略默认值、分层检索、按功能模块局部导出)来控制JSON的体积并确保关键信息处于模型注意力的有效区域
- MCP协议代表了更长远的解决方向——通过基于JSON-RPC 2.0的标准化双向通信协议让AI直接接入引擎运行时,支持多轮交互式查询和编辑器操作,但当前JSON序列化仍是最务实的过渡方案
相关推荐

用n8n打造AI每日新闻简报:20秒告别信息过载
一位 YouTube 创作者用 n8n 搭建 AI 每日新闻简报工作流:RSS 抓取路透社头条、AI 去标题党并摘要、写入 Supabase 数据库、推送 Telegram,20 秒读完全球资讯。本文拆解其实现逻辑与借鉴价值。

Zapier、Make、n8n实测对比:同一AI工作流三次翻车
Zapier、Make、n8n三款自动化工具实测对比:用同一个AI线索分类工作流各搭一遍,三者全部翻车。深度拆解搭建时间、运行速度、计费逻辑及各自的静默失败陷阱,帮你选对AI自动化平台。

用n8n搭建AI内容引擎:全自动运营Facebook主页实战
一位创作者用开源工具n8n搭建AI内容引擎,实现Facebook主页全自动运营:选题、写作、配图、审核、发布五步流水线,287篇写出238篇发布,拆解其人机分工逻辑与可复制性。