让AI文本检测器跟上变化:更灵活的训练方法

新研究提出更灵活的训练方法,让AI文本检测器在新模型和伪装文本面前保持稳健。
文章讨论AI文本检测器跟不上生成模型迭代的问题。现有检测器依赖固定训练数据学习人类与AI文本的统计差异,一旦出现新模型或AI文本被伪装改写,特征分布偏移就会导致准确率下降。新研究提出更灵活的训练思路,不把检测器绑定在固定特征上,而是让训练过程适应条件变化,从而在分布偏移时仍保持判断力。文章指出该方法在教育、内容平台、新闻核查等场景有实用价值,但原文未披露技术细节与性能指标,提升幅度无法量化。稳健性仍是长期攻防课题,需独立验证。
AI生成文本的泛滥让检测器成为刚需,但检测器往往跟不上生成模型的迭代速度。一项新研究提出更灵活的训练方法,旨在让AI文本检测器在面临新模型或伪装文本时保持稳健。
检测器为何总慢半拍
AI文本检测器的核心任务是判断一段文字是否由机器生成。主流思路是训练一个分类器,学习人类文本与AI文本在统计特征上的差异。问题在于,这种训练方式高度依赖训练数据所覆盖的模型和场景。
一旦出现新的生成模型,或者有人刻意把AI文本改写得像人写的,检测器学到的特征分布就会偏移,准确率随之下降。换句话说,检测器的“知识”容易过时,而生成模型却在持续进化。
据该研究描述,现有方法在面对新模型涌现或AI文本被伪装成人类文本时,稳健性不足。这正是新训练方法试图解决的核心痛点。
分布偏移是理解检测器失效的关键概念。它指的是训练数据与部署时遇到的真实数据在统计分布上不再一致。对AI文本检测器而言,训练集通常由特定几款生成模型在特定提示下产出的文本构成;当新模型出现,其用词习惯、句长分布、标点模式都会与旧模型不同,检测器学到的决策边界就不再适用。分布偏移分为协变量偏移(输入特征分布变化)和概念偏移(同一特征对应的标签含义变化),AI文本检测同时面临两者:新模型改变文本特征,而“像人写的AI文本”则改变了特征与标签的对应关系。这正是检测器准确率随模型迭代而下降的根本原因。
更灵活的训练思路
研究提出的方法强调“灵活性”:不把检测器绑定在某一组固定的文本特征上,而是让训练过程能适应条件的变化。原文给出的概括是,这种更灵活的训练方法能让AI文本检测器在新模型出现或AI生成文本被伪装时更加稳健。
这里的关键词是“稳健”(robust)。检测器不再只是记忆训练集里的模式,而是被训练成在分布发生变化时仍能保持判断力。对于实际部署场景来说,这比在固定测试集上刷高分更有价值——真实世界里的文本来源和改写手段一直在变。

**稳健性(robustness)**在机器学习中特指模型在输入受到扰动、分布发生变化或遭遇对抗性样本时,仍能维持性能的能力。它与“在固定测试集上准确率高”是不同维度:一个模型可以在同分布测试集上达到99%准确率,却在新模型文本上跌到随机猜测水平。稳健性通常通过领域泛化、对抗训练、持续学习等途径提升。文章所说的“灵活训练”本质上属于提升分布外泛化能力的方向,目标是让检测器学到更本质的判别信号,而非记忆某个模型特有的表面模式。评估稳健性需要构造分布偏移的测试集,这也是该研究后续需要独立验证的关键环节。
为什么这件事重要
AI文本检测的应用场景正在扩大:教育领域需要判断作业是否由AI代写,内容平台需要识别批量生成的垃圾内容,出版和新闻机构需要核查稿件来源。这些场景的共同点是,对手(生成模型或刻意伪装者)会不断调整策略。
如果检测器只能识别训练时见过的模型输出,那么每次新模型发布都可能意味着一次检测能力的重置。更灵活的训练方法如果能降低这种重置成本,检测器的实用寿命就会显著延长。
需要说明的是,原文并未披露该方法的具体技术细节、数据集或性能指标,因此无法量化其提升幅度。从研究定位看,它更像是一个方法论层面的改进方向,而非某个具体检测产品的评测报告。
AI文本伪装(也称改写攻击)指对机器生成文本进行人工或自动改写,使其统计特征更接近人类写作,从而绕过检测。常见手段包括同义词替换、句式重组、插入口语化表达、调整标点与段落结构,以及使用改写模型进行“人类化”润色。这类攻击直接针对检测器依赖的表面特征,属于对抗性规避。检测器若只学习固定特征,改写后特征分布偏移,误判率会显著上升。防御思路包括训练时引入改写样本做数据增强、学习对改写不敏感的语义级特征,以及采用集成多检测器的策略。文章强调“伪装文本”场景,正是把对抗性规避纳入了稳健性考量。
稳健性仍是长期课题
AI文本检测本质上是一场持续的攻防。生成模型在提升文本的自然度和多样性,伪装手段在降低机器痕迹,检测器则需要在变化中维持判别力。灵活训练是应对这种动态环境的一个合理思路,但它能否在真实对抗中稳定奏效,还需要更多独立验证。
对关注AI应用与内容治理的读者来说,这项研究传递的信号很明确:检测器的价值不取决于它在某个基准上的分数,而取决于它在条件变化时还剩多少判断力。
相关推荐
免费解锁Claude全模型?开发者模式+网关配置教程
YouTube教程声称通过Claude桌面端开发者模式配置第三方网关,可免费使用Opus 5.5等全模型。本文拆解操作步骤,分析网关模式的技术原理,并揭示账号封禁、数据隐私、服务稳定性三重风险,以及模型命名的真实性问题。
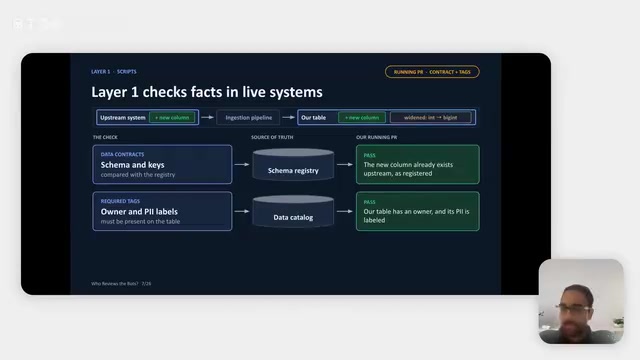
Robinhood混合AI审查器:60%数据PR自动合并
Robinhood数据平台团队分享混合AI PR审查器实战:确定性脚本验证事实、AI Agent判断上下文风险、人类保留关键决策。约60%数据管道PR无需人工审查即合并,人工审查工作量降低约75%,每月节省约132工程小时,相关事故下降约30%。
用Claude Code做营销视频,比AI生成视频更高效
用Claude Code以编程方式生成营销视频,比AI视频生成器更灵活、成本更低。参考视频风格、生成故事板、代码输出内容,修改只需瞬间完成,适合需要频繁迭代的营销场景。