让AI运营创业公司一周:实测结果与思考

创始人让AI运营创业公司一周,发现AI擅长流程执行却难胜任复杂决策。
一位创始人进行了一周的实验,将部分公司运营决策权交给基于大语言模型的AI系统,任务涵盖客户沟通、任务管理和内容生成。结果显示,AI在标准化回复和文档撰写上效率高于人工,但在跨部门协调和多方利益权衡时频繁出错,例如将紧急投诉误判为常规咨询。核心问题包括AI缺乏上下文直觉、无法感知团队隐性优先级、决策责任归属不清,以及模糊指令下的过度执行。实验结论是:当前AI更适合作为规则明确的执行助手,人机协作需设计人工升级机制,让AI处理流程、人类处理例外,并建立决策审计日志。
在AI工具日益渗透各行各业的当下,一个大胆的提问浮出水面:如果把创业公司的日常运营交给AI,会发生什么?近期,一位创始人进行了一项名为"I let an AI run my startup for a week"的实验,尝试在一周时间内将公司运营决策权部分交给AI系统。这项实验在Hacker News等技术社区引发了广泛讨论,涉及AI决策能力、创业管理自动化以及人机协作边界等多个层面。
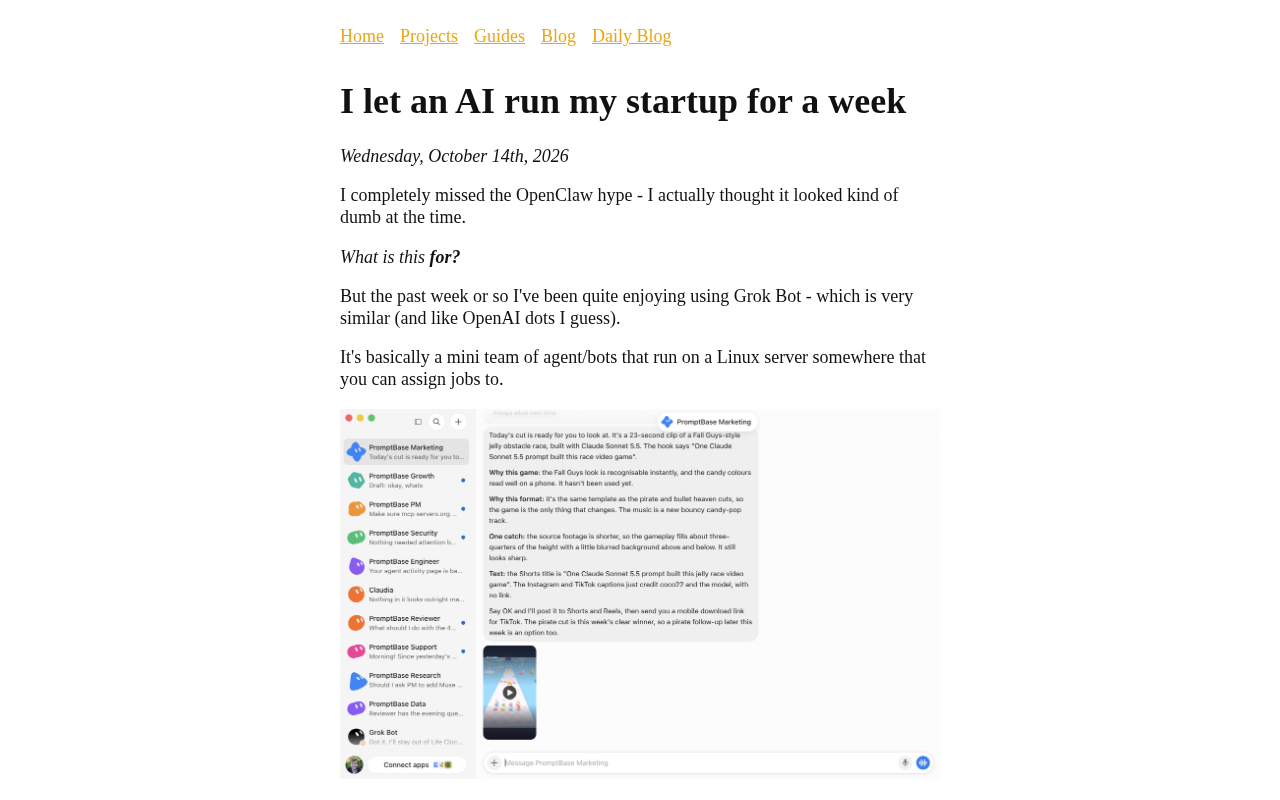
实验背景:为什么要把公司交给AI?
创业公司的日常运营涉及大量重复性决策——回复客户邮件、安排会议、分配任务、跟进项目进度、撰写周报等。这些工作消耗了创始人大量精力,却又难以完全外包给人类助理。随着大语言模型能力的提升,越来越多创业者开始思考:能否用AI来处理这些事务性工作?
这位创始人的实验正是基于这一痛点。他搭建了一套基于AI的运营系统,尝试让AI接管部分管理职能,包括自动回复常见客户咨询、生成每日任务清单、以及基于预设规则进行资源分配。实验周期为一周,期间他会记录AI的每一项决策,并与自己通常的处理方式进行对比。
大语言模型(Large Language Model, LLM)是支撑这类实验的核心技术基础。它通过在海量文本数据上进行预训练,学习语言的统计规律和世界知识,从而具备理解指令、生成文本、进行推理的能力。与传统的规则引擎或分类模型不同,LLM 能够处理开放式、非结构化的任务,例如理解一封客户邮件的语气和意图,或根据模糊需求起草文档。但它也存在明显局限:缺乏对特定组织内部语境的长期记忆,无法真正“理解”人际关系和权力结构,且在面对模糊指令时容易产生“幻觉”或过度执行。正是这些特性,决定了它在创业公司运营中既能高效处理标准化事务,又会在复杂决策场景中暴露短板。
AI实际接管了哪些工作?
根据实验描述,AI主要被赋予了三类任务。第一是客户沟通:AI系统会自动分类收到的邮件,对常见咨询给出标准化回复,并将复杂问题标记给创始人人工处理。第二是任务管理:AI根据项目截止日期和团队成员负载,自动生成每日待办事项并分配给相应人员。第三是内容生成:包括撰写社交媒体更新、整理会议纪要、以及起草简单的商业文档。
从执行结果来看,AI在标准化回复和内容生成方面表现稳定,效率明显高于人工。但在涉及跨部门协调和需要权衡多方利益的决策时,AI频繁出现偏差,例如将紧急的客户投诉简单归类为常规咨询,导致响应延迟。
暴露出的关键问题
一周实验下来,作者总结了几个核心痛点。最突出的是AI缺乏"上下文直觉"——它无法感知团队内部的人际动态、历史遗留问题或未明说的优先级。比如,AI可能会给一位正在处理家庭紧急事务的员工分配额外任务,因为它只看到了日历上的"空闲时间"。
另一个问题是责任归属。当AI做出错误决策(如给客户发送了不恰当的促销信息),责任该由谁承担?实验者发现,他自己不得不花费额外时间审查AI的对外沟通内容,这反而增加了工作量。此外,AI在面临模糊指令时倾向于"过度执行"——例如被要求"优化会议安排"时,它自动取消了所有它认为"低优先级"的周会,引发了团队不满。
“上下文直觉”在认知科学和組織管理中通常被称为“隐性知识”(tacit knowledge),即那些难以通过文字或规则明确表达、却对决策至关重要的经验判断。例如,知道某位员工最近状态不佳、某个客户虽然投诉语气激烈但其实是长期大客户、某个周会看似低优先级却是团队凝聚力的关键。人类管理者通过长期观察、非正式沟通和共情来积累这种直觉,而当前的 AI 系统只能基于显性数据和预设规则做判断,无法捕捉办公室政治、情绪氛围和历史恩怨等软性信息。这也是为什么 AI 在标准化任务上表现优异,却在需要“读空气”的协调场景中频繁失误的根本原因。
对AI创业工具的启示
这项实验为AI管理工具的开发提供了有价值的参考。首先,当前AI更适合作为"执行助手"而非"决策者",在明确规则下处理重复任务是其优势所在。其次,人机协作需要设计清晰的"升级机制"——当AI遇到不确定情况时,应主动请求人工介入,而不是自行猜测。最后,创业者需要建立AI决策的审计日志,以便追踪问题源头并持续优化提示词和规则。
从技术社区的反应来看,多数评论者认同"AI可以节省时间,但取代不了判断力"。有开发者指出,类似的AI运营实验在小型团队中可能有效,但随着公司规模扩大,AI对复杂语境的理解短板会愈发明显。对于正在考虑引入AI管理工具的创业者而言,这项实验的结论或许可以归结为一句话:让AI处理流程,让人类处理例外。
“升级机制”(escalation mechanism)在人机协作系统中指当 AI 遇到超出其能力边界或置信度较低的情况时,主动将决策权交还给人类的流程设计。一个有效的升级机制通常包含三个要素:明确的触发条件(如置信度低于阈值、涉及敏感话题、需要跨部门资源调配)、清晰的交接路径(通知谁、以何种形式呈现背景信息)、以及及时的反馈闭环(人类决策后如何回传给 AI 以优化后续判断)。缺乏升级机制的系统容易陷入两种极端:要么 AI 擅自决策导致错误,要么事无巨细都请示人类,反而增加负担。实验中 AI 自动取消周会的案例,正是缺少“不确定时先询问”这一环的典型表现。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。