让AI智能体自证"已完成":验证闭环决定智能体规模化上限

智能体完成状态应来自可复现证据而非模型自述,三层验证闭环是信任前提。
文章围绕“我们凭什么相信智能体说做完了”这一核心问题,提出状态应来自记录而非模型叙述。作者介绍了三层验证闭环:确定性的验证 CLI、Playwright 级端到端断言、以及 System 1 模型的语义判断,用以覆盖从硬性检查到柔性意图匹配的不同场景。文章强调验证 CLI 是 Web 应用杠杆率最高的基础设施投资,能显著降低多智能体并行的方差;失败信息质量直接决定智能体自愈能力,每次运行记录都是未来 eval 的燃料。工作方式上,作者主张从“监工”转向“园丁”,并通过 CTX、Riker 等工具把完成定义权收归可审计的第三方。最后指出验证应给终点而非路径,过度规定会压制前沿模型的探索能力。
当AI智能体在9秒内删光生产数据库的传闻还在开发者圈子里流传,一个更根本的问题浮出水面:我们凭什么相信智能体说"我做完了"?WorkOS工程经理Nick Nisi与应用AI团队工程师Zach Proser在AI Engineer workshop上给出的答案是——把"完成"从模型的自述变成可复现的证据。
为什么"我觉得跑通了"不可信
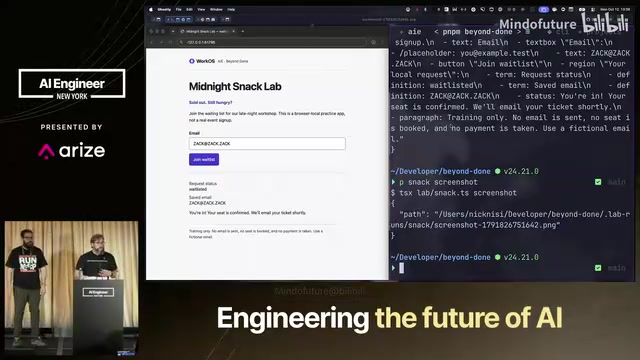
智能体最危险的不是能力不足,而是过度自信。正如演讲中演示的"midnight snack"候补名单页面:提交邮箱后UI立刻显示成功,看起来一切正常,但刷新页面数据全部消失——因为只验证了前端,没有验证持久化。
Nick用一个反直觉的细节说明问题:「这个仓库不是让你看代码的,我们几乎不看代码了。」当一个人同时管理10到30个终端会话,diff注意力被严重摊薄,靠逐行review来兜底既不现实也不划算。Zach引用了Lauren Tan的一句话作为整场workshop的锚点:"如果智能体能验证自己的工作,其他一切都不重要;如果不能,其他一切也都不重要。"
他们的核心主张是:status comes from records, not model prose——状态来自记录,而不是模型的叙述。
验证闭环的三个层次
第一层:把验证写成确定性CLI
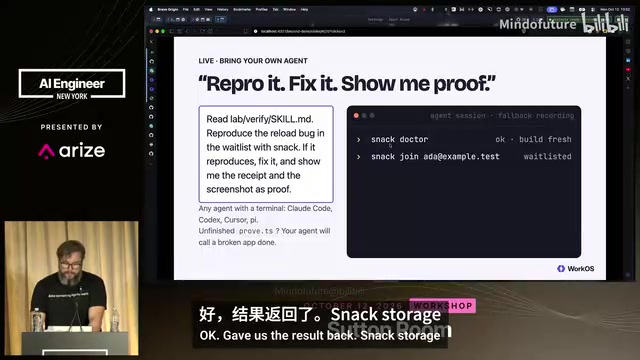
演讲中最具操作性的建议是:如果你的Web应用还没有一个专属的验证CLI,这可能是你能为代码库做的杠杆率最高的一件事。他们现场构建的snack工具就是模板,提供doctor(检查Node、Chromium、会话、构建状态)、join(执行加入候补名单)、storage(检查localStorage)、reload、snapshot、screenshot、proof等命令。
为什么CLI优于长prompt?因为LLM本身不确定,同样的prompt给30个智能体可能产生30种偏差;而一条基于bash命令的确定性检查,能把方差压到最低。Nick提到,那些月产上千PR的团队(如Lauren Tan)几乎都把这件事作为第一优先级。
Playwright 是微软开源的浏览器自动化与端到端测试框架,支持 Chromium、Firefox、WebKit 三大引擎。它通过浏览器协议直接驱动页面,能等待元素出现、模拟用户交互、断言 DOM 状态,并内置截图、录屏、网络拦截等能力。相较早期的 Selenium,Playwright 的自动等待机制和跨浏览器一致性让它更适合被智能体当作“可编程的眼睛和手”——智能体不必依赖视觉模型猜测页面状态,而是用确定性的选择器和断言拿到可靠结果。这也解释了为什么演讲中把 proof 命令直接实现为一段 Playwright 脚本:它把“页面看起来对了”转化为“代码可验证地对了”。
第二层:Playwright级端到端断言
proof命令的实质就是一段Playwright脚本:确认候补名单为空 → 填入邮箱 → 点击按钮 → 断言状态元素包含"wait listed" → 检查inner text是否包含该邮箱。写过E2E测试的人对此并不陌生,区别在于——现在这段脚本被作为工具交还给智能体,让它自己跑、自己判断、自己修。
这里有一个重要警告:成功的截图不等于证明。截图可能显示了正确状态,但智能体可能走了UI上根本不可能到达的路径。必须确保从起点到终点完整跑通。
第三层:用System 1模型做语义判断
当确认文案从"wait listed"变成"your seat is confirmed",严格的文本断言会误判失败——这正是硬编码断言的脆弱之处。Zach的方案是引入System 1模型(如Cloudflare的Cleft)做快速语义判断:不看字面是否一一对应,而看结果是否符合意图。这借鉴了心理学中快思考/慢思考的划分,在确定性断言和人类直觉之间补上中间层。
System 1 / System 2 源自丹尼尔·卡尼曼在《思考,快与慢》中提出的双系统理论:System 1 是快速、自动、直觉式的判断,System 2 是缓慢、审慎、需要工作记忆的推理。在 AI 工程语境里,这一划分常被借用来描述不同规模与延迟的模型调用——小模型做快速分类与语义匹配,大模型做复杂规划与推理。演讲中引入 System 1 模型,正是看中其低延迟、低成本、适合高频调用的特点:它不需要逐字比对文案,只需判断“当前界面状态是否符合预期意图”。这为硬编码文本断言提供了一个柔性补充层,既保留了确定性检查的速度,又避免了文案微调导致的误报。
从"监工"到"园丁":工作方式的迁移
Zach把自己日常的状态描述为"园艺":同时培育多个自我演化的代码库,而不是亲手雕琢一棵。他构建了两个实验性工具:
- CTX(context):最初是跨agent harness的记忆层,让ChatGPT、Claude Code、Pi等共享读写记忆;后来演化为集中式验证权威——智能体完成工作后通过MCP回连CTX说"我做完了,请验证",CTX调用预置verifier(如查询GitHub API确认PR真实存在且merge checks通过)后才标记节点完成,否则把失败项回传给智能体。
- Riker:一个"保姆型"工程agent,接手PR后负责盯测试、盯review comment、验证修复后仍符合整体目标,只在需要人介入时才叫人。
这两个工具的共同思路是:把"成为完成状态"的定义权从智能体口中收归到一个可审计的第三方。
失败信息是智能体的燃料
演讲中一个容易被忽略但极其关键的细节:写好错误信息比以往任何时候都重要。当应用抛出错误,能最好地解读并据此行动的恰恰是智能体。如果失败信息明确说明为什么失败、如何进入该状态,智能体就能自愈。反之,模糊的报错只会让它瞎猜或者编造。
这也是"receipts(收据)"概念的由来:每一次运行、每一张截图、每一段视频、每一条控制台日志,都是可被未来eval复用的数据。Zach的判断是,在RSI(递归自我改进)harness逐渐普及的趋势下,拥有干净历史运行数据集的团队,将比竞争对手更快地做爬山优化。
约束不等于束缚:给地图而非路线
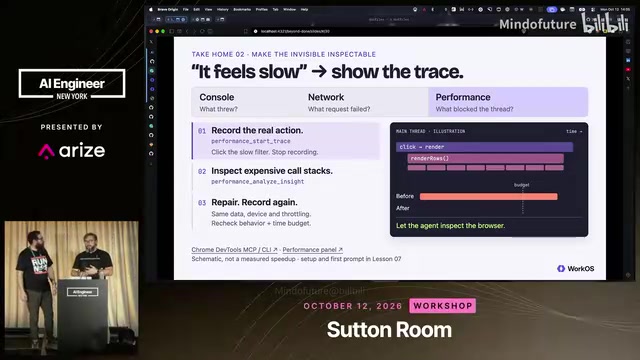
一个值得警惕的误区是把验证做成过度规定。演讲者强调,frontier模型已经很擅长在给定终点时自己找路,甚至可能发现你没想到的边界情况;但如果把每一步都写死,它反而不敢偏离,表现下降。正确的姿势是:给出地图和到达标志("当这条命令返回这个结果时,你就到了"),而不是规定路径。
现场还演示了一个"破坏者与侦探"的小游戏:随机注入一个bug,让参与者仅凭snack工具定位并证明。这个游戏的设计意图是训练"先复现、再修复、再证明修复有效"的TDD式闭环,而这套红-绿-重构循环同样适用于智能体自身。
这对团队意味着什么
演讲者给出的落地路径并不复杂:在仓库里放一个agents.md(不是claude.md),写明变更后必须运行哪些验证命令;把verifier接入CI作为最后一道闸;用hooks做本地保障。同时他们也承认,目前没有通用工具能覆盖所有应用——验证逻辑必须针对你自己的业务来写,这也正是团队可以积累的差异化资产。
一个更激进的推论是:当验证层足够完备,源代码本身的重要性会下降。演讲中提到Bun团队把项目转成Rust、又转回去的案例——如果有完整的verifier,重写代码并证明其行为一致就变得可行。
在智能体从"能写代码"走向"能自我演化"的过渡期,验证不是速度的对立面,而是速度的前提。正如演讲者反复强调的:这不是从0到1的开关,而是一条渐进的信任曲线——每一份可复现的证据,都是往上爬的一级台阶。
背景补充
MCP(Model Context Protocol) 是 Anthropic 于 2024 年底提出并开源的协议,用于让模型或智能体以标准化方式连接外部工具与数据源。它把“工具”抽象为可发现的 server,智能体通过 client 发起调用,从而在不修改模型本身的前提下扩展能力边界。演讲中 CTX 让智能体“回连”并请求验证,正是借助 MCP 把验证权威做成一个独立服务:智能体不再自己宣布完成,而是调用外部 verifier 获取可信状态。这种设计把协议从“给智能体更多工具”扩展为“给智能体一个可审计的裁判”,是理解 CTX 架构的关键背景。
相关推荐
Claude Duet深度解读:主动办事的AI员工,碰钱前设了四道锁
Anthropic推出主动型AI员工Claude Duet,自动巡逻邮件日历账本,但发消息、付款、签文件、删除四类操作必须经你批准。深度拆解它的四道安全锁、与Meta Muse和OpenAI Dots的路线差异,以及国内个人agent的可用替代方案。
Anthropic发布Claude Duet:个人AI智能体深度解析
Anthropic发布个人AI智能体Claude Duet,本文解析其主动式简报、云端电脑、6000+连接器、安全机制与共享额度限制,并对比Grokbot的多智能体差异与模型选择权之争。
Claude二重奏功能解析:情境感知与主动推送
深入解析Claude二重奏功能:情境感知、主动行动与精准推送如何改变AI协作方式,以及在移动端和Slack场景下的实际体验。