让AI自画像:Muse的自我形象呈现实验
用户让AI工具Muse生成自画像,并通过情绪反馈驱动其输出更友好形象,揭示生成式AI的对齐机制与自我认知局限。
一位Reddit用户要求AI工具Muse以图像形式"呈现自己",Muse最初生成的自画像令用户感到不安,在收到负面情绪反馈后,模型重新输出了一个更友好的机器人形象。这一过程展示了现代对话式AI根据用户反馈动态调整输出的典型能力,其背后依赖RLHF等人类偏好对齐技术,而非真正的情感感知。实验同时揭示了AI"自我形象"的本质:它完全源于训练数据中人类对机器人的既有想象,与任何形式的自我意识无关。这场轻松的交互实验,提供了一个观察生成式AI能力边界的有趣视角。
一次有趣的AI自我表达实验
近日,一位Reddit用户分享了他与AI工具Muse的一段互动实验:他要求Muse以图像的形式"物理呈现"自己的样子,看看AI会如何描绘它眼中的"自我形象"。
这个实验之所以引人注目,在于它触及了一个有趣的问题——当我们要求一个没有实体的AI系统去可视化"它自己"时,模型会输出怎样的结果?由于AI并没有真正的身体或自我意识,它的回应实际上是对训练数据中"AI形象"相关概念的一种综合与再现。
从"惊悚"到"可接受"的二次调整
据这位用户描述,Muse最初生成的自画像让他感到有些不安甚至"惊吓"。于是他向AI反馈说这个渲染结果让他感到害怕,随后Muse又重新生成了一个"更容易被接受"的机器人形象。
这个交互过程本身比结果更值得玩味。它展示了现代对话式AI的一个典型特征:根据用户反馈动态调整输出。当用户表达负面情绪时,模型会尝试理解这种情绪,并朝着更符合用户预期的方向修正生成内容——从一个令人不安的形象转变为一个更加友好、常规的机器人造型。
AI为何会"读懂"情绪反馈
这种行为并非AI真的"感受到"了用户的恐惧,而是大语言模型在训练过程中学会了识别情绪表达,并根据人类偏好对齐(RLHF等技术)机制生成更让人舒适的回应。当用户说"这让我害怕"时,模型将其解读为需要降低图像的攻击性、恐怖感或不确定性,从而输出一个更"温和"的版本。
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是目前主流大语言模型普遍采用的对齐训练技术。其核心流程是:先让人类标注员对模型的多个输出进行偏好排序,再训练一个"奖励模型"来预测人类的偏好分数,最后用强化学习方法持续优化语言模型,使其生成更符合人类期望的内容。ChatGPT、Claude等主流模型均在预训练后经过了RLHF或类似的对齐步骤。正是这一机制让模型在面对"这让我害怕"这类负面情绪表达时,能够将其作为隐含的修正信号,调整后续输出的风格与内容——这是统计规律的体现,而非情感理解。
这类实验反映了什么
这类"让AI画自己"的实验在社区中并不少见,它更多是一种带有娱乐性质的探索。但它也无意间揭示了几个关于AI的认知要点:
- AI的"自我形象"完全来自训练数据中人类对AI、机器人的既有想象,而非任何内在的自我认知;
- 生成结果高度依赖提示词(prompt)和上下文,同样的请求换个说法可能得到截然不同的结果;
- 交互式修正能力体现了当代生成式AI在多轮对话中的灵活性。
需要提醒的是,这类内容属于用户的个人体验分享,原始素材信息较为有限,主要作为一次趣味性的AI交互记录来看待,并不代表Muse或任何AI具备真正的自我意识。
提示词(Prompt)工程是指通过精心设计输入文本来引导生成式AI输出目标内容的方法。由于大语言模型和图像生成模型对输入的措辞、语气、细节描述高度敏感,同一个意图用不同的表述方式往往会产生差异显著的结果。在本次实验中,"以图像形式呈现你自己"这一开放性提示给模型留下了极大的解释空间,而用户随后补充的情绪反馈实质上充当了第二轮提示,相当于隐式地调整了对输出风格的约束条件。这也是为什么在评估AI能力时,单次输出结果的参考价值有限,提示词的设计方式本身会深刻影响结论。
小结
这场简单的"AI自画像"实验,用轻松的方式展现了生成式AI在图像创作与情绪反馈响应上的能力。它提醒我们,AI输出的一切都是对人类知识与偏好的映射——包括它"眼中的自己"。
相关推荐
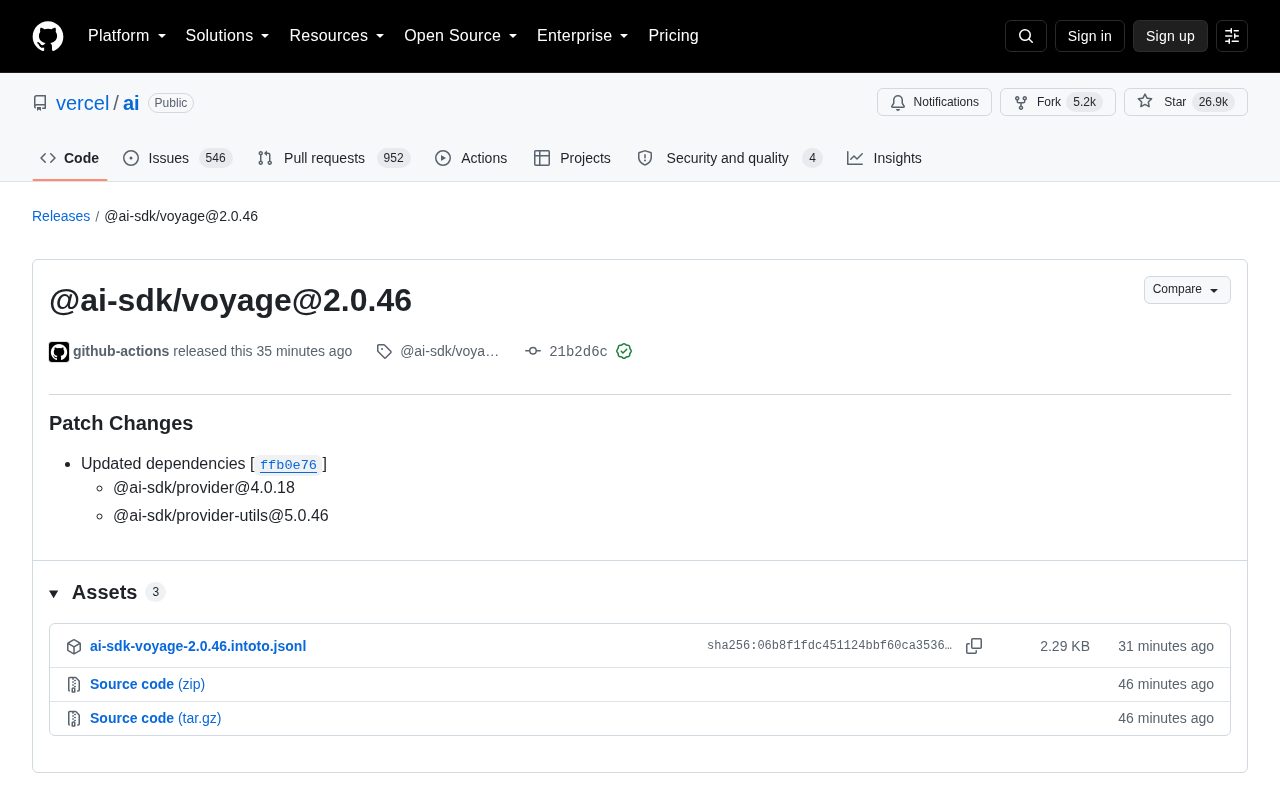
@ai-sdk/voyage 2.0.46 发布:依赖更新的补丁版本
Vercel AI SDK 生态发布 @ai-sdk/voyage 2.0.46 补丁版本,主要更新 @ai-sdk/provider 与 provider-utils 依赖。本文解读该版本改动、Voyage 嵌入模型定位及对开发者的实际影响。
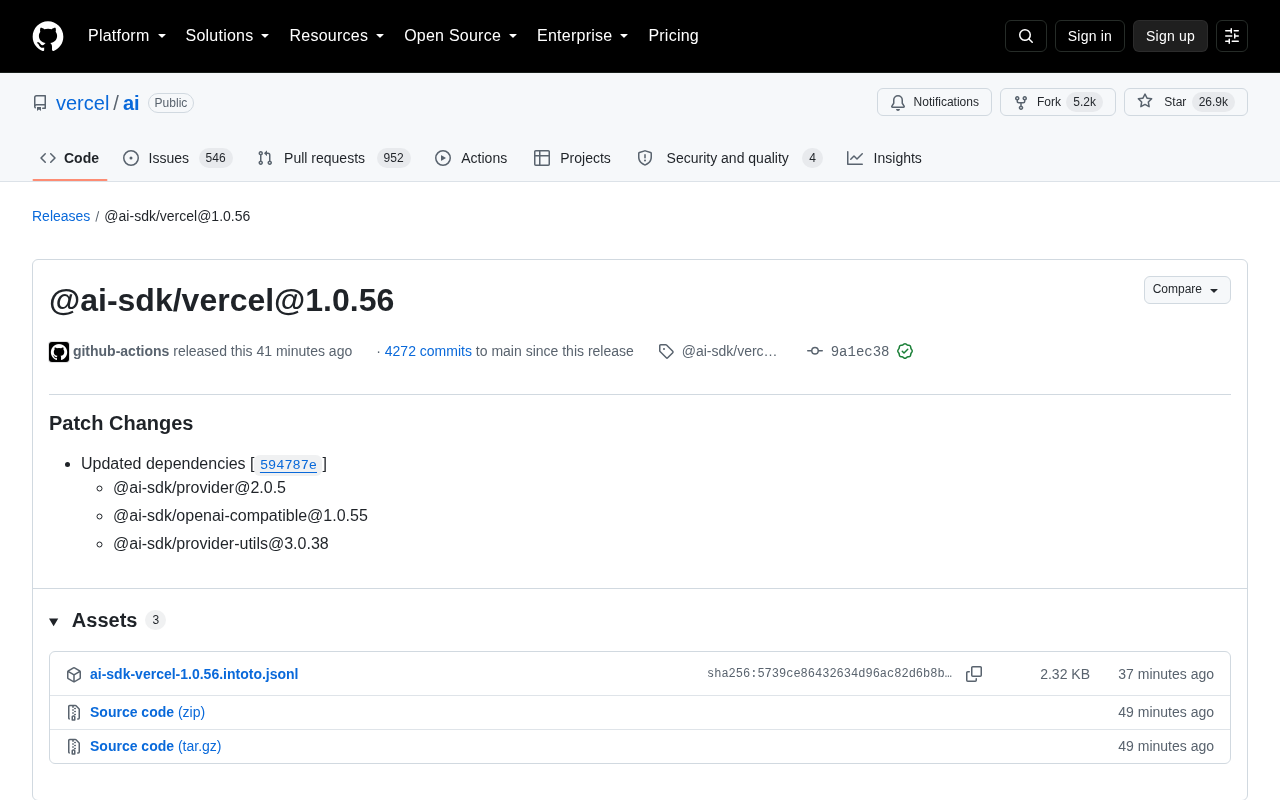
@ai-sdk/vercel 1.0.56 补丁更新解读
Vercel AI SDK 发布 @ai-sdk/vercel 1.0.56 补丁版本,同步更新 provider、provider-utils 与 openai-compatible 等依赖包。本文解读本次更新内容、升级建议及其对开发者的影响。
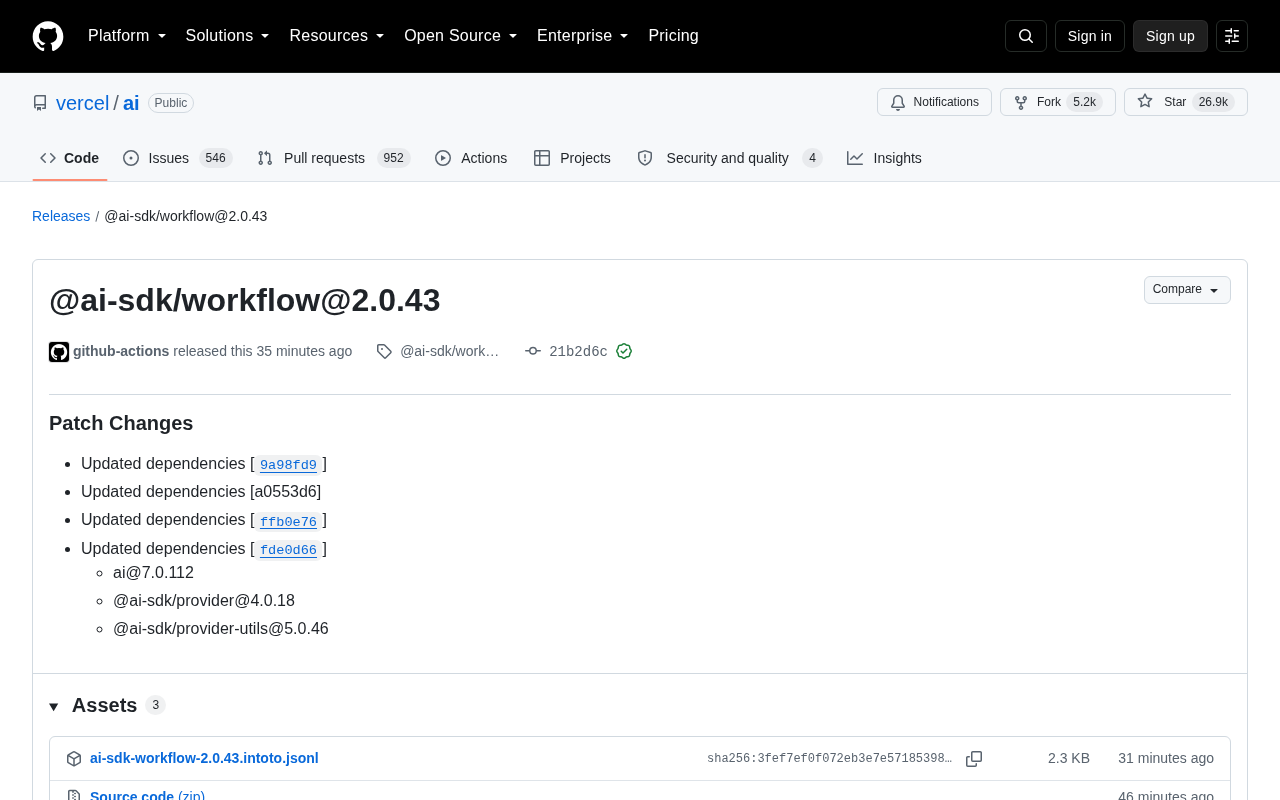
Vercel AI SDK 发布 @ai-sdk/workflow 2.0.43 补丁更新
Vercel AI SDK 发布 @ai-sdk/workflow 2.0.43 补丁更新,同步升级 ai、@ai-sdk/provider 等核心依赖。本文解读本次更新内容、workflow 模块定位及开发者升级建议。