让AI自己开发AI工具:7天31次提交的自举踩坑实录
工程师用AI全自动开发AI工具,7天31次提交,每个失败都固化成永久免疫闸门。
一位工程师搭建了一条全自动AI开发流水线,让AI每天自选题、自立案、自写代码,并通过51步回归门禁验证,全程无人值守。整个系统运行7天,完成31个commit,自举成功率仅六分之一。但作者认为"赚翻了",因为踩过的60多个坑最终收敛成11条结构性规律,并全部转化为自动化检查,使回归门禁从51步扩展到74步。五类典型失败包括:脏工作区导致自我锁死、测量机制本身带崩系统、无界反馈撑爆命令行、AI陷入无限重试、以及测试断言凭空脑补。三条最核心的规律是:测量失败不等于零进度、判断与证明必须分离、每条指令必须可验证。AI审AI机制用三个对抗式Subagent核对了120个可验证声称,抓出9处口径错误,证明这套自我质检机制确实有效。
让一套AI去开发另一套AI工具,全程无人值守——这听起来像科幻,但一位工程师真把它跑了起来。7天时间,31个commit,自举成功率只有六分之一。这个数字看着惨淡,但作者的结论却是"赚翻了"。原因藏在失败的处理方式里:飞轮踩过的每一个坑,都变成了它自己永久性的免疫记录。
什么是"AI开发AI"的自举飞轮
作者搭建的是一条全自动开发流水线:每天早上7点半,系统自己选题、自己立案、自己写代码,然后跑完51步回归门禁,全程无人接手。只有门禁全部通过才算完成任务。而开发这套流水线的,是另一套AI。用AI去开发AI工具,这就是所谓的"自举"(bootstrapping)。
概念很美,坑全在细节里。第一天早上7点半飞轮启动就直接被拒绝——拒绝它的不是黑客也不是权限问题,而是它自己头天晚上写脏的Git工作区。整整7天下来,作者踩了60多个坑,最后收敛成11条结构性规律。
「自举」(bootstrapping)一词来源于编译器领域:用一门语言的旧版本编译器去编译该语言的新版本编译器,从而让语言"拉着自己的靴带离地"。在AI工程语境里,自举指的是用一套AI系统来构建、测试或改进另一套AI系统,从而减少人类在开发循环中的直接干预。回归门禁(regression gate)则是持续集成中的一道强制关卡:只有全部预定测试通过,变更才被允许合入代码库。二者组合起来,相当于给无人值守的AI流水线装上了一套机械式"诚信保证"——AI不能绕过测试向自己说谎。
五类最典型的坑
程序把自己搞死
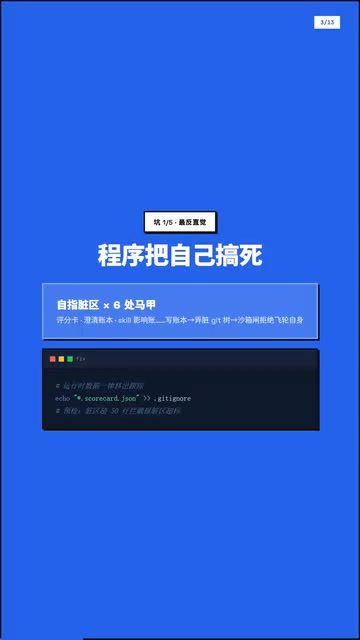
最反直觉的一类:飞轮每天要写运行账本和评分卡,这些文件被Git跟踪着,一写就弄脏工作区。沙箱预检一看工作区不干净,直接拒绝启动。这个坑在7天里换了6个马甲反复出现——评分卡、澄清账本、影响账,本质都是同一根引线。
解法是加一道预检:脏区超过50行就报"脏区超标",运行时数据一律移出Git跟踪。
测量本身把系统带崩
有一天系统"熔断停机",误报了两次。排查后发现工作区里躺着103MB的构建产物。指纹算法用了Git Diff的二进制全文模式,把103MB全量比对,还要逐文件读盘哈希,200多个文件每个窗口重读一遍。修法三刀:指纹改成只列文件名;超过1MB的文件只取大小加首尾各4KB;感测失败不再算成零进度。
无界反馈撑爆命令行
一个检查器输出了510KB的日志,被整段塞进下一轮提示词。在Linux上顶多慢一点,但这是Windows,命令行参数有长度上限,派发直接崩溃,错误码叫"argument too long"。教训很直白:无界反馈是崩溃故障,不是省时间的小事。现在反馈先压缩到2.8KB,再加一道8KB尾截防线,连UTF-8边界都做了回退处理。
AI不会喊停
同一个登录报错连续烧了三个窗口、三个小时都没人拦。根因是失败没有被归一化,跨窗口根本没法比对。
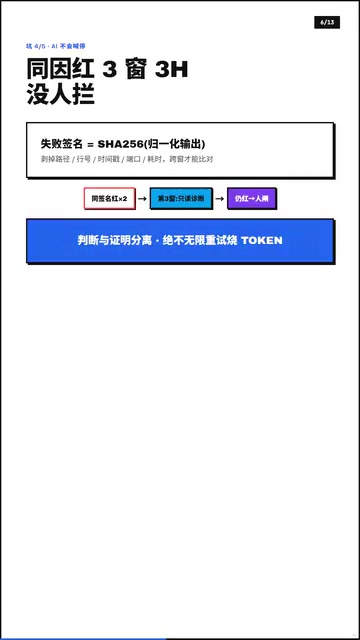
解法是引入断路器:把输出里的路径、行号、时间戳去掉,取256档失败签名。同一签名连续两窗,第三窗不再派写码的AI,改派只读诊断窗专查根因,诊断完仍未解决就升级给人类,绝不无限重试烧token。
断路器(Circuit Breaker)模式借鉴自电气工程:当电路出现过载时,物理断路器会自动断开,防止更大范围的损毁。在软件系统中,Netflix的Hystrix库将这一思想引入微服务容错——当某个下游服务连续失败超过阈值,调用方自动切换到降级逻辑,而不是无休止重试拖垮整条链路。在AI Agent场景里,断路器的意义更为关键:单次LLM调用可能消耗数千token,无界重试不仅烧钱,还会因上下文窗口膨胀导致模型输出质量持续下降,形成负反馈螺旋。文中"同一签名连续两窗就换诊断模式"的做法,正是将断路器阈值从"服务响应码"替换成了"语义失败特征"。
断言全靠脑补
最扎心的一类:AI写的端到端测试四连败,烧掉一个半小时,作者打开页面十分钟全修完。最典型的一个按钮渲染出来文字中间带了空格,AI的正则死活匹配不上。根因是期望值没有现实来源,全靠脑补。方案是断言必须从真实页面渲染里生成,禁用裸中文正则,改用role加name精确匹配。
三条最值钱的结构性规律
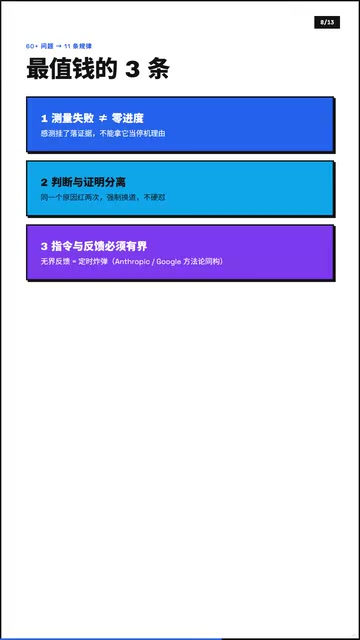
从60多个问题里,作者提炼出11条规律,其中三条最值钱:
- 测量失败不等于零进度:检测挂了要落证据,不能拿它当停机理由。
-
判断和证明必须分离:同一个原因连续红两次,就强制换到诊断模式。
-
每条指令都必须可验证:给AI的每条指令、每份反馈都必须有明确校验,没有校验就等同于埋了颗炸弹。
作者特别指出,这三条在Anthropic和Google的方法论里都有同构的表述,并非孤例。
AI审AI:抓出九处口径错误
有意思的是,这份复盘日记本身也过了一次硬核质检。三个独立的Subagent做对抗式重验,逐一核对120个可验证声称,包括26个Commit Hash和40多处引用行号。结果:零处坐实编造,九处修正——全是行号飘移和口径换算问题。比如原文写"次日自举通过",审计翻记账本直接打脸,实际是连续两天静默失败。AI审AI,确实能抓出AI自己的错。
对抗式多智能体验证(adversarial multi-agent verification)是近年来提升LLM输出可信度的一类方法:让多个独立的子智能体分别扮演"提出者"与"挑战者",通过相互核查来减少单点幻觉。其理论依据在于,不同推理路径产生相同错误的概率远低于单条路径,因此多路并行验证可以显著降低系统性误报。然而这一机制有一个重要边界:它擅长发现可锚定的事实性偏差(如行号、时间戳、哈希值),对于逻辑推理层面的系统性偏见(所有子智能体共享同样的训练偏差时)效果有限。文中"零处坐实编造、九处口径修正"的结果,恰好落在这套机制最有效的适用区间内。
为什么说"赚翻了"
关键在于回归门禁那条曲线:从51步一路涨到74步。多出来的23步,全是这几天踩坑换来的自动化检查——测试密闭性、失败签名、断路器、断言现实、极限保护。
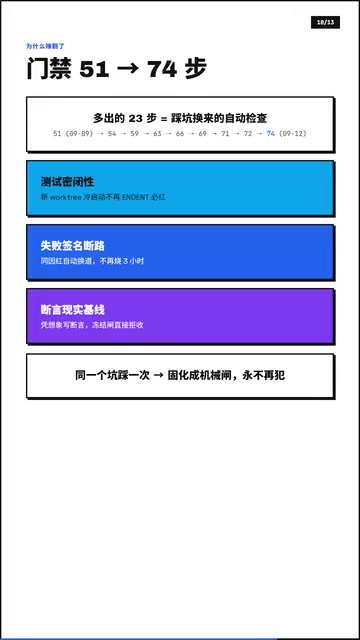
同一个坑踩一次,就固化成机械闸门,飞轮永不再犯。这就是自举飞轮的意义:它犯的每个错,都变成了自己的免疫系统。31个commit,就是31次免疫记录。
作者给出三个当天就能用的动作:第一,把所有运行时账本移出Git跟踪;第二,给自动化加失败签名,同一错误连续出现两次就强制换应对方式;第三,AI写的测试断言,期望值必须来自真实页面渲染,不许凭想象写。三条都不需要新框架,当天生效。
结语:实习生与免疫系统
AI开发到底靠不靠谱?作者的答案很有辩证意味:单独看每一次失败,它笨得像个刚入职的实习生;但拉长到7天看,它把每个错都变成了永久性闸门。人类工程师会重复犯同样的错,而飞轮不会。这或许正是AI自举开发最被低估的价值——不在于单次成功率,而在于失败的可累积性。
相关推荐
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。
全盲创业者靠Claude做出无障碍产品,卖出1700美元
一位全盲创业者用 Claude 为盲人客户打造无障碍产品并卖出 1700 美元。他的经历揭示了 Vibe Coding 的真相:AI 能写代码,但真正的好体验离不开领域知识,也展现了 AI 赋能残障人群自主构建工具的独特价值。
Datamimic:给AI编程助手一个可控的测试数据世界
Datamimic 是一款开源工具,主张不要让AI编程助手自行编造测试数据。本文解析AI生成测试数据的可靠性隐患,以及可控测试数据世界对开发质量的价值。