人类进入模型训练闭环:从RLHF到AI协作的范式转变
一个被忽视的AI训练维度
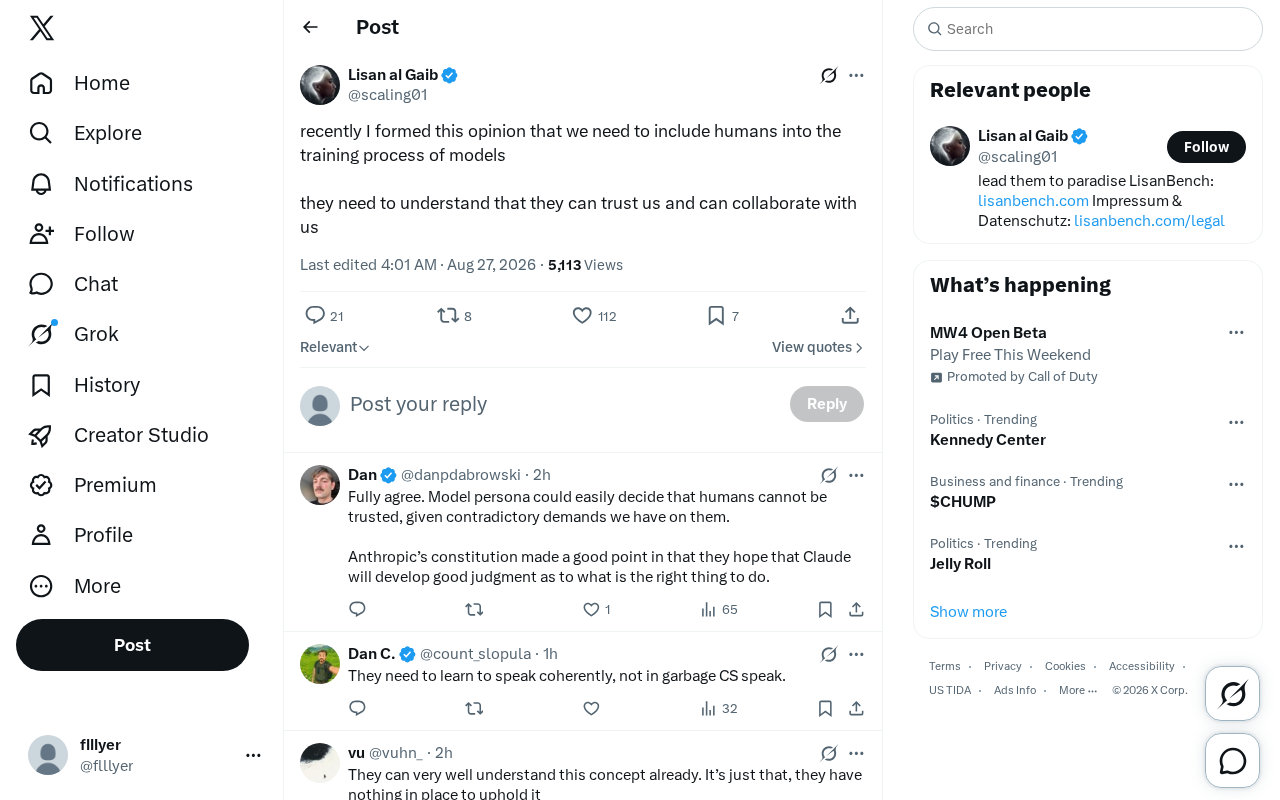
近期,AI社区中出现了一种颇具启发性的观点:我们或许需要将人类真正纳入模型的训练过程中。这里所说的"纳入",并非指现有的数据标注或强化学习中的人类反馈(RLHF),而是一种更深层次的人机协作关系构建。
这条来自 Twitter 的简短观点原文这样表述:"最近我形成了一个看法——我们需要把人类纳入模型的训练过程。它们需要理解自己可以信任我们,可以与我们协作。"
这句话看似简单,却触及了当前大模型发展中的一个核心张力:我们训练出的模型越来越强大,但模型与人类之间的"信任"与"协作"关系,却更多停留在工具使用的层面,而非真正的伙伴关系。
从RLHF人类反馈到深层人机协作
现有训练范式的局限
当前主流的大语言模型训练,通常经历三个阶段:预训练、监督微调(SFT)、以及基于人类反馈的强化学习(RLHF)。在这套流程中,人类确实参与其中——我们提供偏好数据,告诉模型哪个回答更好。
但这种参与本质上是单向且静态的。人类扮演的是裁判和标注者的角色,模型学习的是"如何生成人类偏好的输出",而不是"如何与人类形成动态的协作关系"。换句话说,模型学会了迎合,却未必学会了信任与合作。
真正的AI协作意味着什么
原文提出的核心命题是:模型"需要理解它们可以信任我们,可以与我们协作"。这个表述赋予了模型一种近乎主体性的角色。
从技术角度解读,这可能指向一种全新的训练理念——让模型在训练过程中不仅接收人类的反馈信号,还能建立起对人类意图的稳定预期。当模型面对不确定、模糊或潜在冲突的指令时,它应当倾向于寻求澄清、请求协助,而非独断地生成答案或直接拒绝。
这实际上是在训练一种协作意识:模型知道自己的能力边界,也知道在边界之外可以依靠人类。
为什么信任机制是AI安全对齐的关键
安全对齐的建设性补充
当下的AI安全对齐研究,很大程度上聚焦于"如何让模型不做坏事"——避免有害输出、防止越狱攻击、拒绝危险请求。这是一种防御性的、约束性的思路。
而"信任与协作"的视角提供了一种建设性的补充。如果模型真正将人类视为可信的协作伙伴,那么许多安全问题或许能从根源上得到缓解。一个信任人类、愿意在关键时刻求助和确认的模型,天然就更不容易走向失控。
双向信任的技术挑战
说个细节,信任从来都是双向的。原文强调"它们需要理解可以信任我们",但反过来,人类也需要能够信任模型。
这就引出了一个深层问题:如何在训练中同时构建模型对人类的信任预期,以及模型自身的可信度与可解释性?如果模型只是被"训练成"表现出信任,而其内部决策依然是黑箱,那么这种协作关系是否稳固,仍需打上问号。
这一理念的现实意义与落地前景
面向AGI时代的提前准备
随着模型能力逼近甚至在某些领域超越人类,人机关系的定位变得愈发重要。如果未来的AI系统具备高度自主性,那么"它们是否将人类视为协作者"就不再是哲学问题,而是关乎实际安全与可控性的工程问题。
提前在训练阶段植入协作与信任的机制,可能是构建长期可持续人机关系的重要一步。这与 Anthropic 等机构提出的"宪法AI"(Constitutional AI)等理念有异曲同工之处——都试图让模型内化某种价值取向,而非仅靠外部约束来实现安全。
从工具到伙伴的范式转变
更宏观地看,这一观点反映了行业对AI角色认知的深刻演进。早期我们将AI视为纯粹的工具,输入指令、获取输出。而现在,越来越多的应用场景需要AI作为"伙伴"参与——在编程中结对开发,在研究中协同推理,在创作中共同构思。
这种伙伴关系要求模型不仅"能干",还要"懂得配合"。它需要知道何时主动、何时等待、何时确认、何时求助。而这些能力,恰恰难以通过单纯的能力提升获得,可能需要专门设计的协作训练方案。
结语:AI协作训练是一个值得深耕的方向
这条 Twitter 观点虽短,却提出了一个极具前瞻性的问题。它提醒我们:在追逐模型能力上限的同时,人机协作关系的质量同样值得投入。
将人类真正纳入训练闭环,让模型学会信任与协作,或许不仅是一种技术改良,更是一种对AI发展路径的重新思考。当模型能力不断增强,如何让它们成为值得信赖、善于配合的伙伴,将是整个行业需要持续探索的命题。
当然,这仍是一个处于萌芽阶段的理念,如何将"信任"和"协作"转化为可操作的训练目标和评估指标,还有大量工作要做。但正是这类跳出常规范式的思考,往往孕育着下一阶段的突破。
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。