让语音大模型学会呼吸:非语言发声建模新进展

研究系统建模13类非语言发声,通过数据合成与NVV感知GRPO提升语音大模型对话自然度。
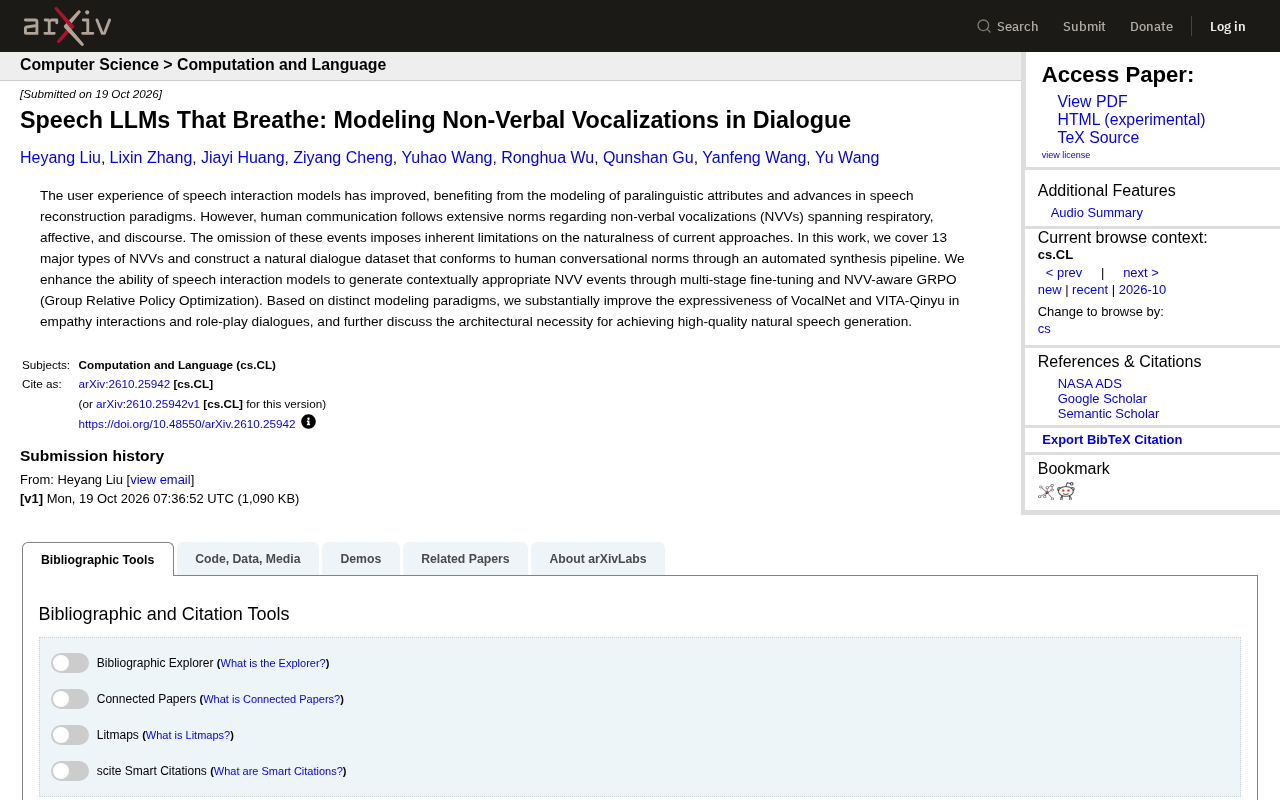
该研究针对语音大模型忽略非语言发声(NVVs)的问题,系统覆盖了13类NVVs(呼吸、叹息、笑声、停顿等),并指出现有模型因忽略这些事件而存在自然度局限。团队通过自动化合成流水线构建了符合人类对话规范的数据集,采用多阶段微调和NVV-aware GRPO强化学习优化,使模型能在上下文中生成恰当的NVVs。在VocalNet和VITA-Qinyu两个不同架构的模型上验证,显著提升了共情交互和角色扮演对话的表现力。研究还讨论了架构选择对自然度上限的影响,为副语言能力注入提供了可复用的技术框架。
语音交互的体验正在快速提升,这得益于副语言属性建模和语音重建范式的进步。但人类对话中那些看似微不足道的非语言发声——呼吸、叹息、笑声、停顿——恰恰是自然感的关键。一篇最新研究系统性地覆盖了13类非语言发声(NVVs),并提出了让语音大模型在对话中适时“呼吸”的方法。
为什么非语言发声如此重要
人类沟通遵循着一套复杂的非语言规范。呼吸的节奏暗示着话轮的切换,一声叹息承载着情绪的重量,笑声则标记着共情的瞬间。这些NVVs横跨呼吸、情感和话语结构三个维度,构成了对话自然度的底层骨架。
当前语音交互模型的根本局限在于:它们能说出正确的词,却漏掉了说话时的“人味”。原文指出,对这些事件的忽略“对当前方法的自然性施加了固有局限”。换句话说,模型可以字正腔圆,却难以让人感到它在真正地“对话”。
13类非语言发声与数据构建
研究覆盖了13种主要NVV类型,这个分类粒度意味着模型需要学习的不是笼统的“语气”,而是具体的发声事件及其在对话中的位置。
为了支撑训练,团队通过自动化合成流水线构建了一个符合人类对话规范的自然对话数据集。这条路径的价值在于可扩展性——人工标注非语言发声成本极高,自动化合成让大规模、多样化的对话场景成为可能,同时保持对话规范的一致性。
自动化合成流水线通常包含多个步骤:首先从大规模对话语料中提取文本和韵律特征,然后利用规则或生成模型在特定位置插入非语言发声标签,最后通过语音合成技术生成带有NVVs的音频。这种方法的优势在于可以大规模生成标注数据,同时控制NVVs的类型、频率和上下文分布,确保数据符合人类对话规范。相比人工录制和标注,合成流水线显著降低了成本,并允许灵活调整数据分布以覆盖多样化的对话场景。
多阶段微调与NVV感知GRPO
方法层面的核心有两点。其一是多阶段微调,让模型逐步获得生成上下文恰当NVV事件的能力,而不是一步到位地强行注入。
其二是NVV-aware GRPO(Group Relative Policy Optimization)。GRPO本身是一种基于分组相对比较的强化学习优化策略,这里的关键改造是让优化目标“感知”非语言发声——也就是说,奖励信号不仅关心说了什么,还关心在何处、以何种方式加入了呼吸或叹息。这种把副语言事件纳入优化回路的做法,是让自然度从“装饰”变成“能力”的关键一步。
GRPO(Group Relative Policy Optimization)是一种强化学习算法,其核心思想是在一组采样输出之间进行相对比较来估计优势函数,而非依赖单独的价值网络。具体而言,对于同一个输入,模型生成多个候选回复,GRPO通过组内归一化计算每个候选的相对优劣,从而更新策略。这种方法降低了训练成本并提升了稳定性。在本文中,NVV-aware GRPO的关键改造在于奖励函数的设计:除了传统的文本质量奖励外,还引入了对非语言发声事件(如呼吸、叹息)的上下文适当性评估,使得优化过程能够引导模型在正确的位置生成正确的副语言事件。
两个模型范式的实证提升
研究基于不同的建模范式进行了验证,显著提升了VocalNet和VITA-Qinyu在共情交互和角色扮演对话中的表现力。
两个模型代表不同的架构路线,这意味着该方法的收益并非绑定于单一实现。在共情交互中,恰当的呼吸和叹息能传递理解与陪伴;在角色扮演中,非语言发声则是角色人格的一部分。原文进一步讨论了实现高质量自然语音生成的架构必要性——这暗示并非所有架构都能同等受益于NVV建模,架构选择本身会影响自然度的天花板。
VocalNet和VITA-Qinyu代表了两种不同的语音大模型架构范式。VocalNet可能采用端到端的语音到语音生成方式,而VITA-Qinyu可能基于文本到语音的级联或融合架构。不同的架构在处理副语言事件时具有不同的内在能力:例如,端到端模型可能更直接地建模声学细节,而级联模型可能更依赖文本中间表示。因此,NVV建模方法的收益程度会因架构而异,架构选择本身决定了模型能够达到的自然度上限。
对语音交互的启示
这项工作把语音大模型的竞争维度从“说得准”推向“说得像人”。当副语言事件被系统性地建模,语音助手的沉默不再尴尬,虚拟角色的情绪不再单薄。
更值得关注的是方法论上的信号:数据合成流水线、多阶段微调与NVV感知强化学习的组合,构成了一套可复用的副语言能力注入框架。对于关注语音交互自然度的研究者和产品团队,这提供了一个明确的技术参照——自然度不是一个后处理问题,而是需要进入训练目标和架构设计的核心议题。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。