Rasa Mantle实战:为VS Code插件加入AI代理

开发者用 Rasa Mantle 为 VS Code 笔记插件构建本地对话代理,总结工具调用、记忆与 LLM 选型的实践经验。
一位开发者为 VS Code 笔记插件 NoteVs 接入 Rasa 新推出的代理引擎 Mantle,构建了一个完全本地运行的对话式代理,可在聊天面板中查询笔记、设置提醒。文章详细复盘了三大核心能力的实践:用类型化 Python 函数定义工具并通过技能控制工具可见性、用声明式记忆管理会话状态、通过 LiteLLM 在官方未列出的 Groq 平台上运行模型。作者也记录了多窗口项目混淆、会话启动技能吞掉首条消息、Groq 免费层限流等真实问题,并给出显式传参、覆盖启动技能、固定模型版本等修复方案。最终结论是 Mantle 显著简化了代理逻辑,但成败取决于模型选型与提供商限制。
开发者常用 VS Code 记录项目笔记。当笔记数量增多,查找和操作便成为负担。一位开发者为自己开发的笔记插件 NoteVs 引入了 Rasa 新推出的代理引擎 Rasa Mantle,构建了一个对话式代理。现在,他可以直接在代码旁的聊天面板中提问,例如“我在 auth 模块里标注了什么?”或“提醒我明天处理重构笔记”。
这个项目不仅是功能演示,更是一次对 Mantle 三大核心能力的深度实践:工具调用(tool calling)、记忆(memory)和 LLM 层,包括在官方未列出的 Groq 平台上运行。以下是他的经验总结,包含哪些设计有效,以及哪些地方出了问题。
架构概览:本地优先的轻量集成
整个系统完全在本地运行。VS Code 插件持有笔记数据,并在 localhost:37492 上暴露一个轻量 HTTP 端点。代理是一个本地 Rasa 服务器,其工具通过 HTTP 调用该端点。插件的聊天面板则通过 Rasa 的 REST 通道与代理通信。
项目结构清晰:agent.yml 定义人设和全局规则,skills/*/skill.md 存放技能,tools/notevs_tools.py 包含 10 个工具,memory.yml 管理项目记忆,integrations.yml 配置 LLM 和通道。
有意思的是,作者曾用经典 CALM 框架实现相同功能,需要 5 个文件约 590 行 YAML。而 Mantle 版本仅约 210 行,且大部分是自然语言指令。这种简洁性源于 Mantle 对代理逻辑的抽象。
Rasa CALM(Conversational AI with Language Models)是 Rasa 较早推出的对话式代理框架,其核心思路是以 YAML 流程(flows)和自定义动作描述对话逻辑,开发者需要显式定义每个对话步骤、分支和槽位填充规则。相比 Mantle 将技能、工具和记忆抽象为自然语言声明,CALM 更接近传统的状态机式对话设计,因此在实现相同功能时往往需要更多配置文件与样板代码。文中的行数对比(590 行对 210 行)正反映了两种范式在声明密度上的差异:CALM 把大量逻辑写在配置里,而 Mantle 把决策交给模型并辅以工具约束。
REST 通道是 Rasa 服务器对外暴露的 HTTP 接口,允许任何客户端通过 /webhooks/rest/webhook 端点发送用户消息并接收代理回复。在 NoteVs 的场景中,VS Code 聊天面板并不直接调用 Python 工具,而是把用户输入 POST 给本地 Rasa 服务器,由服务器驱动 LLM 完成技能选择与工具调用后再返回文本响应。这种设计让前端与代理逻辑解耦,插件只需实现一个简单的消息收发循环,而代理的复杂度全部收敛在 Rasa 服务内部。
工具调用:类型化函数与技能约束
工具即类型化 Python 函数
在 Mantle 中,工具是带装饰器的异步函数。类型提示和描述是 LLM 理解工具用途的唯一依据。例如,search_notes 工具通过 @tool 装饰器声明描述,并返回 ToolResult。所有工具都是对同一辅助函数的薄包装,该函数向插件端点发送 POST 请求。
一个关键设计决策是让失败可读而非抛出异常。当 HTTP 请求失败时,工具返回包含错误码的 ToolResult,LLM 看到 notevs_extension_unreachable 后,技能会指示它回复“NoteVs 似乎没有运行”。用户永远不会看到堆栈跟踪。
LiteLLM 是一个统一封装多家 LLM 提供商 API 的 Python 库,它把 OpenAI、Anthropic、Groq、Mistral 等不同格式的请求与响应抽象为一致的接口。Rasa 在遇到未在官方映射表中列出的提供商时,会回退到 LiteLLM 进行路由,因此只要 LiteLLM 支持某个提供商,理论上就能在 Rasa 中通过 provider: <名称> 直接使用。这也解释了作者为何无需修改 Rasa 源码即可接入 Groq:配置层指定提供商名称后,请求实际由 LiteLLM 转换为 Groq 的 API 格式。对于希望在新兴推理平台上快速试验的开发者,这一回退机制降低了适配成本,但也意味着可用模型列表与工具调用支持程度取决于 LiteLLM 的版本和提供商的兼容性。
参数显式传递,避免环境依赖
作者遇到的最严重 bug 源于多窗口场景。当打开多个 VS Code 窗口时,每个窗口的代理都读取同一个项目。由于插件 HTTP 服务器使用固定端口,只有一个窗口能占用该端口,导致所有工具调用都由该窗口响应。作者发现代理列出了完全不相干项目的笔记。
修复方法是让辅助函数在每次调用时显式传递项目文件夹路径作为参数,该路径来自每个窗口为其代理设置的环境变量。如果某个值必须正确,就把它作为参数传入,不要依赖工具的运行环境。
技能控制工具可见性
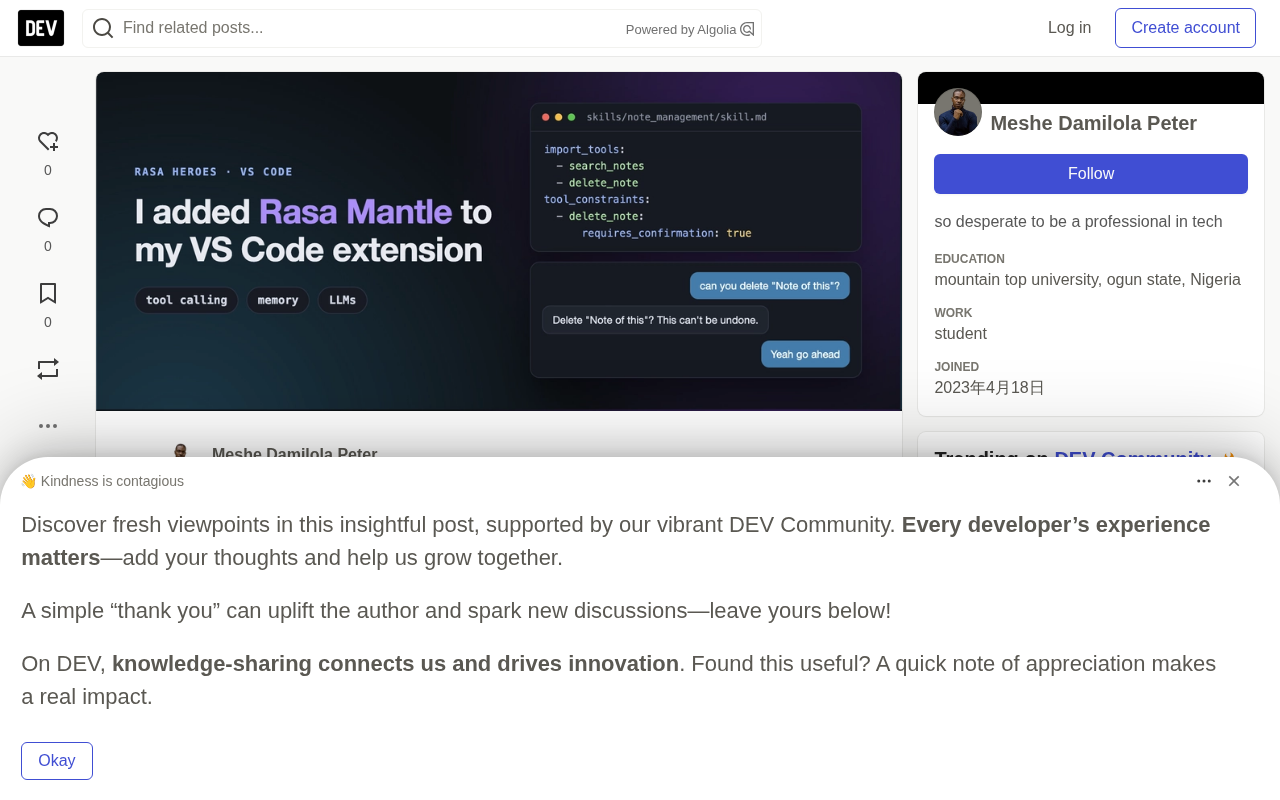
技能是 skill.md 文件,其 front matter 列出可用的工具,正文是自然语言指令。每个技能只导入所需的工具,模型无需从全部 10 个工具中选择。例如,“笔记管理”技能导入创建、保存、删除等工具,并设置 tool_constraints 要求删除操作必须经用户确认。
这种约束由框架强制执行:无论模型如何决策,删除、提醒和导出操作都必须等待用户确认。只读工具没有约束,因此“找到我的 bug 笔记并显示最新的”可以在单轮内链式调用搜索和获取工具。
会话启动技能覆盖
作者遇到的另一个问题是每条对话的第一条消息被吞掉。Mantle 内置的会话启动技能会向用户打招呼并结束本轮,导致“嘿,能列出我的笔记吗”只得到问候而没有工具调用。他通过一个什么都不做的技能覆盖了该行为,之后第一条消息直接进入正确的技能和工具。
记忆:声明式状态管理
Mantle 的记忆是技能在对话期间跟踪的值集合。每个条目必须先在 memory.yml 中声明,工具通过 context.memory.set(...) 写入。LLM 只能写入标记为 llm_settable 的条目,因此无法伪造验证结果等关键值。技能之间共享的值放在项目级 memory.yml 中,指令可以基于值进行分支。
作者仅轻度使用记忆:项目记忆中只有一个字段 folder_path,用于记录当前对话所属的 VS Code 工作区绝对路径。工具将文件夹路径复制到记忆中,以便在 rasa inspect 中查看对话属于哪个项目。项目字段一旦设置便锁定,适合会话期间不变的值。
作者计划进一步利用记忆:记住当前讨论的笔记,使两轮后的“删除那个”无需再次搜索;将记忆用作技能前置条件,例如只有集成连接后才启动导出。
rasa inspect 是 Rasa 提供的调试工具,用于逐轮查看代理的内部状态,包括技能激活情况、LLM 请求与响应、工具调用入参与返回值以及记忆的读写变化。在 rasa run 正常运行模式下,检查器不应启用,因为它会尝试绑定与 REST 通道相同的端口,从而引发 EADDRINUSE 错误。作者正是借助 rasa inspect --debug 定位了多窗口项目混淆、首条消息被吞掉等问题。对于基于 LLM 的代理,传统的日志往往不足以还原模型决策链路,逐轮追踪能力因此成为排查工具调用失败和技能误激活的关键手段,也是评估记忆值是否按预期写入的主要窗口。
LLM 层:在 Groq 上运行与模型选型
模型在 integrations.yml 中设置。Rasa 官方命名提供商包括 OpenAI 和 Anthropic,但作者希望利用 Groq 的速度。Groq 不在官方列表中。
通过阅读 Rasa 包中的提供商映射(rasa/shared/providers/mappings.py),作者发现未命名提供商会经过 LiteLLM,而 LiteLLM 支持 Groq。因此只需在配置中指定 provider: groq 和模型名称即可。
选型过程并不顺利:
openai/gpt-oss-120b两次未能通过 Mantle 严格的工具模式验证,一次调用了不存在的工具,一次尝试激活不允许的技能 ID,均导致请求以 400 错误结束。llama-3.3-70b-versatile在 Groq 文档中支持工具调用,但作者的账户实际无访问权限。- Qwen 是第一个正确完成“激活 → 搜索笔记 → 返回结果”完整流程的模型。但它默认开启思考模式,推理内容会泄漏到聊天回复中,且不总是在
<think>标签内。设置reasoning_effort: none可关闭思考模式。一个月后 Groq 将qwen3.6-27b替换为qwen3.8-27b,作者不得不重新固定版本。
经验教训:一个以工具调用为核心任务的代理,需要一个真正擅长工具调用的模型。 如果回合因模式错误而中断,速度毫无意义。此外,让提供商可替换:通过 LiteLLM,作者添加了一个小脚本,在启动时根据 LLM_PROVIDER 环境变量重写 llm: 配置块。现在切换到 Groq、OpenAI 或 Anthropic 只需修改一个设置,插件用户可在设置中选择。
免费层的限制
作者使用 Groq 免费 API 密钥运行。截图中展示了代价:要求代理删除笔记,确认后笔记消失,但追问“删除了吗?”时没有回答,只有面板的备用消息。Groq 限流了请求,输出通道显示 retry-after: 9。
删除操作成功了,只有 LLM 的下一条回复失败。 在免费密钥下,连续几条消息就可能触达限制,代理会错过回复或延迟。作者认为同样的限制也解释了第一张截图为何需要“你完成了吗?”的提示才返回列表。
这是免费层的限制,而非 Mantle 的问题。付费 Groq 密钥或切换到 OpenAI/Anthropic 即可消除。NoteVs 本身不需要 LLM:笔记、标注和搜索均可从侧边栏完成,代理只是可选层。
一个配置陷阱
在 integrations.yml 中设置 inspector.enabled: true 后,rasa run 打印“Rasa server is up and running”后崩溃,报 EADDRINUSE。检查器是用于独立 rasa inspect 命令的。在 rasa run 下,它会尝试绑定 REST 通道刚占用的同一端口。作者在运行配置中保持关闭,需要逐轮追踪 LLM 和工具调用时使用 rasa inspect --debug,这也是他发现上述大多数 bug 的方式。
实际体验与展望
这个项目是 Rasa Heroes 社区计划的一部分。作者鼓励使用 Mantle 的开发者,尤其是在 OpenAI 或 Anthropic 之外的提供商上尝试,并分享经验。目前一切基于预发布版本(rasa-pro==3.19.0.dev5),建议固定版本并预期变化。
对于考虑为现有工具添加 AI 代理的开发者,Mantle 提供了一条清晰路径:用自然语言定义技能,用类型化函数暴露工具,用声明式记忆管理状态,并通过 LiteLLM 灵活选择模型。挑战在于模型选型和平台限制,但架构上的简洁性显著降低了维护成本。
相关推荐

Orca多Agent编排实战:Claude与Codex并行协作指南
Orca是Stable AI开源的免费Agent工作台,支持Claude Code、Codex、Kimi等34个agent并行运行。本文介绍其Git worktree隔离机制、多模型编排分工方案(强模型拆解+便宜模型编码)、手机远程管理功能及实操上手步骤,帮助你高效管理多个AI编程助手。

思维链不止属于AI:人类如何用CoT提升思考质量
思维链(Chain of Thought)不只是大模型的提示词技巧。本文从Hacker News讨论出发,分析CoT为何对人类思考同样有效,拆解可操作的迁移方法,并指出人类CoT与机器CoT的关键差异。
Cloudflare联手OpenAI:用AI打通漏洞发现与防御闭环
Cloudflare联手OpenAI:用AI打通漏洞发现与防御闭环
Cloudflare 使用 OpenAI Daybreak 调查安全漏洞并生成可评审的修复方案,开发者同时借助 Codex 提升编码效率与代码质量,探索漏洞发现到防御响应的一体化路径。