RASS:排名感知推测采样如何为扩散模型提速20%

RASS利用草稿候选的免费排名信息优化验证顺序,在不损失采样精度的前提下加速扩散模型推理。
扩散模型推理成本高昂,推测采样通过「草稿模型生成候选、目标模型并行验证」来摊薄计算。论文RASS在树状草稿框架上提出改进:现有方法D-GRS按随机顺序逐一测试K个候选,浪费了候选之间隐含的排名信息。RASS提取「提议-目标均值位移」作为排名依据,以最小化总变差距离为目标优化采样权重,再结合最大耦合与残差修正保证精确采样。整套机制无需修改或重训模型,仅改变验证规则,在高斯混合、FFHQ、CIFAR-10及Stable Diffusion 3.5四类任务上均优于D-GRS,CIFAR-10匹配预算下提速约20%。
扩散模型加速的新思路:从推测采样说起
扩散模型(Diffusion Models)在图像生成领域取得了惊人成果,但其逐步去噪的生成过程往往需要大量迭代,推理成本居高不下。如何在不损失生成质量的前提下加速,是当前研究的核心议题之一。
推测采样(Speculative Sampling)提供了一种颇具吸引力的解法。它的思路是:用一个廉价的「草稿」模型并行生成多个候选状态,再由目标模型并行验证这些候选,只要验证机制设计得当,就能在保持目标分布(target law)不变的前提下显著减少昂贵的目标模型调用次数。这与大语言模型中的推测解码(Speculative Decoding)异曲同工,都是用「猜测+验证」来摊薄计算成本。
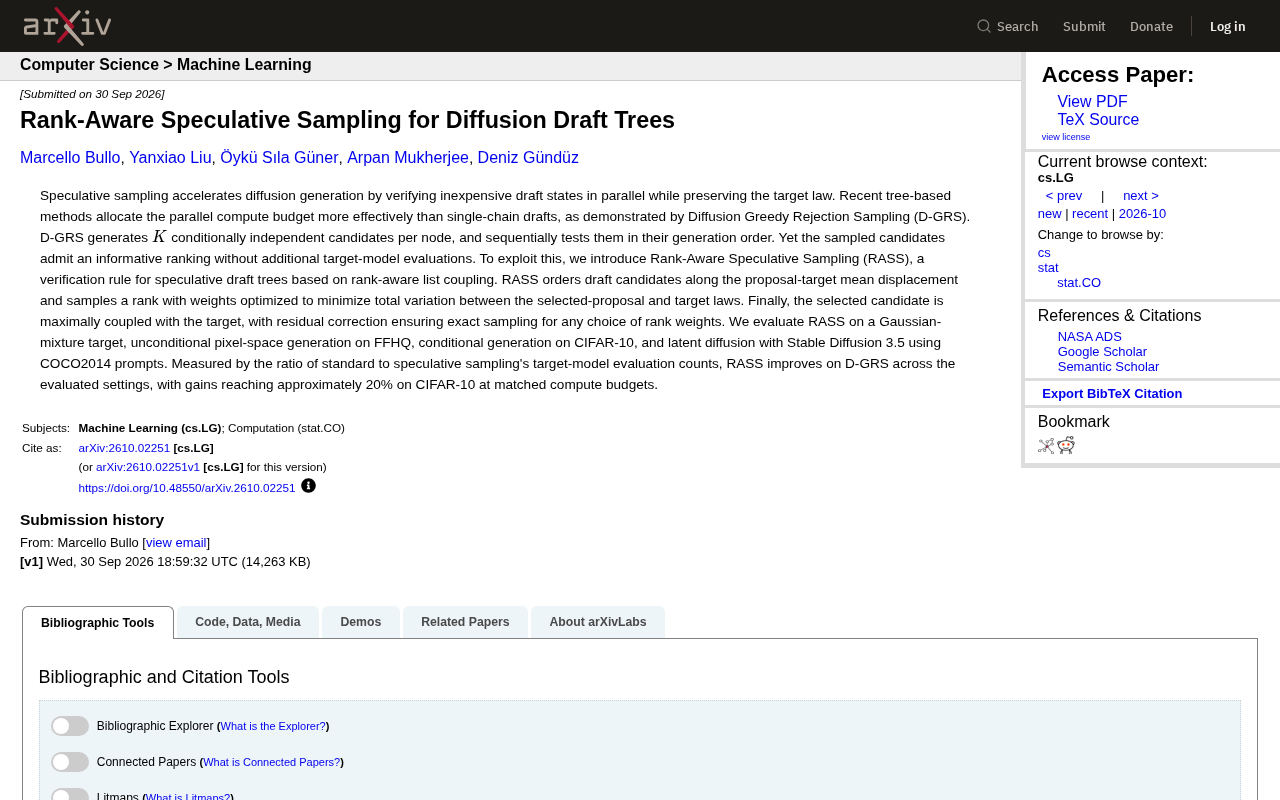
一篇发表于 arXiv 的新论文《Rank-Aware Speculative Sampling for Diffusion Draft Trees》(RASS)在这一方向上提出了改进,并在多个基准上取得了实测收益。
推测采样最初在大语言模型推理中被系统化提出:用一个小型「草稿模型」(draft model)连续生成多个 token,再由大型「目标模型」(target model)一次性并行验证所有候选,通过精心设计的接受-拒绝机制(acceptance-rejection scheme)保证最终输出与目标模型独立生成的分布完全一致。这一机制成立的关键在于:目标模型对一批候选 token 的并行验证,其计算成本与验证单个 token 相差无几,因此只要草稿模型的「猜中率」足够高,整体吞吐量就会显著提升。将这一框架迁移到扩散模型时,面临的新挑战是:扩散模型的采样空间是连续的高维分布,而非离散词表,传统的接受-拒绝规则需要重新设计,以处理连续概率密度之间的比较与修正。
从单链草稿到草稿树:D-GRS 的局限
早期的推测采样多采用单链(single-chain)草稿结构,即顺着一条路径生成候选并逐步验证。而近期的树状方法(tree-based methods)则把并行计算预算分配得更合理——与其押注一条链,不如在每个节点展开多个分支。
论文引用的代表性工作是 Diffusion Greedy Rejection Sampling(D-GRS)。D-GRS 在每个节点生成 $K$ 个条件独立的候选,并按照它们的生成顺序依次进行测试。这种设计充分利用了并行计算预算,比单链草稿更高效。
但作者敏锐地指出了一个被忽视的信息源:这 $K$ 个采样出来的候选,本身其实隐含了一个有价值的「排名」关系,而提取这个排名并不需要额外调用目标模型。D-GRS 简单地按生成顺序逐一测试,等于浪费了这部分免费的信息。
树状草稿结构(draft tree)的思路来源于对并行计算资源的重新分配:在同等计算预算下,与其沿一条路径深度展开若干步,不如在浅层节点横向展开多个分支,让目标模型一次验证整棵树上的多个候选。这样即便单条路径的接受率不高,整棵树中至少有一条路径被接受的概率也会大幅提升。D-GRS 正是在这一框架下运作的:它在每个节点独立采样 $K$ 个候选,再逐一用目标分布的接受概率测试,第一个通过测试的候选即被选中,其余丢弃。然而「按生成顺序逐一测试」意味着先被测试的候选并不一定是质量最优的,顺序本身引入了随机性浪费。
RASS 的核心机制:排名感知的列表耦合
针对上述问题,论文提出了 Rank-Aware Speculative Sampling(RASS),这是一套针对推测草稿树的验证规则,基于「排名感知的列表耦合(rank-aware list coupling)」。其核心逻辑可以拆解为三步:
1. 按均值位移排序候选
RASS 首先沿着「提议-目标均值位移(proposal-target mean displacement)」对草稿候选进行排序。这个排序刻画了各个候选相对于目标分布的偏离方向,是前面提到的「免费信息」的具体利用方式。
2. 优化权重后采样排名
接着,RASS 以一组经过优化的权重来采样某个排名位置。这些权重的优化目标很明确——最小化被选中提议分布与目标分布之间的总变差距离(total variation)。换句话说,它主动挑选那些更可能被目标模型接受的候选,从而提高验证通过率。
3. 最大耦合与残差修正
最后,被选中的候选与目标分布进行最大耦合(maximally coupled),并辅以残差修正(residual correction)。这一步至关重要:它保证了无论排名权重如何选择,整个过程都是精确采样(exact sampling),即最终样本严格服从目标分布,没有引入偏差。
这种设计的巧妙之处在于,排名权重的选择是「自由参数」——可以为了效率而优化,但正确性由耦合与残差修正来兜底,二者解耦,互不干扰。
实验验证:多场景一致提速
论文在四类任务上评估了 RASS,覆盖了从玩具问题到真实大模型的完整谱系:
- 高斯混合目标分布:验证方法在可控分布上的理论行为;
- FFHQ 上的无条件像素空间生成:人脸图像生成基准;
- CIFAR-10 上的条件生成:带类别条件的图像生成;
- 基于 Stable Diffusion 3.5 的潜空间扩散:使用 COCO2014 提示词,直接对接当下主流的大型文生图模型。
评估指标采用「标准采样与推测采样的目标模型调用次数之比」,即同样产出一个样本,推测方法能省下多少昂贵的目标模型评估。结果显示,RASS 在所有评估设置下都优于 D-GRS,其中在 CIFAR-10 上、匹配计算预算的条件下提速约达 20%。
能够在 Stable Diffusion 3.5 这类实用级潜空间扩散模型上验证,说明该方法并非停留在理论玩具,而具备落地到真实生成管线的潜力。
潜空间扩散模型(latent diffusion model)是当前主流文生图系统的基础架构:它不在像素空间直接执行扩散过程,而是先用编码器将图像压缩到低维潜在空间,在该空间中完成去噪迭代,再用解码器还原为像素图像。这一设计将扩散过程的计算量降低了数个数量级,使得高分辨率图像生成变得可行。Stable Diffusion 系列正是这一架构的代表,其 3.5 版本进一步引入了 Transformer 主干(DiT 结构),参数规模与生成质量均有显著提升。在此类模型上验证 RASS 的有效性,意味着该方法需要同时处理更复杂的条件信息(文本提示)、更长的采样链条以及潜在空间中连续分布的耦合计算,具有较强的实用参考价值。
意义与展望
RASS 的价值在于,它用一个「几乎免费」的洞察——候选候选本身蕴含的排名信息——换来了可观的推理加速,且不以牺牲采样精确性为代价。这类「不改模型、只改验证规则」的加速手段,对于已经训练好的大型扩散模型尤其友好,无需重新训练即可叠加收益。
当然,20% 的提速是在特定任务(CIFAR-10)、匹配预算下取得的,其他场景的收益幅度各异,论文并未给出所有设置下的统一数字。排名权重优化本身的开销、以及在更高分辨率、更长采样链条下的表现,仍有待后续工作进一步厘清。但作为推测采样草稿树方向上的一次精细化改进,RASS 展示了「榨干现有信息」这一思路的潜力。
背景补充
最大耦合(maximal coupling)是概率论中的一个经典构造:给定两个概率分布 $P$ 和 $Q$,最大耦合是一种联合分布,使得两个随机变量相等的概率恰好等于 $1 - d_{TV}(P, Q)$,即总变差距离的补值——这是理论上可达到的最高「重合概率」。在推测采样中,最大耦合的作用是:当草稿候选恰好落在目标分布的高概率区域时,直接「接受」它作为目标样本;否则,从残差分布(即目标分布与提议分布之差的归一化形式)中重新采样。这套接受-拒绝-修正的三步流程,在数学上严格保证了输出样本的边际分布等同于直接从目标分布采样,不引入任何系统性偏差,因此称为「精确采样」。
相关推荐

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。

NeurIPS SAC门票不可转让引讨论:政策变动惹争议
NeurIPS SAC 门票是否仍可转让引发 Reddit 机器学习社区热议。本文梳理政策变动争议、收紧背后的可能原因及对参会者的实用建议,帮助研究者正确应对顶会票务管理变化。