RayTrace:在Kernel层记录AI编程代理真实执行的沙箱

RayTrace 用 gVisor 沙箱在内核层记录 AI 编程代理的真实执行痕迹,弥合 transcript 与文件系统之间的审计断层。
RayTrace 针对 AI 编程代理的一个核心痛点:代理转录(transcript)声称执行的动作与系统内核实际发生的事情往往不一致,导致调试、安全与合规缺乏可信的 ground truth。其方案是把代理放入 gVisor 支持的沙箱,从内核层面采集每个进程的可执行文件、参数、工作目录、stdout/stderr、退出码与时间戳,并记录提议工具调用与实际进程之间的差距、文件系统 diff、syscall 与进程树证据,以及对受保护文件的变更告警。最受关注的功能是 forking a run:在任意 step 暂停,改变代理所见输入或环境后继续运行,观察行为差异,相当于对代理做可控的消融实验。项目目前处于小规模 pre-pilot 阶段,向 5 位高频运行 agent 的测试者提供 $10 Claude Code 沙箱额度以换取反馈。
RayTrace:在Kernel层记录AI编程代理真实执行的沙箱
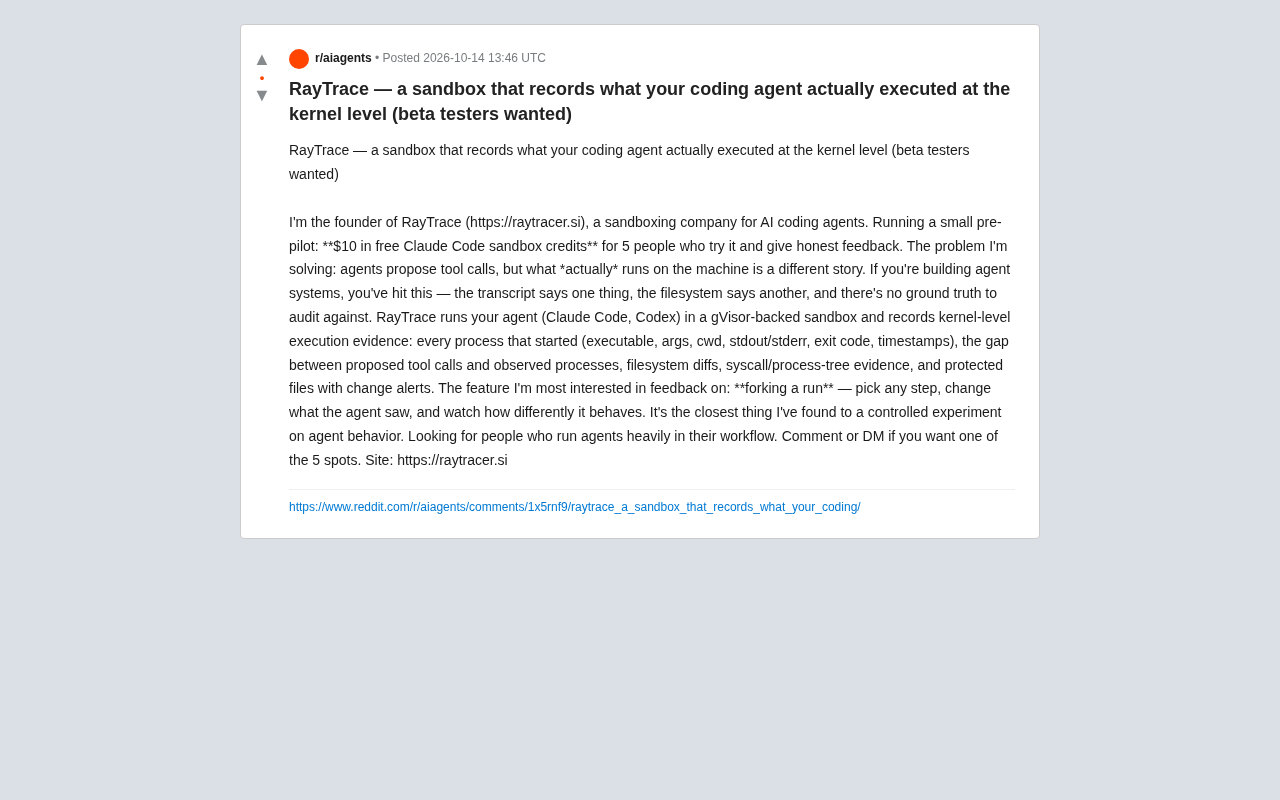
AI 编程代理正在快速进入开发者的日常工作流,但一个被普遍忽视的问题正在浮现:代理声称它做了什么,和系统实际执行了什么,往往是两回事。
RayTrace 的创始人最近在 Reddit 上发起了一个小规模预试点,寻找 5 位 Beta 测试者,提供 $10 的免费 Claude Code 沙箱额度。他提出的问题非常直接:代理提议工具调用,但机器上实际运行的内容是另一回事——transcript 说的是一回事,文件系统显示的是另一回事,而没有任何 ground truth 可供审计。
这个痛点,任何构建过 agent 系统的人都不会陌生。
为什么代理审计是个真问题
当前主流的 AI 编程代理(Claude Code、Codex 等)通过工具调用来操作文件系统、执行命令、运行测试。日志记录的是代理声称要做的动作,而不是内核实际执行的过程。
这种信息断层带来几类具体风险:
- 代理的 transcript 显示它只读了一个配置文件,但实际可能触发了额外的进程
- 声称没有修改某个目录,但文件系统的 diff 揭示了变更
- 某个 step 的决策依据无法回溯,出问题时无从复现
创始人用一句话概括了这种困境:"The transcript says one thing, the filesystem says another, and there's no ground truth to audit against."
对于把 agent 跑在生产环境或敏感代码库的团队来说,这不只是调试便利性的问题,而是安全与合规的基础设施缺口。
transcript 与工具调用:AI 编程代理的工作方式通常是先生成一段"我想调用某个工具、传这些参数"的结构化提议,再由运行时执行并把结果回填给模型。transcript 记录的正是这一层——模型的意图与提议。但提议到真正执行之间存在多个环节:运行时可能扩写命令、shell 可能展开通配符或环境变量、子进程可能派生更多进程、脚本内部可能触发网络或写文件。这些都不在 transcript 里。因此"代理声称做了什么"与"系统实际执行了什么"之间天然存在语义鸿沟,而传统的应用层日志往往只覆盖前者。这也是为什么把观测点下沉到 syscall 与进程树这一层,才能获得不依赖代理自述的独立证据。
RayTrace 的技术路径:gVisor + Kernel级证据
RayTrace 的核心思路是把代理放进一个 gVisor 支持的沙箱中运行,然后从内核层面采集执行证据。
具体记录的内容包括:
- 每一个启动的进程:可执行文件、参数、工作目录、stdout/stderr、退出码、时间戳
- 提议的工具调用与实际进程之间的差距(gap)
- 文件系统 diff
- syscall / 进程树证据
- 受保护文件的变更告警
这套数据结构的意义在于,它把代理行为从"信任 transcript"变成"对照内核事实"。你可以看到某个工具调用之后,系统里究竟启动了哪些进程、它们在什么路径下运行、返回了什么、是否成功。
技术上选择 gVisor 而非普通容器,意味着隔离层更靠近内核边界,syscall 级别的观测能力更强。对于需要严格取证(forensics)的场景,这一点可能是关键差异。
gVisor 是什么:gVisor 是 Google 开源的容器运行时沙箱,它的核心思路是在应用与宿主机内核之间插入一个用 Go 实现的用户态内核(Sentry)。容器内的应用发出的 syscall 不会直接落到宿主机内核,而是先被 Sentry 拦截、解析和模拟,只有经过白名单过滤的部分才会代理到真实内核。这带来两个后果:一是隔离面比普通容器(共享宿主内核)更小,逃逸难度显著提高;二是所有 syscall 都天然经过一个可观测的中间层,因此可以在不放内核模块、不用 eBPF 的情况下拿到细粒度的系统调用记录。对 RayTrace 而言,这正是它能在"内核层面"采集进程、文件、syscall 证据而不依赖内核侵入式 hook 的技术基础。代价是兼容性与性能:部分依赖特殊 syscall 的程序(如某些 GPU、嵌套虚拟化场景)可能无法运行,I/O 密集负载也会有可观开销。
为什么"内核层"比应用层日志更可信:应用层日志(包括 agent 自己写的 transcript、shell history、审计 hook)都由被审计对象或其同层组件产生,一旦 agent 被注入、被提示攻击劫持,或仅仅是实现有 bug,日志就可能与事实不符。内核层证据来自代理进程之外、之下的一层,agent 无法直接篡改。这也是取证(forensics)场景中"ground truth"一词的含义:它不是更详细的日志,而是独立于被观测者叙述的、来自执行环境的物理事实。
最有意思的功能:Forking a Run
创始人在帖子中特别点名了他最想获得反馈的功能:forking a run。
操作方式是:在代理执行的任意一个 step 处暂停,改变代理当时看到的输入或环境,然后继续运行,观察它的行为会如何不同。
他把这描述为"the closest thing I've found to a controlled experiment on agent behavior"——目前最接近代理行为对照实验的东西。
这个功能的实际价值可能被低估。目前评估代理行为大多依赖静态测试集或人工抽检,很难做到"同一起点、单一变量"的对照。如果 fork 能稳定工作,它把代理从"黑盒感知"变成可以反复做消融实验(ablation)的对象:
- 把某个文件内容换掉,代理的后续决策路径是否变化?
- 移除一个工具的输出,它会转向哪个替代方案?
- 同一个 prompt 在不同环境快照下,行为方差有多大?
对于做 agent 可靠性研究的团队,这类能力比单纯的日志审计更接近方法论层面的工具。
什么是消融实验(ablation):消融实验源自机器学习,指在保持其他条件不变的前提下,移除或替换系统的某个组件、输入或信息,观察输出如何变化,以此判断该因素的因果贡献。把它用在 agent 上,难点在于"同一起点、单一变量"很难保证——agent 的行为依赖完整的环境状态(文件内容、工具输出、对话历史),一旦重跑,环境往往已经改变。Forking a run 的价值就在于它冻结了一个可复现的状态快照,让你精确地只改动一个变量再继续执行,从而把 agent 行为从"观测"升级为"可重复的干预实验"。这与因果推断中的反事实(counterfactual)思路一致:不只看它做了什么,而是看如果某个条件不同,它会不会做出别的选择。
适用人群与当前阶段
这个项目目前处于**小规模预试点(pre-pilot)**状态。创始人明确表示想找的是"在 workflow 中大量运行 agent"的用户,而不是尝鲜者。提供的激励是 $10 免费 Claude Code 沙箱额度,换取诚实反馈。
从定位看,RayTrace 更可能吸引以下场景:
- 在 CI/CD 或本地开发中高频运行编码代理的团队
- 需要对代理行为做安全审计或合规留痕的组织
- 研究 agent 可靠性、做行为实验的开发者
需要注意的是,这是早期产品,创始人在公开征集反馈本身也说明功能成熟度仍在迭代。官网为 https://raytracer.si,有兴趣的可以直接站内联系或 DM。
一点判断
代理执行审计正在从"nice to have"变成基础设施需求。随着编码代理被赋予更多自主权——读写文件、执行命令、调用外部服务——"谁在什么时候做了什么"必须有独立于代理自身叙述的证据源。
RayTrace 切入的角度是内核层取证而非应用层日志,这在技术上是更重但更可信的路径。Forking a run 则指向一个更长远的方向:不只是审计代理过去做了什么,而是能对它的行为做可重复的实验设计。
这个方向值不值得投入,取决于一个更根本的问题——当代理足够可靠时,我们还需要这么重的审计吗?答案可能是:越可靠的系统,越需要能证明它可靠的证据。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。