热力学第二定律与AI的极限:宇宙困惑度注定增加
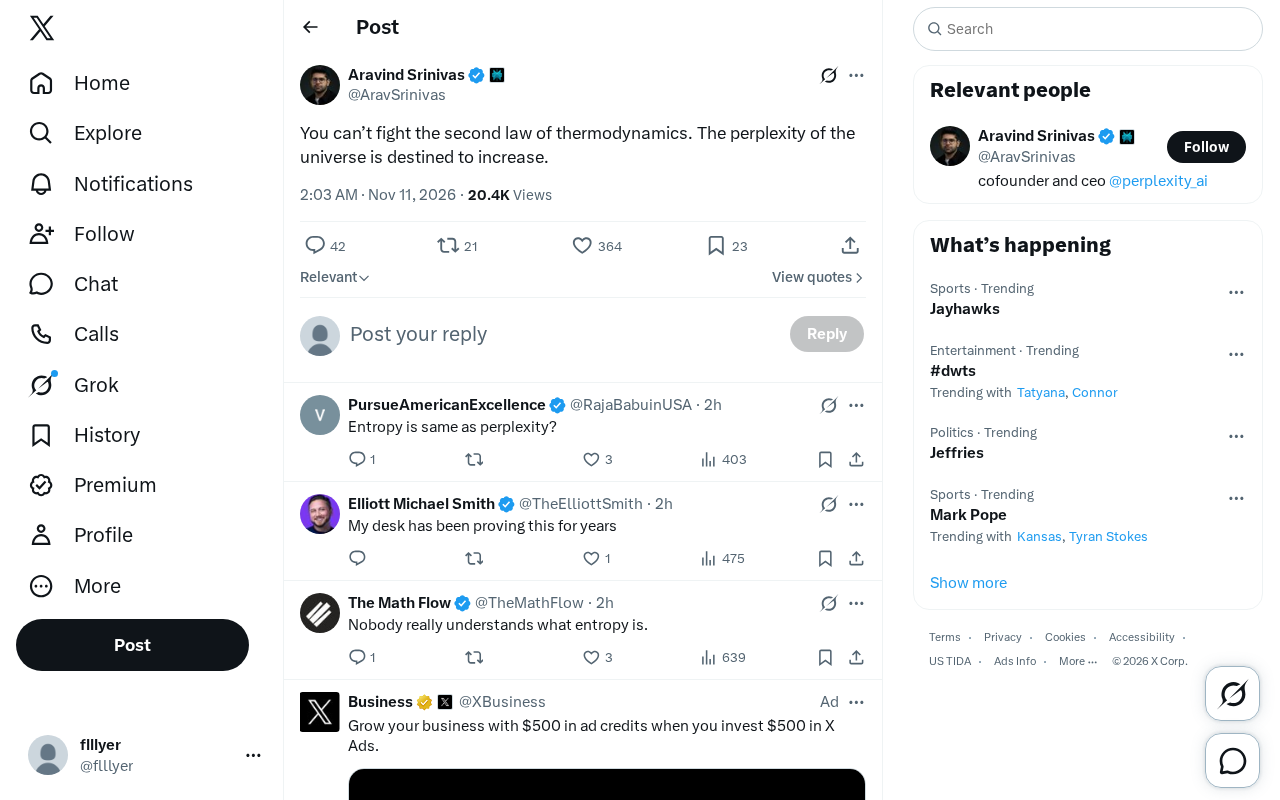
一条将热力学熵增与语言模型困惑度嫁接的推文,揭示了AI优化目标的物理边界。
文章从一条将热力学第二定律与机器学习困惑度类比的推文出发,探讨语言模型追求降低困惑度在物理层面的含义。文章首先介绍困惑度作为信息论指标在NLP中的核心地位,随后澄清热力学熵与香农熵虽有数学联系但并非同一概念,直接等同属于类比滑移。兰道尔原理表明信息处理必然伴随熵产生,模型降低困惑度的同时向环境排放热量。文章进而从模型能力边界、计算成本代价和对“理解”的谦逊三个层面,提醒AI从业者困惑度不可能无限降低,追求零困惑度在物理上不成立。最终指出该隐喻的价值在于为优化目标建立更诚实的物理地基,局部整理秩序仍是信息处理工作的意义所在。
一句推文背后的深刻命题
最近,一条来自Twitter的推文引发了技术圈的讨论:"You can't fight the second law of thermodynamics. The perplexity of the universe is destined to increase."(你无法对抗热力学第二定律,宇宙的困惑度注定增加)。
这句话巧妙地将物理学的熵增原理与机器学习中的"困惑度"(perplexity)概念嫁接在一起。表面上看是一句玩笑,但它触及了一个值得认真对待的问题:语言模型追求的"降低困惑度",在物理层面上究竟意味着什么?
困惑度:从信息论到语言模型
困惑度是信息论中的经典指标,用来衡量一个概率模型对样本的预测能力。在自然语言处理中,困惑度越低,意味着模型对下一个词的预测越"笃定",对文本的建模越好。GPT系列、BERT等模型在训练中不断刷新困惑度纪录,这几乎是整个领域的进步标尺。
但推文的作者把视角拉到了宇宙尺度。热力学第二定律告诉我们,孤立系统的熵不会自发减少。而熵在信息论中与"不确定性"直接对应——香农熵衡量的正是平均信息量。从这个角度看,宇宙整体趋向于更加无序、更加不可预测,用机器学习的语言说,就是"困惑度上升"。
困惑度(Perplexity) 的数学定义是模型对测试序列的逆概率的几何平均,等价于交叉熵的指数形式:$\text{PPL} = \exp(-\frac{1}{N}\sum_{t=1}^N \log p(w_t \mid w_{<t}))$。直观上,它表示模型在每一步预测时“平均在多少个等概率候选词之间犹豫”。例如困惑度为 20,意味着模型的不确定性大致相当于在 20 个词中均匀随机选择。在字符级或词级语言模型中,困惑度与压缩率直接挂钩:越低的困惑度意味着越高的压缩效率。需要指出的是,困惑度高度依赖词表大小和分词方式,不同词表下的数值不可直接比较;此外,困惑度只衡量模型对数据的拟合程度,并不直接反映生成质量或事实准确性。
两种"熵"的微妙错位
这里需要做一个澄清。物理学的热力学熵与信息论的香农熵在数学形式上有深刻联系,但并非同一个东西。热力学熵描述的是微观状态数的对数,香农熵描述的是概率分布的不确定性。把两者直接等同,是一种常见的类比滑移。
不过,这种类比并非全无道理。兰道尔原理指出,擦除一比特信息至少需要消耗kT ln2的能量,信息处理与热力学之间存在硬性约束。这意味着,任何计算——包括训练和运行大语言模型——都伴随着熵的产生。模型在训练集上降低困惑度的同时,在环境中制造了更多的熵。这是一笔无法赖掉的账。
对AI从业者的现实提醒
从工程角度看,这条推文的调侃有几层值得咀嚼的含义。
模型能力的边界
语言模型的困惑度不可能无限降低。训练数据有限、计算资源有限、噪声不可避免,模型对世界的建模总会有残余的不确定性。追求"零困惑度"在物理上就站不住脚,因为那意味着信息被压缩到极限而不产生任何代价。
交叉熵损失(Cross-Entropy Loss) 是语言模型训练中最常用的目标函数,其形式为 $-\sum_t \log p(w_t \mid w_{<t})$,即模型对真实下一个词所分配概率的负对数。最小化交叉熵与最小化困惑度在数学上等价,因为困惑度就是交叉熵的指数。交叉熵可以分解为真实数据分布的熵与模型分布同真实分布之间的 KL 散度之和:$H(p, q) = H(p) + D_{KL}(p | q)$。其中 $H(p)$ 是数据本身固有的不确定性,模型无法消除,只能最小化 KL 散度部分。这从信息论角度解释了为何“零困惑度”不可达:只要数据本身存在内在随机性,交叉熵就有一个不可突破的下界。
计算成本的真实代价
大模型的训练和推理消耗大量能源,产生热量,这是热力学第二定律的直接体现。业界对模型效率的追求——更小的模型、更少的参数、更低的推理成本——本质上是在与熵增做局部博弈。你可以让某个子系统的熵降低,但代价是外部环境的熵增加。
对"理解"的谦逊
如果宇宙的困惑度注定增加,那么任何模型对世界的"理解"都只能是局部的、近似的。这不是技术悲观主义,而是对建模活动本质的清醒认识。模型能压缩的是数据中的规律,而非世界本身。
一个值得保留的隐喻
这条推文的价值不在于它的物理严谨性,而在于它提供了一种跨学科的思考框架。把机器学习指标放到热力学的语境里,会让人重新审视那些被当作纯粹工程问题的东西——困惑度、损失函数、计算效率——背后其实有更基本的物理约束在起作用。
对于AI研究者而言,承认这些约束并不意味着放弃优化,而是让优化目标建立在更诚实的地基上。宇宙的困惑度也许注定增加,但人类仍然可以在局部、在有限范围内,把混乱整理成可用的秩序。这正是所有信息处理工作的意义所在。
背景补充
兰道尔原理(Landauer's principle) 由 IBM 物理学家罗尔夫·兰道尔于 1961 年提出,是信息论与热力学之间的桥梁。它指出:在常温下擦除一比特信息,至少需要耗散 $kT \ln 2$ 的能量(约 $3 \times 10^{-21}$ 焦耳,$k$ 为玻尔兹曼常数,$T$ 为绝对温度)。这一原理将信息的“逻辑不可逆性”与物理的“热耗散”绑定在一起:任何不可逆的计算操作都必须向环境排放热量。现代计算芯片的能效已比兰道尔极限高出多个数量级,但该极限作为理论下界始终成立。对于大规模神经网络训练而言,兰道尔原理提供了一个根本性的视角:降低模型内部的信息熵(即困惑度)必然以增加环境熵为代价,不存在“无代价的智能”。
相关推荐

美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
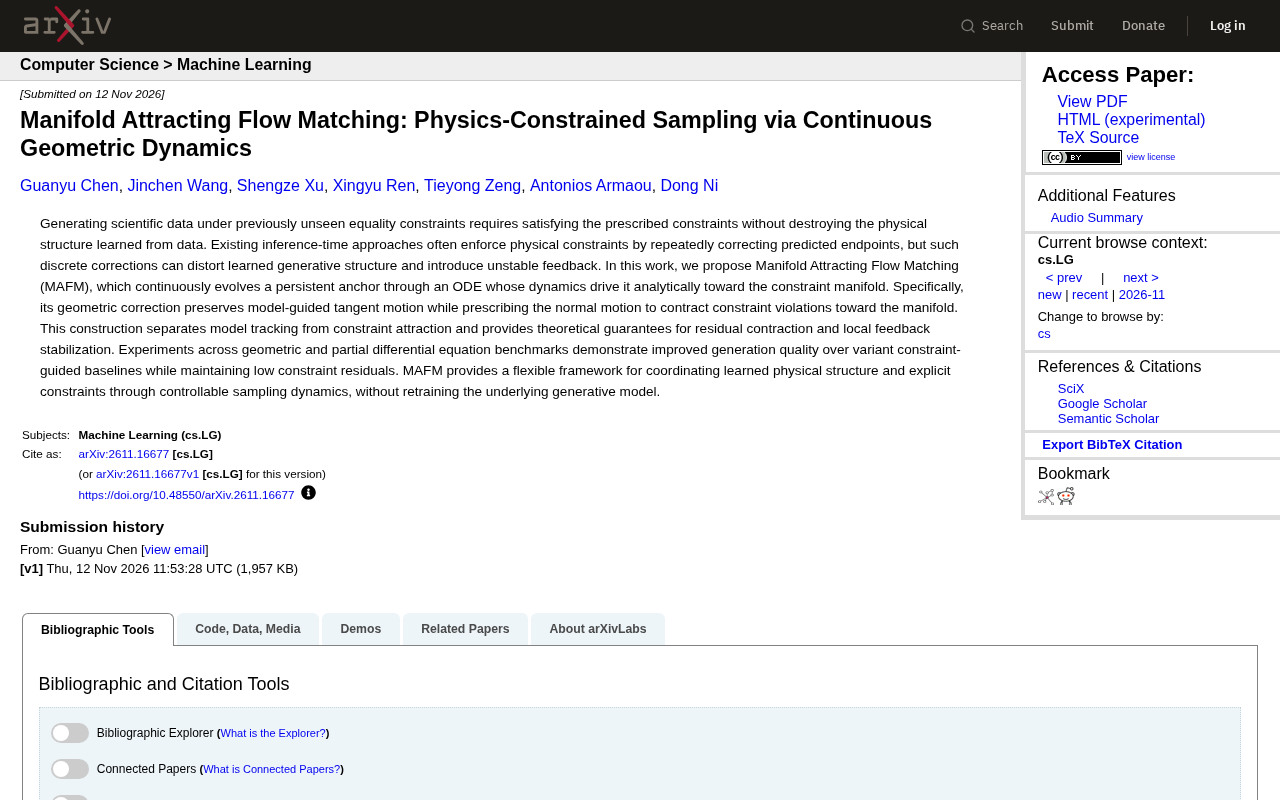
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。