Reactive Optimizers:训练中重写优化器源码,性能提升新范式

Reactive Optimizers在训练中动态重写优化器源码,实现代码级自适应。
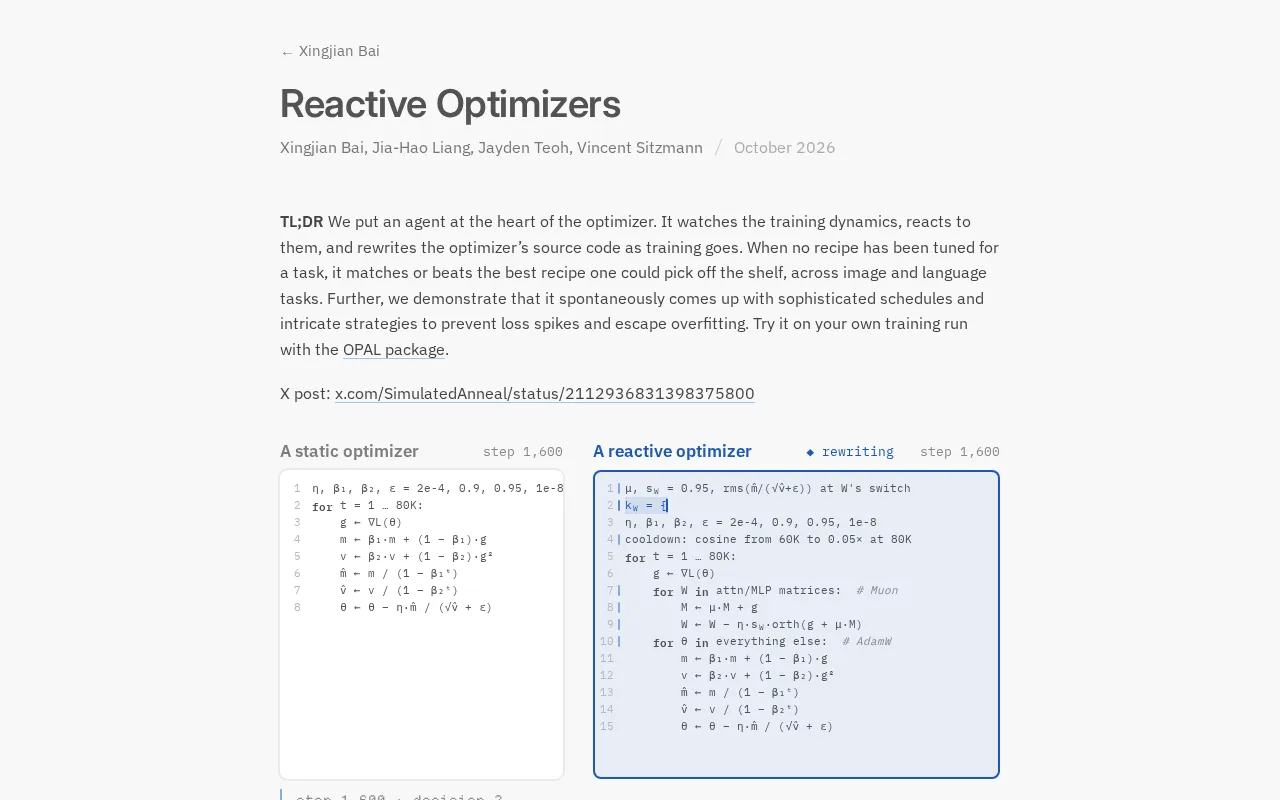
Reactive Optimizers提出在训练过程中动态重写优化器源代码,而非仅调整超参数,使优化器根据训练状态实时调整内部逻辑。其核心机制依赖于对优化器源码的抽象表示(如AST或中间表示),再根据梯度统计等反馈生成新代码。该方案将优化器算法本身作为搜索空间,区别于元学习和神经架构搜索,更接近程序合成。优势在于能获得比超参数搜索更细粒度的适应性,但风险是训练过程不再确定性,带来可复现性和稳定性挑战。对训练框架提出热替换代码的新要求,可能推动动态编译技术发展。目前该方案更接近概念验证阶段。
当优化器学会“自我修改”
在深度学习训练中,优化器(如 SGD、Adam)通常被视为固定组件,其行为在训练开始前就已确定。Reactive Optimizers 提出了一种反直觉的思路:在训练过程中动态重写优化器自身的源代码,让优化器根据训练状态实时调整内部逻辑。这个概念在 Hacker News 上引发了讨论,虽然原始帖子仅有 8 个点赞且暂无评论,但其背后的设计哲学值得深挖。
据 Hacker News 上的项目描述,Reactive Optimizers 不是简单地调整超参数,而是直接修改优化器的实现代码。这意味着优化器的更新规则、状态管理甚至数值计算方式都可以在训练过程中被重新生成。这种“元优化”思路将优化器从静态工件转变为动态适应系统。
核心机制:运行时源码重写
如何实现代码级自适应?
传统的超参数调度(如学习率衰减)只调整数值,而 Reactive Optimizers 在代码层面进行干预。其实现依赖于对优化器源码的抽象表示——例如将优化器逻辑解析为抽象语法树(AST)或中间表示,再根据训练反馈(如梯度统计、损失变化)生成新的代码片段。
由于原始素材未提供具体实现细节,尚不确定其采用即时编译(JIT)还是解释执行方式。但可以推断,这种方案需要低延迟的代码生成与替换机制,否则会严重拖慢训练速度。从工程角度看,这可能限制了其在大规模分布式训练中的直接应用,但在小规模实验或研究场景中具有探索价值。
抽象语法树(AST)是源代码语法结构的一种树状表示,每个节点对应代码中的一个构造(如赋值、函数调用、条件分支)。将优化器逻辑解析为AST后,程序可以在不修改原始文本的情况下,对特定节点进行替换、插入或删除,从而实现代码级自适应。中间表示(IR)则是编译器常用的更底层抽象,便于进行优化和代码生成。在Reactive Optimizers的语境下,AST/IR使得系统能够以结构化方式操作优化器逻辑,而非依赖字符串拼接,这提高了代码重写的安全性和可控性。不过,AST的构建与遍历本身有开销,且需要保证重写后的语法正确性,这对低延迟提出了更高要求。
与元学习、神经架构搜索的区别
元学习(Meta-Learning)通常学习的是初始化参数或超参数,神经架构搜索(NAS)搜索的是网络结构。Reactive Optimizers 的独特之处在于将“优化器算法本身”作为搜索空间。这更接近程序合成(Program Synthesis)与机器学习交叉的领域。单一来源的观点认为,这种思路可能催生针对特定任务自动定制的优化器,减少人工设计偏差。
程序合成(Program Synthesis)是计算机科学的一个领域,旨在根据用户意图(如输入输出示例、形式化规约或自然语言描述)自动生成满足条件的程序。与传统搜索不同,程序合成通常结合演绎推理与归纳搜索,在程序空间中寻找正确实现。Reactive Optimizers将优化器算法本身作为搜索空间,可视为程序合成在机器学习中的一种应用:系统根据训练反馈合成新的更新规则代码。这区别于元学习(学习参数)和NAS(搜索结构),更强调生成可执行的算法逻辑。程序合成面临的搜索空间爆炸和正确性验证难题,同样会出现在Reactive Optimizers中,是评估其可行性的重要视角。
潜在优势与风险
优势:更细粒度的适应性
优化器的更新规则往往是人为设计的启发式。例如 Adam 的自适应矩估计在稀疏梯度场景下可能表现不佳,但研究人员很难穷举所有变体。Reactive Optimizers 允许训练过程根据实时梯度分布重写更新公式,理论上能获得比超参数搜索更精细的适配。
风险:稳定性与可复现性挑战
源码在训练中被修改,意味着训练过程不再是确定性的——相同的初始配置可能因为代码生成路径不同而产生不同结果。这对实验复现构成挑战。此外,动态生成的代码可能引入数值不稳定性或安全风险(如生成非法操作)。原始资料未提及是否有沙箱或回滚机制,这是评估该方案实用性的关键缺失信息。
沙箱(Sandbox)是一种隔离运行环境,限制代码对系统资源的访问,防止恶意或错误代码造成破坏。在Reactive Optimizers中,动态生成的代码若未经检查直接执行,可能包含非法内存操作、无限循环或数值溢出等风险。沙箱机制可以限制生成代码的权限(如禁止文件I/O、限制CPU时间),从而提升安全性。回滚机制则是在新代码导致训练异常(如损失爆炸)时,自动恢复到之前的优化器版本。原始资料未提及这些机制,但它们是实现安全代码级自适应的必要工程组件。缺少沙箱和回滚,动态重写源码的方案难以在真实训练中可靠运行。
对AI研究与工程的影响
从研究角度看,Reactive Optimizers 将优化器设计从“人工调参”推向“自动编程”,与当前大模型驱动的代码生成趋势相呼应。如果能结合 LLM 生成优化器代码片段,或许能实现自然语言指导的优化器自适应。
从工程角度看,该方案对训练框架提出了新要求:框架需要支持热替换优化器代码,同时保证训练循环的稳定性。这可能会推动 PyTorch、JAX 等框架在动态编译方面进一步发展。
补充一点,由于原始素材信息量有限(仅标题和极简描述),本文对技术细节的推断需谨慎看待。Reactive Optimizers 目前更像一个概念验证或早期实验,距离生产级应用还有距离。但其“训练中重写源码”的思想,为优化器研究提供了一个值得关注的新维度。
热替换(Hot Swapping)指在程序运行过程中动态替换代码或组件,而无需重启整个系统。在训练框架中,热替换优化器代码意味着训练循环不能中断,框架需要安全地卸载旧优化器逻辑并加载新逻辑,同时保持模型参数和优化器状态(如动量、方差)的一致性。这对PyTorch、JAX等框架提出了挑战:PyTorch的动态图特性相对灵活,但优化器状态与计算图紧密耦合;JAX的静态编译和函数式特性则要求重新跟踪编译。实现热替换需要框架提供代码版本管理、状态迁移接口和同步机制,可能推动动态编译与模块化设计的发展。
相关推荐

Agent实战教程:从原理到多智能体落地
B站Agent实战教程第一课精华:讲清传统大模型、普通chatbot与Agent的本质区别,拆解感知、思考、行动三层架构,梳理教育等行业落地场景与学习路径。

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。