ReAct运行时上下文裁剪:Claude Code为何70%就动手

上下文裁剪通过成组丢弃、落盘索引和保留决策路径,保障Agent运行可靠。
文章指出上下文是边际收益递减的有限资源,信息越多模型召回精度越低,因此裁剪是Agent可靠性的命门。Claude Code在上下文使用约70%时即启动压缩,而非等到上限。占用最大的是工具调用,裁剪时必须将调用与结果成组丢弃以避免孤儿消息。文章还提出代码库因import等天然关系链可直接检索、无需RAG,并说明被裁信息会落盘建索引以支持回溯,同时强调系统提示词、文本推理和任务决策路径不可丢弃。
为什么上下文裁剪是Agent可靠性的命门
做AI Agent开发,很多人把注意力放在工具调用和提示词上,却忽略了真正决定智能体是否可靠的一环:上下文管理。B站UP主小福哥在《分币不掏,学习AI Agent开发》第17节里点得很透——上下文是一个边际收益递减的有限资源。哪怕模型支持超长上下文,把全部信息一股脑塞进去,token越多,模型的召回精度反而越低,注意力被稀释,它就越难搞清楚你到底要干什么。
所以问题不是“能不能放得下”,而是“该放什么进去”。这也是Claude Code在设计上给出的一个关键约束:它不会等到上下文撞到上限才处理,而是在使用率达到约70%时就开始做压缩和裁剪,把最精准、最需要的信息重新组装后再发给大模型。
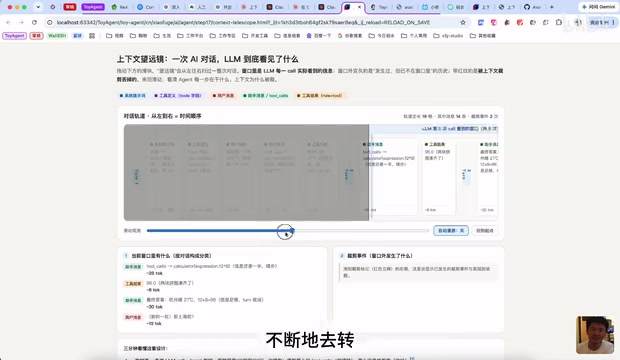
望远镜比喻:视野有限,只能边转边看
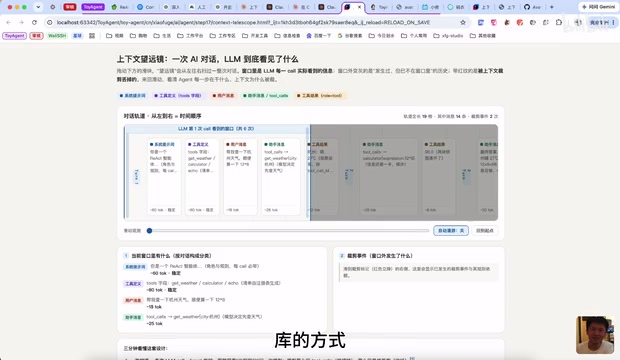
小福哥用一个很形象的比喻解释裁剪过程:人的视野有限,不可能一眼看全所有东西,只能转动脑袋、一块一块地看。Agent运行时也是如此,系统提示词、工具定义、用户消息、助手消息、工具结果按时间顺序不断向前滑动,必须在滑动过程中逐步裁剪,让对话能持续正确推进下去。
上下文窗口与注意力稀释:大模型的上下文窗口指单次推理能接收的token上限,主流模型已从早期的4K、8K扩展到128K甚至百万级。但窗口扩大不等于有效利用——Transformer的自注意力机制要对序列中每个token与其他token计算关联权重,序列越长,单个token分到的注意力越分散,关键指令容易被淹没。业界称之为“lost in the middle”现象:位于上下文中段的信息召回率明显低于开头和结尾。这解释了为什么把全部历史一股脑塞进去反而让Agent表现变差,也是裁剪策略存在的根本理由。
谁在吃掉你的上下文
搞清裁剪策略之前,先要知道上下文被谁占用。小福哥把占用来源拆得很清楚:
- 系统提示词:描述智能体能干什么、有哪些工具、怎么干、有哪些约束,基本固定。
- Skills技能:分层使用,第一层只放工具描述,真正用到时才提取具体内容,同样固定。
- 用户消息:通常只有一条,描述任务目标。
- 助手消息与工具调用:模型开始轮询后一步一步执行,这是真正的大头。
占用最多的几乎总是工具调用。工具要大量检索信息、传参、执行、拿回结果再分析,尤其涉及内嵌浏览器动态点击按钮抓数据的场景,上下文量会迅速膨胀。所以裁剪时,工具相关的消息往往是被裁掉最多的部分。
代码库为什么不需要RAG
这里有一个容易被忽略的工程洞见。早期Claude相关团队给整个工程生成知识库再向量匹配检索,但发现并不准确。后来主流Agent工具改为直接把工程当作一个文件库来检索——原因很简单:你写代码一定有import,类与方法之间的调用关系已经明确标记出来了,无论Python、Java还是C#。这种天然的关系链让逐步解锁代码变得准确可靠。
而法律条文、公司规范这类内容没有关系链,无法描述从A到B的路径,才需要RAG知识库或知识图谱来建立索引。这就是为什么很多代码Agent根本不把整个知识库再做一遍RAG——直接检索才是最准确的方式。
RAG与向量检索的适用边界:RAG(检索增强生成)的典型流程是把文档切块、用嵌入模型转成向量、存入向量库,查询时按语义相似度召回top-k片段。它的优势在于处理非结构化、缺乏显式关联的文本,但相似度匹配本质是模糊的,容易召回语义相近却答非所问的片段,且丢失文档间的结构关系。代码则相反:import语句、类继承、函数调用构成了显式的有向图,Agent可以顺着符号引用精确跳转,做到“查到哪里、确定无误”。因此代码Agent更接近IDE的符号索引(如LSP),而非语义检索。
裁剪的基本单元:一组一组地丢
裁剪不是随意删消息。工具调用和工具结果是配对的,必须成组丢弃——只丢调用不丢结果,或只留结果不留调用,都会产生“孤儿消息”,导致对话无法继续。小福哥用查杭州天气再计算的经典案例演示了这一点:助手消息触发工具调用,工具返回结果,这一组要么全留,要么全丢。
被丢弃的信息去哪了
Claude Code的一个设计细节值得注意:裁剪掉的内容并不会凭空消失,而是会写到本地文件里。这就是为什么你用各类Agent工具时会发现磁盘占用涨得很快——todo、整个过程的索引、上下文日志都会被落盘。除非手动清理,否则会一直累积。
这个设计解决了一个真实需求:某些场景(如下棋、围棋复盘)需要往前回溯很远的链路,看当时是怎么一步步发生的。把信息写入本地并建立索引,后续还能检索回来。标准做法是:上下文往后推进时裁掉最前面的信息,建立索引,再往后推进再裁,循环往复。
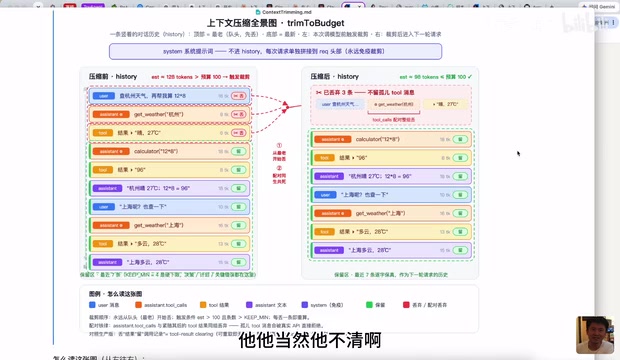
孤儿消息与消息配对约束:多数大模型API要求工具调用消息(tool_calls)与其结果消息(tool角色)严格配对出现,顺序和ID必须对应。若裁剪时只删掉其中一方,请求会直接被API拒绝或导致模型行为异常,这就是“孤儿消息”问题的技术根源。因此裁剪算法通常以“轮次”或“调用组”为最小单位操作,维护一个不可分割的消息组边界。工程上常见的做法是给每组消息打上可裁剪标记和引用计数,确保删除时整组原子性移除。
哪些消息绝不能丢
在小福哥给出的基准测试版本里,不同消息的裁剪优先级被明确区分:
- 系统提示词(行为契约):请求时单独拼装,天然免疫裁剪,裁掉系统就跑不起来。
- 用户消息:任务约束,前期处理完后通常可丢弃,但建议留兜底以备将来检索。
- 文本推理:优先保留,测试表明推理内容有价值,尽量别丢。
- 工具配对:整组丢弃,绝不产生孤儿消息。
对比教学案例与生产版本,核心原则一致:不丢任务的决策和路径。要么不丢记录,要么写清单,要么写进todo文件,保证状态可追溯。
从教学案例看工程复杂度
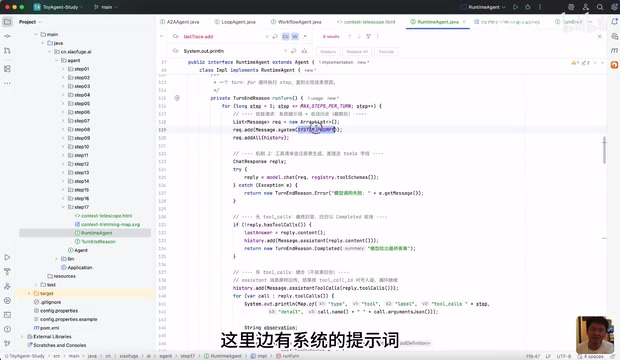
课程里的示例代码做了简化的裁剪循环:组装系统提示词与历史消息、调用工具、判断工具是否有返回、填充历史消息、处理正常完成与异常情况,最终返回结果。这只是一个没有索引的基础版本,正式Agent项目还要额外建立索引以支持后续检索。
而Claude Code、Codex这类生产级工具要复杂得多:记录历史消息、采集完成后裁剪、保留核心上下文。小福哥的建议是,学完简化版后去读Claude工程师关于上下文腐化和压缩工具的公开文章,理解压缩、裁剪、清除、内存管理的完整链路,这些资料会随课程代码一并提供。
一句话总结这一节:能一句话说清楚的事,不要说一百句。上下文裁剪的本质,是让智能体在运行时始终明确知道用户到底要干什么。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。