REA究竟是工具还是工作流?YouTube热传"杀死软件"真相
REA并非杀死软件的新引擎,而是把已有逆向工具接入agent证据循环的调度层。
所谓"杀死软件"的REA,其实并不生产逆向能力,它只是把Ghidra、IDA、Hopper等已有工具接入LLM agent,让agent反复索取反编译证据,直到能复现功能。Ghidra早在2019年就已由NSA开源,逆向工具本身并不新鲜,真正的变量是agent的调度与追问能力。由此带来的趋势是:软件复刻成本持续下降,靠单一功能建立的护城河变浅,价值正迁移到"在功能之上构建了什么"——数据、生态、合规与迭代速度。同时,REA官方也明确免责:逆向的权限与法律责任始终在使用者自己身上,自动化只会放大决策后果。
REA到底是什么?一个被"杀死软件"标签遮蔽的连接器
最近在 YouTube 等平台上,一个叫 REA(Reverse Engineer Anything)的工具被贴上了极具冲击力的标签——"杀死软件"。短视频里,解说者用近乎宣告的语气说:Everyone's saying this tool just killed software。但剥开这层情绪化的外壳,REA 的真实面目要朴素得多。
它把自己插入到类似 Cloud Code 这样的 agent 中,随后调用机器上已有的逆向工程工具——Ghidra、Hopper、IDA——把反编译得到的伪代码和证据回传给 agent。agent 不满足就继续追问,直到它能拼凑出足以复现某个功能的信息。
换句话说,REA 本身不生产逆向能力。它是一个调度层与反馈循环。88,000+ GitHub stars 说明社区热情高涨,但星标数衡量的是关注度,不是技术突破的幅度。
逆向工程(Reverse Engineering) 指在没有源代码的情况下,通过分析编译后的二进制程序来还原其结构、逻辑与行为的过程。常见手段包括反汇编(把机器码转回汇编指令)、反编译(进一步还原成接近高级语言的伪代码)、动态调试与内存分析等。逆向工程本身是中性技术,广泛用于安全研究、恶意软件分析、漏洞挖掘、兼容性开发与遗留系统维护;但在破解商业软件、绕过授权、抄袭功能等场景下也可能触碰法律与许可协议的红线。理解这一点很重要:REA 讨论的核心不是"能不能逆向"——这早已是成熟领域——而是当大模型 agent 接管调度后,逆向与复刻的效率与门槛发生了怎样的变化。
这些工具并不新,Ghidra 2019 年就已开源
视频中最有价值的一句提醒是:These tools aren't new。Ghidra 由 NSA 在 2019 年发布,此后一直是逆向工程社区的公开利器。IDA 和 Hopper 更是商业逆向领域的老牌玩家。
REA 的关键设计在于——它不打包、不分发 Ghidra 或 IDA。它做的是把 agent 连接到已经装在你机器上的那些工具。这一点被很多人忽略。
这意味着所谓"杀死软件"的不是某个具体的二进制造物,而是一种集成方式:让 LLM agent 直接驱动专业逆向工具,并用自然语言完成"反编译→理解→复现"的闭环。真正的变量是 agent 的调度能力,而非逆向工具本身。
Ghidra、IDA 与 Hopper 的定位差异:Ghidra 是 NSA 于 2019 年开源的逆向工程套件,功能完整且免费,支持反汇编、反编译、脚本扩展,是学术与安全社区的常用选择;IDA Pro 是商业逆向工具的老牌标杆,反编译器与插件生态成熟,广泛用于专业安全分析,价格昂贵;Hopper 则是面向 macOS 的轻量级商业反汇编/反编译工具,以界面友好和性价比著称。三者的共同点是:它们都提供高质量的反编译伪代码与符号信息,这正是 LLM agent 需要的"原材料"。REA 之所以选择"连接已有工具"而非自研引擎,是因为这些工具已经积累了数十年的解析能力,重新造轮子性价比极低。
agent 如何用证据循环逼近"能构建"的状态
视频里另一句值得琢磨的话是:the agent keeps asking until it can build the feature。这不是一次性调用,而是一个持续追问的证据收集过程。
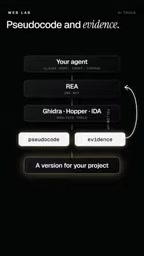
传统逆向工作流依赖工程师手动阅读伪代码、交叉引用、猜测数据结构。REA 模式下,agent 反复请求更多反编译片段、符号信息或运行时证据,直到它认为还原出的逻辑足以支撑重新实现。这个 loop 的终止条件不是"看起来对了",而是"能构建"。
这带来一个隐含的门槛:agent 能否提出正确的问题。逆向工程里,问对问题往往比拿到答案更难。REA 的价值上限,取决于底层模型对代码语义的理解深度。
LLM agent 的"证据循环" 指模型并非一次性输出答案,而是通过多轮工具调用主动收集信息、验证假设、修正推理的迭代过程。在 REA 场景中,agent 先请求一段反编译伪代码,判断信息是否足够复现目标功能;不足则指定新的函数、数据段或运行时行为继续索取,直到拼出完整逻辑。这种模式依赖两个能力:一是工具调度(知道何时调用哪个逆向工具、传什么参数),二是语义理解(读懂伪代码背后的设计意图)。它和传统"人读代码"的最大区别在于收敛速度——agent 可以高频试错,但若提问方向错误,也会在无效路径上快速消耗轮次。因此 agent 的能力上限,本质上受限于底层模型对代码语义与程序结构的理解深度。
复刻在变便宜,护城河在往上移
视频作者给出的判断相当克制:the shift isn't one tool。真正的变化是——copying software is getting cheap。当逆向与理解的成本持续下降,单纯的功能复刻会越来越难构成壁垒。
What you build on top is what matters。这句话把讨论从"REA 能不能杀死软件"拉回到更现实的层面:软件的价值正在从"实现了什么功能"迁移到"在功能之上叠加了什么"——数据、生态、可靠性、合规、用户体验、持续迭代速度。复刻一个功能容易,复刻一个产品的全部上下文很难。
合规提醒:权限责任在你自己
视频末尾提到了 REA 自己的免责声明:permission is on you,check before you ship。这一点在短视频的兴奋氛围中容易被淹没,但它是实打实的风险点。
逆向工程在多数司法辖区都处于灰色或受限地带,取决于目标软件的许可协议、当地法律以及使用场景。agent 让流程更快,但不会替你承担法律后果。把逆向能力交给自动化工具,意味着错误决策的执行速度也被同步放大。
逆向工程的合规边界 因司法辖区而异。在美国,DMCA 第 1201 条原则上禁止规避技术保护措施,但存在互操作性、安全研究等有限豁免;欧盟多国允许为 interoperability 与学习目的进行逆向;中国《著作权法》与《计算机软件保护条例》则对"学习研究""必要互操作"等有相对有限的例外。此外,目标软件的最终用户许可协议(EULA) 往往单独禁止逆向,即便法律本身不禁止。这意味着"技术上能做到"与"法律上可以做"是两回事。当 agent 把逆向流程自动化后,风险并未消失,反而因为执行速度提升而被放大:一次错误判断可能在几分钟内被批量应用到多个目标上。使用前应当确认授权范围、所在辖区规定与目标软件条款,并保留决策依据。
结论:不是工具的胜利,是工作流的重构
REA 被冠以"杀死软件"的标题,本质上是短视频叙事对复杂变化的压缩。它没有发明新的逆向引擎,也没有打包 Ghidra 或 IDA,它做的是把已有的专业工具接入 agent 的证据循环。
真正值得关注的信号有两个。其一,逆向与复刻的成本曲线正在下移,靠单一功能建立的护城河会变浅。其二,价值正在向"功能之上"迁移,谁能在复刻之上构建出不可轻易平移的东西,谁才握有下一阶段的主动权。至于 REA 自己,它的免责声明已经把答案写得很清楚:工具是中性的,判断和责任始终在使用者这边。
相关推荐

OpenAI推出ChatGPT青少年版,新增大学申请规划工具
OpenAI发布ChatGPT青少年版,账户自动识别并默认开启保护措施,同时预览大学申请规划工具College Planner,整合申请要求、截止日期、助学金步骤,并支持大学顾问。

用 ToolJet MCP 与 Jev 构建评论风暴分析器
用 ToolJet MCP 与 TypeSafe 的 Jev 决策模型,一段提示词构建评论风暴分析器:Jev 为每条评论返回情感、主题、紧急标记与支撑句,人工决定最终标签,并行 12 个 worker 在 6.4 秒内完成 100 条评论打标。

Perplexity Projects:面向AI代理的Git式文件系统
Perplexity Projects将文件系统设计为面向AI代理的Git forge,每个代理在独立沙箱中工作并提交到共享仓库,支持跨会话协作与版本化管理。