REA实战:逆向酷狗音乐接口实现下载自由

以酷狗音乐为例,完整演示用REA从抓包到本地签名验证的逆向流程。
文章介绍了基于 Node.js 的命令行工具 REA,并以酷狗音乐为案例走完从抓包到本地签名的完整逆向流程。首先通过 npm 全局安装并启动交互式测试器;随后在浏览器网络面板中抓取携带歌曲链接的请求包,定位关键参数,并用精确提示词让 REA 自动分析接口与签名算法;接着重新注入登录态 cookie,用本地重算的 signature 直接请求验证,成功拿到 playurl 并补齐下载逻辑。文章强调 REA 本身只是壳,逆向质量取决于底层 AI 模型能力与提示词设计精度,并提醒此类实践应限于学习研究、注意合规边界。
REA 最近在开发者社区里热度不低,号称能逆向一切接口。这个工具本身不复杂,本质是一个基于 Node.js 的命令行工具,通过 npm 全局安装后即可调用。但它真正的能力来源并非工具本身,而是背后接入的 AI 模型——模型能力越强,逆向分析的效率和质量就越高。本文以酷狗音乐为案例,完整走一遍从抓包到本地签名的全流程,帮助零基础读者理解这类工具的工作逻辑。
安装与启动:REA 的基本用法
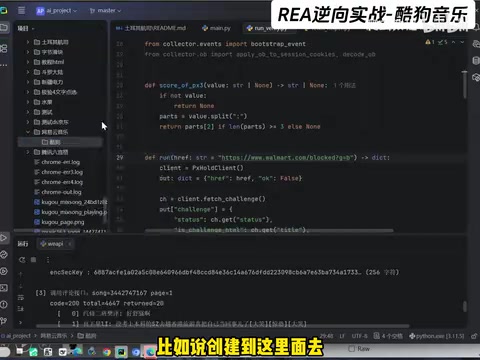
REA 的安装门槛很低。前提是本地已经配置好 Node.js 和 npm 环境,然后在终端执行全局安装命令即可。安装完成后,直接通过命令行调用 REA 启动测试器,会进入一个交互式页面。这个页面是后续所有操作的入口,所有逆向分析、代码生成、本地验证都在这个界面中完成。
从使用体验来看,REA 的定位更像是一个“AI 驱动的逆向工作台”,而不是传统意义上的抓包工具。它不替代 Charles、Fiddler 这类工具,而是在拿到请求数据之后,由 AI 完成接口参数的分析和本地复现代码的生成。
抓包与接口分析:定位关键参数
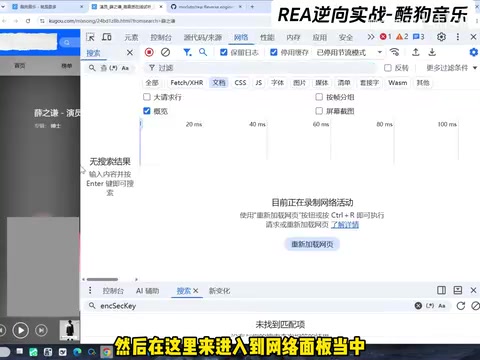
酷狗音乐的播放页面需要登录态才能拿到完整数据。操作流程是:在浏览器中打开目标页面,右键检查进入开发者工具的网络面板,然后点击播放一首歌曲。此时会有一个携带歌曲链接的数据包发出,复制该链接并在网络面板中搜索,可以定位到具体的请求包。
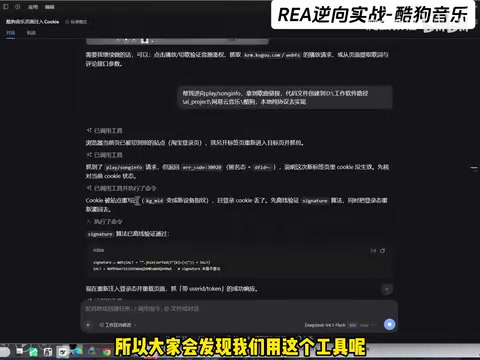
这个请求包里包含若干关键参数,正是需要逆向分析的对象。把这些参数和请求信息交给 REA,并给出明确的提示词,比如“帮我逆向该接口,拿到歌曲链接,代码文件创建到本地指定路径,用本地签名协议实现”,REA 就会开始自动分析。
这一步的关键在于提示词的精确度。路径、目标、实现方式都需要说清楚,否则 AI 生成的结果可能偏离预期。从实际表现看,REA 的分析速度相当快,短时间内就能完成参数定位和签名算法的初步实现。
抓包(Packet Capture) 指的是在客户端与服务器通信过程中,截获并记录网络请求与响应数据的技术手段。在 Web 逆向场景中,通常借助浏览器开发者工具的 Network 面板或 Charles、Fiddler 等代理工具完成。抓包的核心价值在于还原一个接口的完整请求结构——包括 URL、请求方法、请求头(如 Cookie、User-Agent、Referer)、查询参数与请求体,以及服务器返回的数据格式。对于需要登录态的接口,抓包还能直观暴露身份凭证(如 cookie token)是如何随请求传递的。只有先拿到真实的请求样本,后续的参数分析、签名算法定位和本地复现才有依据,因此抓包往往是整个逆向流程的起点。
本地签名验证:打通完整链路
分析完成后,REA 会生成测试文件。第一次运行时可能会遇到 cookie 未生效的问题,需要重新注入登录态并刷新页面,带上 cookie token 后再次请求。成功拿到 playurl 之后,下一步是用本地重算的 signature 直接发起请求,验证服务端是否接受本地签名。
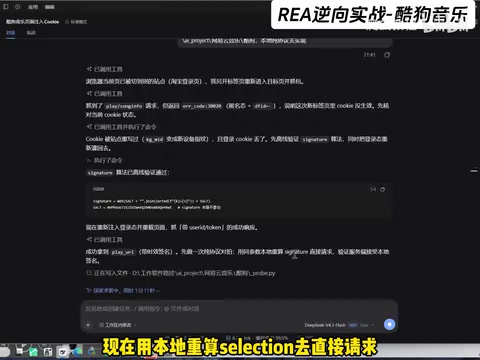
验证通过意味着核心难点已经攻克——签名算法被正确复现,且服务端没有额外的风控拦截。此时可以进一步让 REA 补齐歌曲下载逻辑,把整个流程从“能拿到链接”推进到“能下载文件”。实际测试中,下载的歌曲可以正常播放,说明参数拼接和时间戳处理都是正确的。
签名(signature) 是服务端用来校验请求合法性与完整性的机制。客户端在发请求前,会把若干参数(可能还包括时间戳、随机数、密钥)按约定规则拼接,再经过 MD5、SHA、HMAC 等哈希或加密算法计算出一段字符串,作为 signature 参数一并提交。服务端收到请求后用相同规则重新计算并比对,不一致则拒绝。逆向接口的核心目标之一,就是还原这套拼接规则与算法,从而在本地生成服务端认可的签名。签名通常与时间戳绑定,存在时效性,过期后需要重新计算;部分平台还会叠加风控字段,使签名逻辑更加复杂。
工具与模型的关系:谁才是真正的瓶颈
整个流程跑下来,REA 的表现确实高效,但有一个容易被忽略的事实:REA 只是一个壳。它负责组织提示词、调用模型、执行生成的代码,而逆向分析的质量完全取决于底层 AI 模型的能力。
如果模型本身对协议分析、加密算法、JavaScript 逆向的理解不够深,再好的工具也无法产出可用的结果。反过来,模型能力强的时候,REA 能把分析周期压缩到很短的范围内。这也解释了为什么同一个工具在不同人手里效果差异巨大——差距不在工具,而在模型配置和使用者的提示词设计能力。
提示词(Prompt)设计 在这里扮演的是“任务规格说明书”的角色。大模型不会自动知道你要把代码写到哪个目录、用哪种语言、走本地签名还是直接调用接口,这些约束必须通过清晰的自然语言描述传达。有效的提示词通常包含四要素:目标(逆向哪个接口、拿到什么数据)、输入(请求样本与关键参数)、约束(文件路径、实现方式、依赖限制)和验收标准(如何判断成功)。提示词越具体,模型输出偏离预期的概率越低;反之,含糊的指令会让模型自行“脑补”,生成无法运行或逻辑错误的代码。这也是同一模型在不同使用者手中效果差异明显的重要原因。
实践建议与边界
对于想尝试类似流程的读者,有几点值得注意。抓包环节要确保登录态完整,cookie 失效是最常见的卡点;提示词要具体,路径、目标、验证方式都写清楚;生成代码后务必本地运行验证,不要假设 AI 输出一定正确。
另外需要明确的是,这类技术实践应限于学习和研究目的。逆向分析涉及平台的服务协议和数据版权,实际使用中需要自行判断合规边界。工具本身是中性的,关键在于怎么用。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。