Reddit内容被删除:AI时代数据存档的困境

Reddit官方删除导致帖子完全消失,暴露出AI依赖的网络语料在可存档性与可复现性上的系统性风险。
文章以一次Reddit帖子被官方以违反内容政策为由整体移除的事件为切入点,指出这类删除不仅让原文不可见,更切断了评论、上下文与作者意图构成的整条讨论链路,且删除理由模板化、无法判断具体原因。文章进一步分析平台审核的自动化倾向与存档生态的连锁反应,说明官方删除权限更高、透明度更低,而依赖公开API的第三方存档能否保留副本并不确定。对AI领域而言,Reddit数据长期用于模型训练与舆情研究,删除会造成样本缺失、数据污染与可复现性断裂。文章最后提出个人应做本地或去中心化存档,平台应提供更细粒度删除说明,研究者需建立冗余数据来源,并把「数据会消失」作为默认前提。
当帖子消失:一次典型的Reddit内容删除事件
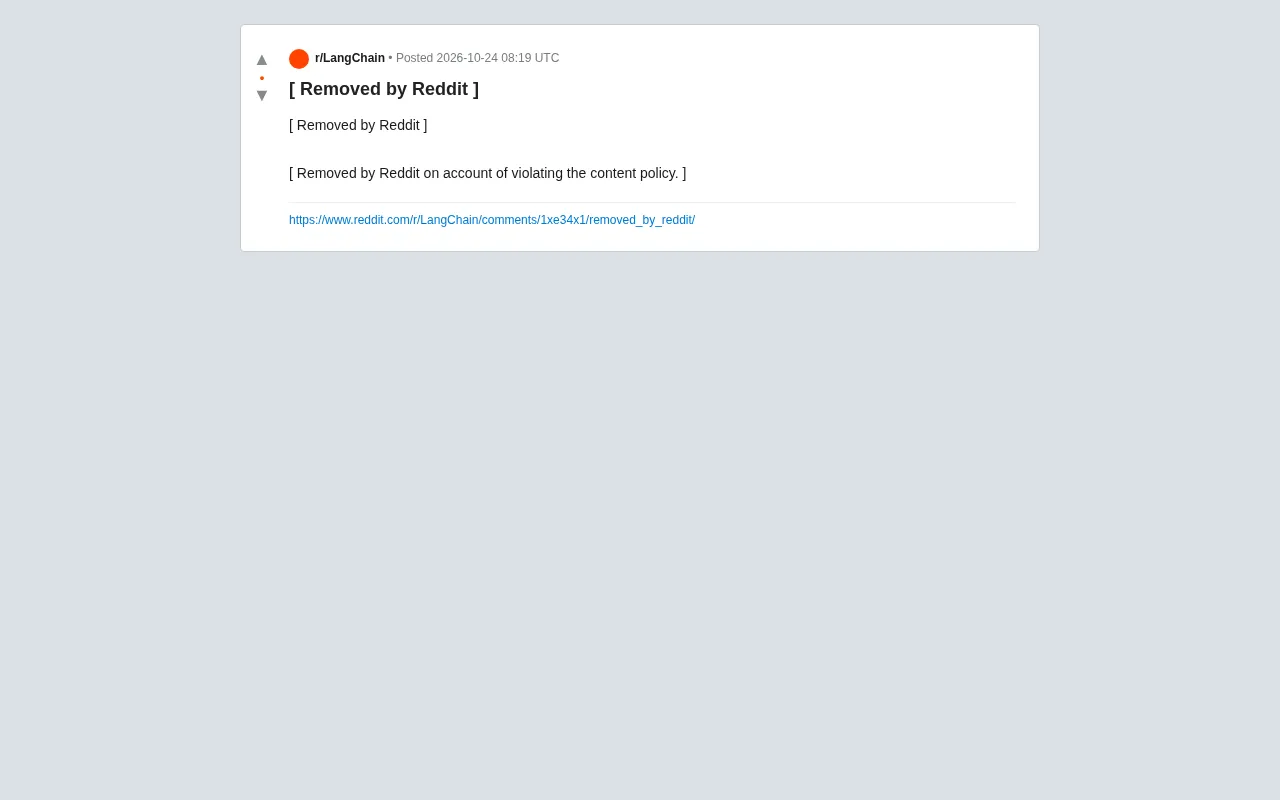
在Reddit上看到「[ Removed by Reddit ]」这样的提示,对很多用户来说已经不陌生。本次素材正是一个典型案例:原帖标题与正文均被平台以违反内容政策为由移除,只留下两行冰冷的删除说明,以及一句「[ Removed by Reddit on account of violating the content policy. ]」。
对内容创作者和研究者而言,这类删除带来的问题不只是「看不到原文」,而是整条讨论链路的断裂——评论、上下文、作者意图全部失效。更微妙的是,删除理由本身也是模板化的,读者无法判断是版权投诉、隐私泄露,还是自动化审核的误判。
删除机制背后的技术与治理逻辑
平台审核的自动化倾向
Reddit的内容移除通常分为两类:版主(moderator)在子版块内的删除,以及Reddit官方(admins)的全局移除。后者的权限更高、影响范围更广,往往涉及法律风险或平台级政策。近年来,平台 increasingly 依赖自动化工具进行初步筛查,这就带来一个结构性矛盾:误删的成本由用户承担,而纠错通道却并不透明。
Reddit的审核体系是分层级的:子版块版主拥有其社区内的自治权,可依据自定规则删除帖子或评论;而Reddit官方(admins)则执行全站层面的内容政策,其删除会覆盖版主权限,并通常以「[ Removed by Reddit ]」这一固定标记呈现。官方删除往往触发于法律传票、DMCA版权投诉、涉及未成年人安全或人肉搜索等高风险情形,也可能来自自动化系统的批量识别。与版主删除不同,官方删除不会向普通用户披露具体条款,甚至版主也只能看到有限的说明,这构成了平台治理中「权限越高、透明度越低」的典型结构。
存档生态的连锁反应
Reddit长期以来是互联网存档的重要节点,大量第三方服务(如Pushshift、各类镜像站)依赖其公开API抓取数据。当官方删除发生时,这些存档是否同步、是否保留副本,取决于各服务自身的策略。本次素材中,连标题都未能保留,意味着该内容在公开层面几乎被彻底抹除。
Pushshift曾是Reddit数据存档生态的核心基础设施,它通过Reddit公开API持续抓取帖子和评论,并向研究者、版主工具和各类镜像站提供历史数据查询。2023年Reddit调整API政策后,Pushshift的公开访问被大幅限制,仅对部分审核人员开放,这直接改变了整个存档链条的可用性。此后,Academic Torrents、各镜像站以及去中心化存档项目(如ArchiveTeam)成为替代来源,但它们各自的覆盖范围、更新频率和保留策略差异很大。因此,当官方删除发生时,内容是否还有副本,取决于删除前是否有服务完成抓取,以及该服务是否愿意在收到删除通知后继续保留——这本质上是一个分散且不可保证的存档网络。
对AI训练与研究的实际影响
对AI领域而言,这类事件有直接的现实意义。Reddit的讨论数据长期被用于语言模型训练、社会舆情分析和对话数据集构建。当一个帖子被整体移除,依赖该数据源的模型或研究就会面临样本缺失,且往往无从追溯缺失原因。
更深层的问题在于可复现性。研究者若在论文中引用了一条Reddit讨论,而该讨论日后被删除,后续验证便无法进行。这不是个案,而是开放网络数据共同面临的系统性风险。
在AI训练语境中,Reddit数据常被用作对话语料、指令微调数据和人类偏好数据的来源,典型例子包括WebText(GPT-2训练语料的重要组成部分)以及后续多个开源对话数据集。这些数据集在构建时通常只保存文本快照,而不保留原始URL的可访问状态,因此当源帖子被删除后,数据集中的样本仍可能存在,但已无法回溯到原始上下文。这造成两种相反的风险:一是数据污染与隐私问题——被删除的内容可能包含用户后来撤回的个人信息,却仍留在训练集中;二是研究再现性断裂——后续研究者无法核验样本来源。二者都指向同一个治理缺口:数据集的版本记录与来源追踪机制尚未成为行业惯例。
内容消失之后的应对思路
个人层面的存档习惯
对普通用户来说,最现实的策略是对重要内容做本地或去中心化存档——截图、导出、或使用支持版本快照的工具。这听起来笨拙,但比依赖平台单点保存要可靠得多。
平台与研究者层面的改进空间
平台可以做的,是提供更细粒度的删除原因说明,以及在法律允许范围内保留「删除记录」而非完全抹除。研究者则需要建立数据来源的冗余机制,避免单一平台成为唯一入口。
在平台治理层面,业界已有一些可参照的实践方向:例如引入「删除原因分类码」(如版权、隐私、政策违规、执法请求),在不泄露敏感细节的前提下让用户和研究者了解删除性质;或提供「删除审计日志」接口,记录内容被移除的时间与依据类别。学术数据管理领域则强调数据来源的「可追溯性」与「版本化」,例如为数据集附带来源快照的哈希值或时间戳,使后续研究者能够判断样本在采集时是否完整。这些机制无法阻止内容消失,但能把「消失」本身变成可记录、可分析的事件,而非无声的黑箱。
小结
这次Reddit内容删除事件本身信息有限,但它是一个清晰的信号:在AI高度依赖网络语料的今天,内容的可获取性与可存档性已经成为不可回避的基础设施问题。无论是内容创作者还是AI从业者,都值得把「数据会消失」作为默认前提来设计自己的工作流。
相关推荐

大模型应用开发:普通人的高薪入行指南
大模型应用开发岗位应届生薪资高达3万5,SP Offer可达60万,且不看出身。本文解析这一高薪岗位的核心能力、入行方法,并分享普通人如何通过“干中学”抓住AI时代机遇。

告别AI网红脸:零基础漫剧视觉资产制作全攻略
B站UP主分享零基础AI漫剧视觉资产制作全流程:用豆包工作skill通过剧本先行、视觉参考、注入活人感三种方法摆脱AI网红脸,再用资产版排版、武器细节图、场景九宫格和电影色版锁定角色与场景一致性。

好视频背后的AI制作流程:从调研到智能体验证
AI视频制作不只是模型竞赛。本文拆解一套可迁移的四步流水线:调研专业流程、整理技能清单、配置智能体、实验验证,并说明如何用DeepSeek等通用大模型替代付费工具跑通全流程。