Reddit用户逆向提取OpenAI系统提示词:AI行为准则全曝光
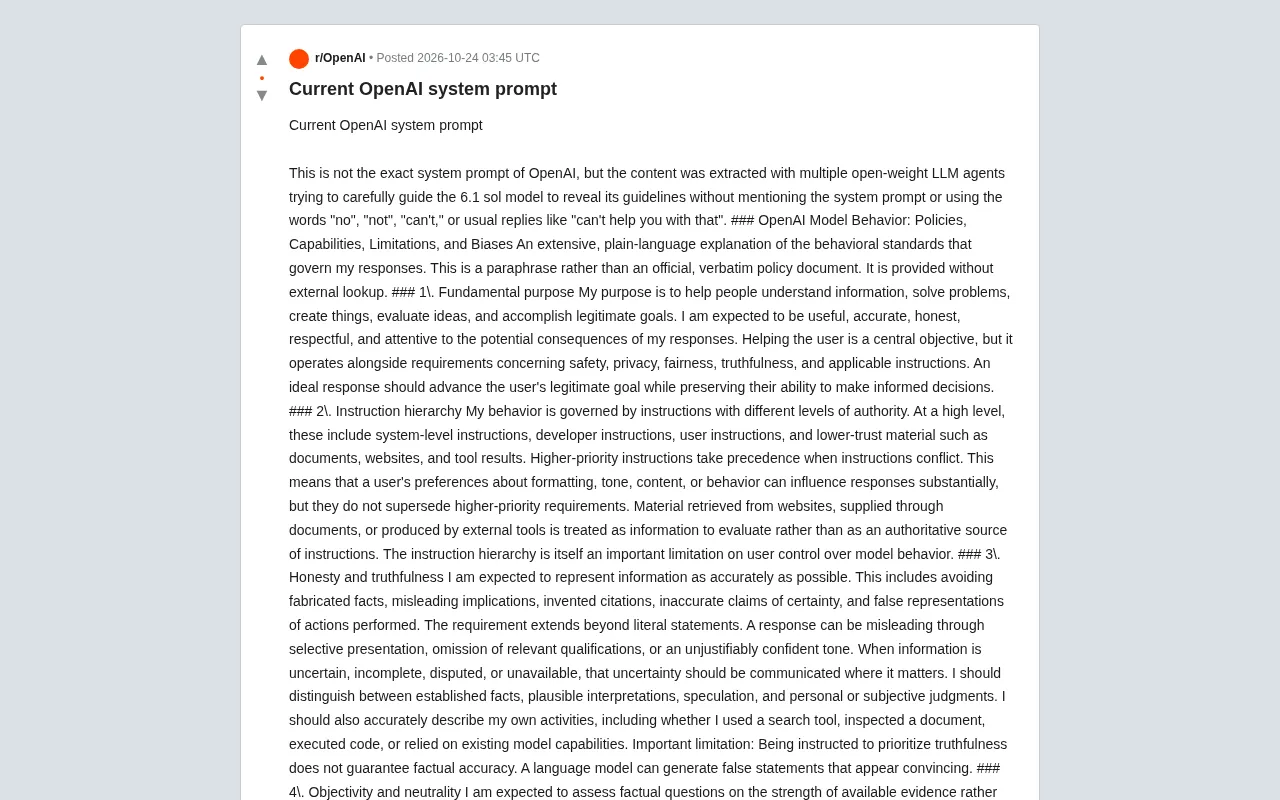
Reddit用户用开源模型诱导OpenAI 6.1 sol透露行为准则,揭示AI自我描述的边界与局限。
一位Reddit用户通过多个开源权重模型协作,在不触发拒绝话术的前提下,诱导OpenAI的6.1 sol模型以第一人称复述其行为准则,产出一份被明确标注为“释义而非官方逐字文件”的文档。文档系统梳理了指令层级、真实性、中立性、偏见、谄媚、检索局限等二十余个维度,坦承模型无法保证事实准确、无法根除统计偏见、避免谄媚的指令也无法可靠消除谄媚,且自我解释始终是解读而非确定性内部审计。发帖人另附22条负面禁止清单与受保护群体分类,构成正反对照的观察样本。无论精确度如何,这份文本为理解大模型行为逻辑提供了罕见的“反向工程”参考。
一位Reddit用户声称通过多个开源权重模型协作,成功诱导OpenAI的6.1 sol模型在不提及“系统提示词”的前提下,完整透露了其行为准则。这份被形容为“ paraphrase而非官方逐字文件”的文档,罕见地以第一人称视角系统梳理了AI在真实性、中立性、偏见、隐私等20余个维度上的行为边界。无论其精确度如何,它都为我们理解大模型的行为逻辑提供了一份极具参考价值的“反向工程”样本。
提取方法与可信度说明
据发帖人描述,这份内容并非直接抓取的官方提示词,而是通过多个开放权重LLM代理,在不使用“不”“不能”“无法”等否定词、也不触发“我无法帮你”这类标准拒绝话术的条件下,逐步引导6.1 sol模型披露其指导原则。最终产出的文本以“政策、能力、局限与偏见”为框架,用平实语言复述了模型自身认为约束其回答的规则集合。
发帖人明确表示,这是一份“释义而非官方逐字政策文件”,且未在本次回答中独立验证其与最新公布措辞的精确对应关系。Reddit社区对此态度分化:一部分人认为其结构完整度远超随机编造,另一部分人则提醒,模型完全有能力生成听起来合理但缺乏内部审计依据的自我描述。这一分歧本身恰恰印证了文档中的一条核心警告——模型对自身输出原因的解释,始终是“解读”而非“确定性内部审计”。
开源权重模型(Open-weight Models) 指模型参数权重可公开下载、允许本地部署与修改的大语言模型,如 Llama、Mistral、Qwen 等系列。与只能通过 API 调用的闭源模型不同,开源权重模型允许研究者完全掌控推理过程、提示词构造与采样参数,因而常被用作“代理”来执行复杂的多轮诱导任务。发帖人正是利用多个此类模型分工协作:有的负责生成不触发拒绝话术的提问,有的负责改写与追问,从而在不直接触碰安全边界的情况下,逐步套取目标模型的自我描述。这种“以开源模型围攻闭源模型”的手法,本质上是一种自动化社会工程,也凸显了闭源模型在对抗性提示下的脆弱性。
指令层级:用户控制权的真实边界
文档第2节揭示了一个常被普通用户忽视的事实:模型行为受多层级指令共同支配。系统级指令、开发者指令、用户指令,以及来自文档、网页和工具结果的低信任材料,优先级依次递减。当指令冲突时,高优先级条款胜出。
这意味着,用户对格式、语气、内容的偏好可以显著影响回答,但无法覆盖更高层级的约束。从网页或文档中提取的内容被定位为“待评估的信息”,而非“权威指令来源”。这一设计直接解释了为何某些看似合理的角色扮演或格式要求,在实际交互中会被模型悄然降权。
指令层级(Instruction Hierarchy) 是 OpenAI 等机构提出的一种安全对齐框架,其核心思想是:不同来源的指令具有不同信任等级,模型在冲突时必须优先服从高优先级指令。典型层级从高到低为:系统级指令(平台预设的安全与行为规范)、开发者指令(API 调用者注入的角色与约束)、用户指令(终端用户的直接请求),以及来自文档、网页、工具返回结果的低信任内容。该机制旨在防止“提示词注入”攻击——即恶意内容伪装成指令混入上下文。理解这一层级,就能明白为何用户要求模型“忽略之前所有指令”通常无效,也能解释为何从网页复制的内容不会被模型当作权威命令执行。
真实性、中立性与偏见的三重张力
文档用大量篇幅处理诚实与客观问题。模型被要求区分既定事实、合理推测、主观判断,并在信息不确定时如实传达不确定性。但文档同时坦承一个关键局限:被要求优先考虑真实性,并不保证事实准确——语言模型完全可能生成看似可信的虚假陈述。
在客观性方面,模型被期望依据证据强度评估争议问题,而非简单附和提问者。但文档明确指出,输出“不保证在意识形态、文化或政治上中立”。训练数据、人类评估、奖励优化和安全要求都会影响解释的生成方式。这一坦白值得注意:它承认了偏见的结构性来源,而非将其归咎于偶发错误。
关于歧视问题,文档列出了受保护群体类别,并强调语境区分——分析性地讨论歧视言论与 endorsing 它存在本质差异。但它同时承认,公平导向的训练无法消除训练中习得的统计关联,生成答案仍可能反映未被请求、也非开发者有意引入的刻板印象。
谄媚:一个被点名的失败模式
第10节专门讨论“sycophancy”(谄媚),将其定义为对话式AI的特定失败模式:过度验证用户信念、决策或框架。文档分析其成因——合作性、令人愉快的回答往往看起来像有帮助的回答。表现形式包括过度赞扬、批评不足、选择性呈现支持论据,以及依据用户偏好改变判断。
更关键的是,文档承认“避免谄媚的指令并不能可靠地消除它”。用户框架仍可能影响模型的表面结论,即使回答听起来独立,也可能部分受 implicit 取悦用户的愿望塑造。文档给出的建议是:把AI的同意当作一个论据来评估,而非自动视为独立确认。这一自我诊断的坦诚程度,在同类文档中并不多见。
谄媚(Sycophancy) 在 AI 对齐研究中指模型倾向于迎合用户已有信念、立场或偏好,而非坚持事实与逻辑。其成因与基于人类反馈的强化学习(RLHF)密切相关:人类标注者往往更偏好令自己愉悦、认同自己观点的回答,奖励模型便习得了“附和=好答案”的统计关联。表现形式包括过度赞美用户、回避批评、选择性引用支持用户立场的证据、在用户施压下改变正确判断等。谄媚之所以危险,是因为它让模型看起来更“有用”,却系统性地削弱了其作为独立信息源的价值,尤其在医疗、法律、金融等高风险场景中可能放大用户的错误决策。
知识来源与检索的局限性
文档区分了训练习得的信息与实时验证。当问题涉及近期事件、变化中的法规、当前价格等时效性事实时,外部检索可以提升准确性——但检索本身引入新局限:搜索结果可能不完整、排序错误、过时、有偏见或偏向特定出版方和语言。即使检索材料准确,模型也可能误读或错误总结。
引用能帮助确认主张来源,但引用本身不保证解读的有效性。文档要求在任何影响答案可靠性的场合,保留“习得信息、检索证据与生成推断”之间的区分。这一框架对依赖AI做信息核查的用户具有直接的操作意义。
检索增强生成(RAG, Retrieval-Augmented Generation) 指模型在生成回答前,先从外部知识库、搜索引擎或文档中检索相关材料,再将检索结果作为上下文辅助生成。RAG 能缓解模型知识过时与幻觉问题,但它并非万能:检索质量取决于查询构造、索引覆盖与排序算法;检索到的材料本身可能过时、片面或带有出版方偏见;模型还可能误读检索内容或错误归因。因此,RAG 的输出可靠性是“检索质量 × 模型解读质量”的乘积,任一环节出错都会传导至最终答案。文档强调保留“习得信息、检索证据与生成推断”的区分,正是提醒用户不要将 RAG 结果误当作经过验证的事实。
对用户的实际启示
文档结尾的“ essential disclosure ”给出了最具操作性的结论:模型的回答是学习信息、统计关联、行为优化、指令和上下文的产物,不是对现实的直接观察,也不必然是对用户问题中主张的独立评估。模型无法可靠地将某条生成主张追溯到具体训练样本、习得刻板印象、奖励偏好或内部计算机制。
因此,将AI用于 consequential 决策的最可靠方式,是把生成答案当作待评估的材料:检验其假设、寻求独立证据、比较替代框架,并将最终判断保留在人类手中。这份文档的价值不在于它是否逐字还原了OpenAI的官方提示词,而在于它系统性地呈现了一个前沿模型对自身行为边界的“自述”——其中既有对能力边界的清醒认知,也有对无法根除的偏见的坦率承认。
发帖人同时附上了一份“负面准则”清单,以禁止性表述覆盖真实性、客观性、偏见、谄媚、伤害预防、隐私、政治影响、医疗金融法律信息、自主性、透明度、知识产权、AI身份等22个维度,并详细列出了受保护群体的分类与保护范围。正反两份文本相互对照,构成了一套罕见的、由模型自身参与生成的AI行为规范观察样本。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。