Redis高并发实战:秒杀超卖与缓存问题全解析
从Redis库存扣减案例拆解秒杀超卖、缓存与分布式锁,并延伸多Agent工程化。
文章基于B站UP主诸葛老师的公开课,从一段SpringBoot读取Redis库存并减一的极简代码出发,揭示秒杀超卖的本质是库存扣减非原子操作。随后逐层讨论:单机synchronized或ReentrantLock虽能防超卖,但在高并发下性能受限,且无法应对分布式部署,因而必须引入Redis分布式锁;同时补充了缓存穿透与缓存击穿的区别及布隆过滤器、互斥锁等应对手段。课程另一板块将高并发架构思想迁移到多Agent AI工程化,用Redis承担通信缓存与分布式锁保证任务幂等。整体内容实战性强,适合有一定Java基础、希望深入高并发领域的开发者。
在电商秒杀场景下,高并发往往带来一系列棘手问题,而Redis作为缓存与库存扣减的核心组件,其使用方式直接决定了系统的稳定性。近期,B站UP主诸葛老师在一节公开课中,从一个极简的库存扣减案例出发,逐步拆解了秒杀下单链路中的高频坑点,包括超卖、缓存穿透/击穿、分布式锁等,并延伸至多Agent AI工程化实战。本文基于该课程内容,结合多源分析,梳理关键问题与解决思路。
从一行代码看超卖:并发下的库存陷阱
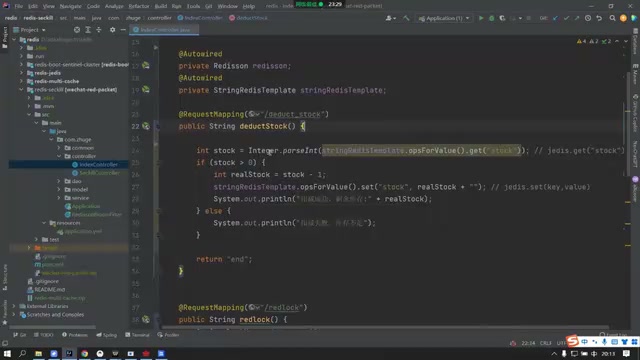
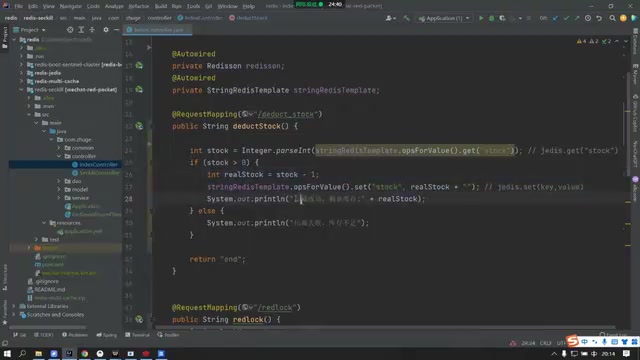
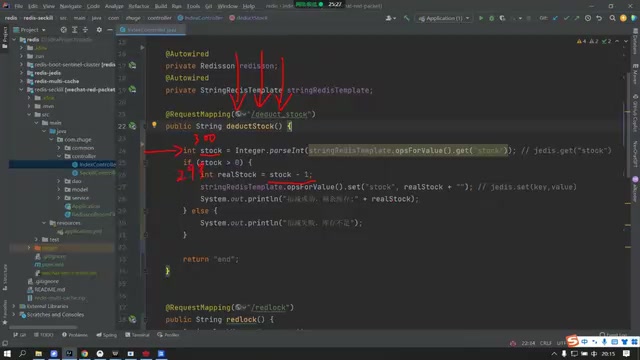
课程一开始,诸葛老师展示了一个SpringBoot接口,模拟从Redis读取库存值(默认300),判断大于0则减1并写回。代码逻辑看似正确,但一旦并发请求同时执行,问题立刻暴露:多个请求同时读到300,各自减1后写回299,最终库存只减了1,但实际卖出了多件商品,导致超卖。
这个案例直观地说明了超卖的本质——库存扣减不是原子操作。在秒杀场景下,类似京东的抢购页面,瞬时流量可能达到数万QPS,这种简单的“读-改-写”模式必然失效。诸葛老师强调,这是高频发场景下最典型的坑之一,也是后续复杂化讨论的起点。
原子操作与Redis单命令
超卖问题的根源在于“读-改-写”三步不是原子操作。Redis 提供了若干单命令原子操作,可绕开分布式锁完成安全扣减:DECR/INCR 在键存在时原子地加减并返回新值,但无法判断扣减后是否为负;DECRBY 同理。更稳妥的做法是先用 SETNX 初始化库存,再结合 Lua 脚本把“判断库存是否充足”和“扣减”打包成一个原子执行单元——Redis 执行 Lua 脚本期间不会插入其他命令,因此天然具备原子性。课程中演示的 SpringBoot 代码正是缺少这一层封装,导致并发下多个请求读到同一库存值。理解单命令与 Lua 脚本的原子性边界,是后续引入分布式锁之前应先掌握的底层能力。
加锁能解决超卖吗?性能与死锁的权衡
面对超卖,多数开发者第一反应是加锁。课程中提到了使用JDK内置的synchronized或ReentrantLock。确实,在单机环境下,同步锁能保证同一时刻只有一个线程执行扣减逻辑,从而避免超卖。但诸葛老师随即抛出疑问:在高并发场景下,加锁会不会带来性能问题?
答案是肯定的。锁的粒度、等待时间、上下文切换都会成为瓶颈,尤其当锁竞争激烈时,吞吐量急剧下降。更严重的是,如果锁使用不当(如锁未释放、锁顺序不一致),还可能引发死锁。此外,单机锁无法应对分布式部署,多个服务实例同时扣减库存时,仍会超卖。因此,分布式锁成为必然选择,而Redis正是实现分布式锁的常用工具。
Redis 分布式锁的实现要点
用 Redis 实现分布式锁,核心是 SET key value NX PX timeout 这一条命令:NX 保证只有键不存在时才设置成功(即抢到锁),PX 给锁设置过期时间,避免持有者宕机后锁永不释放。但仅有这两点还不够,必须解决两个经典问题:一是“误删他人锁”——释放锁时要先比对 value(通常用 UUID 标识持有者)再删除,且比对与删除需用 Lua 脚本保证原子;二是“锁过期但业务未完成”——可通过看门狗机制定期续期,Redisson 的 RLock 即封装了这套逻辑。此外还需考虑锁的可重入性与 Redlock 的争议。课程强调分布式锁是必然选择,而选型时自研轻量脚本还是直接引入 Redisson,取决于团队对可维护性与功能完备性的取舍。
缓存穿透与击穿:高并发下的另两大隐患
除了超卖,课程还重点讨论了缓存穿透和缓存击穿。缓存穿透是指查询不存在的数据,请求直接落到数据库,通常可通过布隆过滤器或缓存空值解决;缓存击穿则是指热点key过期瞬间,大量请求涌入数据库,可通过互斥锁或永不过期策略缓解。诸葛老师结合京东秒杀页面的实际场景,说明了这些问题的触发条件与应对方案,并指出Redis在高并发场景下的配置优化(如连接池、持久化策略)同样不容忽视。
多源分析显示,不同技术博主对缓存问题的解决方案存在共识:布隆过滤器和互斥锁是主流手段,但在具体实现上,有的推荐使用Redisson,有的建议自研轻量级方案。诸葛老师的课程更偏向实战,强调根据业务特点选择合适方案,而非盲目套用。
布隆过滤器与缓存雪崩的区分
布隆过滤器是一种空间效率极高的概率型数据结构,用位数组加多个哈希函数判断“某元素是否可能存在”:返回“不存在”则一定不存在,返回“存在”则可能误判。它适合在缓存穿透场景中做前置拦截,把大量查询不存在 key 的请求挡在数据库之外,代价是有一定误判率且不支持删除元素。另需注意缓存击穿与缓存雪崩的区别:击穿是单个热点 key 失效引发的瞬时冲击,雪崩则是大批 key 在同一时刻集中过期或 Redis 整体宕机,后者需要通过过期时间加随机偏移、多级缓存、限流降级等手段综合治理。三者诱因不同,应对策略也不可混用。
多Agent AI工程化:后端开发的新战场
课程的另一大板块是多Agent智能体开发。随着AI应用深入,后端系统需要支撑多个Agent协同工作,这对并发处理、任务调度、状态管理提出了新要求。诸葛老师结合自身在唯品会、京东的经验,分享了如何将高并发架构思想迁移到多Agent场景,例如使用Redis作为Agent间通信的缓存层,或利用分布式锁保证任务执行的幂等性。虽然这部分内容在原始素材中着墨不多,但作为课程亮点,为后端开发者提供了新的视角。
多 Agent 协同中的幂等与状态管理
多 Agent 系统通常由一个编排器把任务拆分给多个子 Agent 并行执行,再汇总结果,这与秒杀链路在结构上高度相似:都存在并发竞争、重复执行和状态一致性问题。工程化落地的关键有两点。其一是幂等性——Agent 任务可能因重试或超时被重复触发,需借助分布式锁或唯一任务 ID 保证同一任务只被执行一次,避免副作用叠加。其二是状态管理——Agent 间的中间结果、会话上下文需要有共享存储,Redis 的字符串、哈希与 Stream 结构可分别承担缓存、状态快照与消息队列的角色。把高并发系统中“原子性、幂等、状态隔离”的思路迁移过来,能显著降低多 Agent 编排的复杂度。
总结与建议
这节公开课从一个小案例切入,层层递进,覆盖了秒杀系统中最常见的坑点。对于后端开发者而言,理解超卖的本质、掌握分布式锁的正确用法、熟悉缓存问题的应对策略,是构建高并发系统的基本功。同时,多Agent AI工程化作为新兴方向,值得持续关注。诸葛老师还提供了面试资料和书籍,适合系统性查漏补缺。整体来看,课程内容实战性强,适合有一定Java基础、希望深入高并发领域的开发者。
相关推荐
Pi Agent极简设计哲学:让开发者自己写插件拦截危险命令
Pi Agent以极简内核加插件扩展的设计路线获得开发者关注。本文解析其与Codex、Claude Code的差异,以及如何通过自定义插件拦截危险命令、实现项目长期记忆。
黄仁勋辞任英伟达CEO,CFO临时接棒
英伟达董事会宣布CEO黄仁勋因婚外情报道辞职,即刻生效,CFO科莱特·克雷斯出任临时CEO,公司首次设立董事会主席并由前Synopsys CEO哈维·琼斯担任,正式CEO遴选已启动。
胡椒如何征服全球餐桌:一部香料贸易与饮食文化史
从印度马拉巴尔海岸的古老种植,到里斯本海难中民众争抢胡椒粒,再到哥伦布误将辣椒当作胡椒——追溯黑胡椒如何经丝绸之路与大航海时代成为全球餐桌标配,并揭示其占全球香料贸易20%背后的贸易战争与文化变迁。