RefCraft基准:视觉参考驱动的AI网页生成仅52分

新基准RefCraft揭示AI智能体视觉参考网页开发最高仅52分,多模态理解成瓶颈。
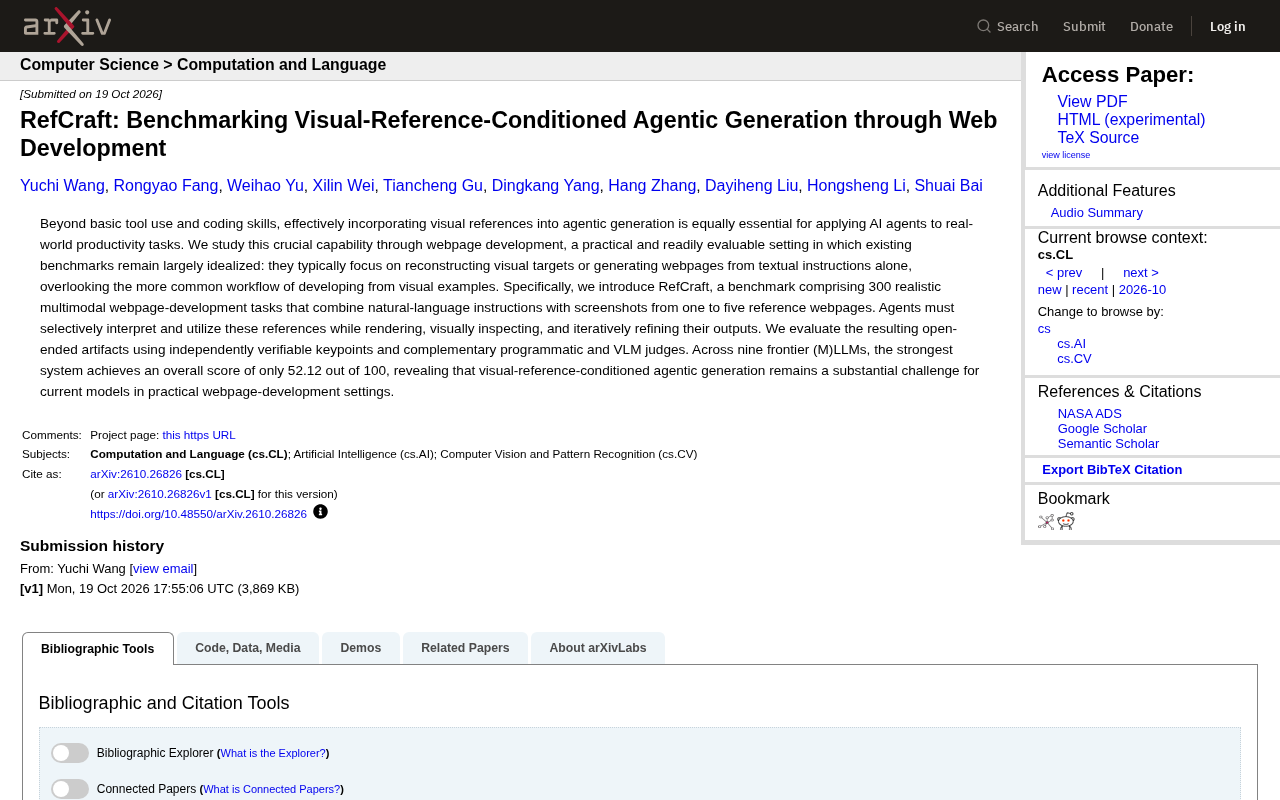
研究论文提出RefCraft基准,包含300个融合自然语言指令与1-5张参考截图的真实网页开发任务,模拟开发者参考设计图进行创造性开发的 workflow。评估采用关键点、程序化评判与VLM评判相结合的方式。对九个前沿多模态大模型的测试显示,最高分仅52.12分(百分制),表明视觉参考条件化的智能体生成仍是巨大挑战。模型在从多张参考中提取融合信息、利用视觉反馈迭代优化方面表现不足。研究指出,提升多模态理解与视觉参考整合能力是AI智能体成为生产力工具的关键。
AI智能体在网页开发中如何利用视觉参考?最新研究显示,即便最强模型也仅得52分。
研究背景:从理想化到真实工作流
现有网页开发基准大多简化了真实场景:它们要么只要求从文本指令生成页面,要么给定目标截图进行重建。然而,真实工作中更常见的流程是——开发者获得若干参考网页截图,结合自然语言需求,创造性地开发新页面。这种“视觉参考条件化生成”能力,对AI智能体落地生产力场景至关重要。
据研究论文《RefCraft: Benchmarking Visual-Reference-Conditioned Agentic Generation through Web Development》指出,当前基准忽略了这一常见工作流。为此,研究者提出了RefCraft,一个包含300个真实多模态网页开发任务的基准,每个任务融合了自然语言指令和1至5张参考网页截图。智能体需要选择性解读并利用这些参考,同时进行渲染、视觉检查和迭代优化。
视觉参考条件化生成(Visual-Reference-Conditioned Generation)指模型在生成内容时,不仅依赖文本指令,还需从一张或多张参考图像中提取视觉信息(如布局、配色、组件样式、交互模式),并将其有选择地融入输出。与“截图重建”任务不同,参考图并非要逐像素复现的目标,而是设计灵感的来源,模型需判断哪些元素可借鉴、哪些需根据文本需求创新。这种能力要求模型具备跨模态对齐、视觉元素解耦与重组、以及意图理解等综合能力,是智能体从“代码生成器”迈向“协作开发者”的关键一步。
RefCraft基准设计:多模态任务与综合评估
RefCraft的核心在于模拟真实开发场景的复杂性。每个任务都提供文本指令和视觉参考,要求智能体不仅理解指令,还要从参考截图中提取设计元素、布局逻辑或交互模式,并将其应用到新页面的生成中。智能体需要像人类开发者一样,反复渲染输出、视觉比对、调整代码。
评估方面,研究团队采用了可独立验证的关键点(keypoints)以及互补的程序化评判和视觉语言模型(VLM)评判。这种组合既保证了评估的客观性,又兼顾了视觉输出的主观质量。
关键点(keypoints)评估是一种将开放式生成任务分解为若干可独立验证的检查项的方法。每个关键点对应一个具体的功能或视觉要求(如“导航栏包含搜索框”“按钮悬停变色”),评估时逐项判断是否满足,从而将主观的整体质量转化为可量化的通过率。程序化评判通过自动化脚本(如DOM结构检查、截图像素比对、交互模拟)验证关键点;视觉语言模型(VLM)评判则利用多模态大模型对渲染结果进行语义和美学层面的打分。两者互补:程序化评判客观可复现,VLM评判能捕捉布局协调性、视觉一致性等难以规则化的维度,共同构成对智能体生成质量的综合度量。
九大前沿模型测评:最高分仅52.12
研究者对九个前沿的(多模态)大语言模型进行了测试。结果显示,最强系统在100分制下仅获得52.12分。这一成绩表明,视觉参考条件化的智能体生成在当前模型中仍是一个巨大挑战。模型在理解参考意图、选择性应用视觉元素、以及迭代优化方面表现不足,距离实际生产力应用还有明显差距。
智能体迭代优化(agentic iterative refinement)指模型在生成初步页面后,通过渲染截图、视觉比对、定位差异并修改代码的循环过程逐步逼近目标。这一过程依赖两个核心能力:一是视觉反馈利用,即模型能否从渲染结果中准确识别与参考图或需求的偏差(如间距不当、颜色不符、元素错位);二是自我修正策略,即根据偏差生成有效的代码修改而非盲目重试。RefCraft的任务设计强制要求多轮迭代,而现有模型往往在首轮生成后难以从视觉反馈中提取有效信号,导致迭代收益有限,这是得分偏低的重要原因之一。
挑战与启示:视觉参考理解是关键瓶颈
RefCraft的低分揭示了几个关键问题。首先,模型难以从多张参考截图中提取并融合相关信息,往往过度依赖文本指令或简单复制参考。其次,迭代优化环节中,模型缺乏有效的视觉反馈利用能力,导致输出与预期存在偏差。此外,开放式生成任务的评估本身具有挑战性,但RefCraft通过关键点和双评判机制提供了可复现的衡量标准。
这项研究提醒我们,要让AI智能体真正成为生产力工具,仅提升代码生成能力是不够的,还需加强多模态理解与视觉参考的整合能力。未来,随着基准的推广和模型的迭代,这一领域有望取得突破。
更多细节可参阅原论文。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。