Reflection AI首个开源权重模型Beam登陆Ollama:100万上下文免费开放
Reflection AI开放权重模型Beam上线Ollama Cloud,限时免费,主打百万token上下文与编程智能体。
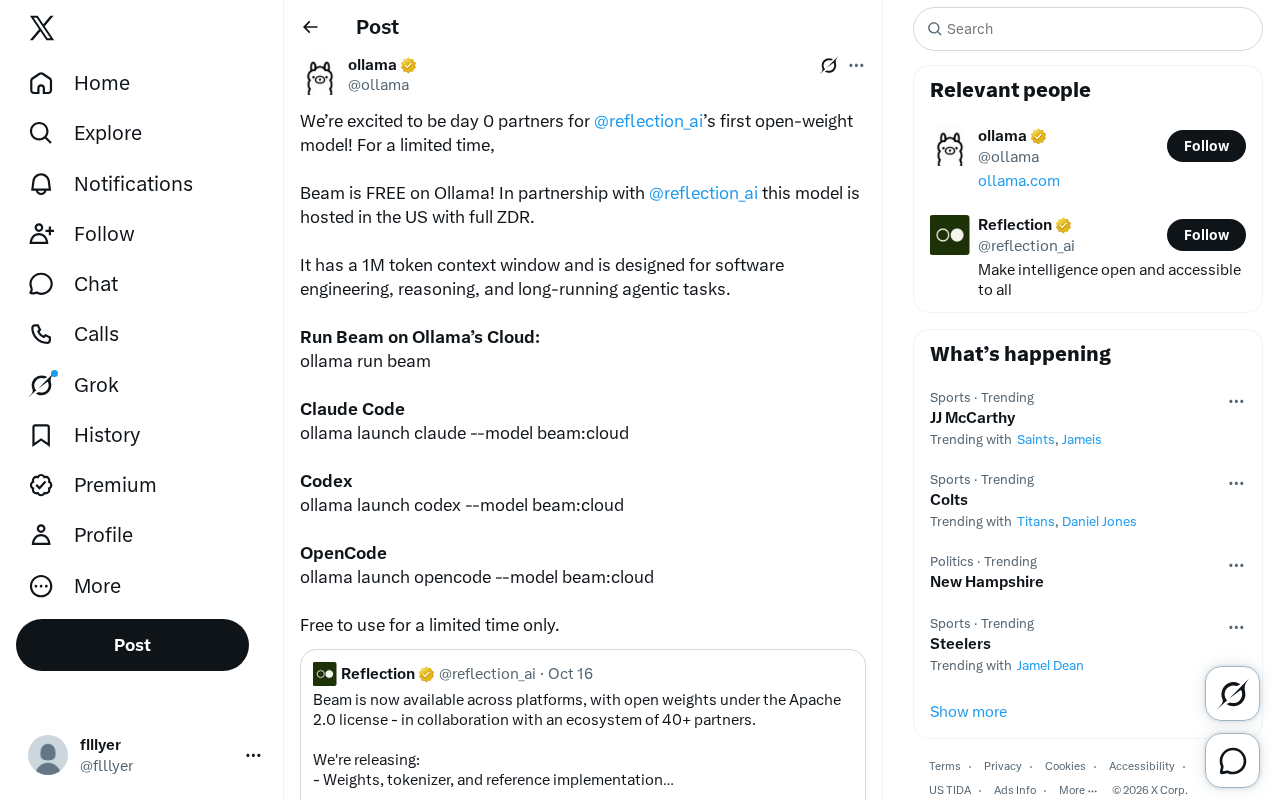
Reflection AI首个开放权重模型Beam正式上线Ollama Cloud,限时免费开放。该模型并非通用聊天模型,而是针对软件工程、推理和长时智能体任务优化,具备100万token上下文窗口,可在单次会话中容纳大型代码库与长对话。开发者通过一条命令即可运行,并支持直接接入Claude Code、Codex和OpenCode等主流编程CLI工具。Beam托管在美国并承诺完全零数据留存(ZDR),回应企业隐私顾虑。Ollama以Day 0合作伙伴身份首发支持,体现其从本地运行工具向云端模型分发平台延伸。模型参数规模与基准成绩尚未披露,实际能力有待验证。
Ollama与Reflection AI达成合作,后者首个开放权重模型Beam正式上线Ollama Cloud,限时免费开放使用。这一消息由Ollama官方在社交平台率先公布,核心亮点在于100万token的上下文窗口、面向软件工程与长时智能体任务的定位,以及托管在美国且支持完全零数据留存(ZDR)的隐私承诺。
模型定位:为软件工程与长时智能体而生
据Ollama官方描述,Beam并非通用聊天模型,而是明确针对三类场景优化:软件工程、推理以及长时运行的智能体任务(long-running agentic tasks)。这一定位与当前AI编程工具链的演进方向高度吻合——开发者需要的不仅是一次性生成代码,而是能持续理解大型代码库、跨文件推理、并在多轮工具调用中保持上下文连贯的模型。
100万token的上下文窗口是这一目标的技术基础。对于中型乃至大型代码仓库,这意味着模型可以在单次会话中容纳更多源文件、文档与历史对话,减少因上下文截断导致的推理断裂。不过说一下,Ollama的公告并未披露Beam的参数规模、训练数据构成或基准测试成绩,因此其实际能力仍需开发者上手验证。
长时智能体任务(long-running agentic tasks) 指的是模型需要在一个持续较长的会话中,自主完成多步骤、多工具调用的复杂目标,例如自动修复一个跨越多个文件的 bug、根据需求迭代生成并测试代码,或在仓库中执行一系列搜索、编辑与验证操作。这类任务对模型的要求远超单轮问答:它必须在数十甚至上百次交互中保持目标一致性,正确累积中间结果,并在上下文不断膨胀时仍能准确引用早期信息。因此,百万级 token 上下文窗口成为支撑此类任务的关键基础设施,而不仅仅是参数上的卖点。
三大编程工具开箱即用
接入方式延续了Ollama一贯的命令行风格,开发者只需一条命令即可在Ollama Cloud上运行Beam:
ollama run beam
针对主流AI编程CLI工具,Ollama还提供了直接启动命令:
- Claude Code:
ollama launch claude --model beam:cloud - Codex:
ollama launch codex --model beam:cloud - OpenCode:
ollama launch opencode --model beam:cloud
这种“模型+工具”的打包启动方式,降低了开发者尝试新模型的摩擦成本。对于已经在使用Claude Code或Codex工作流的团队,切换到Beam只需修改一个模型参数,便于做横向对比测试。
限时免费与ZDR隐私承诺
公告中两个商业层面的信息值得关注。其一是限时免费:Beam在Ollama上免费开放,但Ollama明确表示“仅限时”(for a limited time only),未给出具体截止日期,这意味着免费窗口的关闭可能较为突然,有评估需求的开发者应尽早测试。
其二是数据隐私。Ollama强调该模型托管在美国,并支持完全ZDR(Zero Data Retention,零数据留存)。对于处理私有代码库的企业开发者而言,数据是否被留存用于训练是选型的核心顾虑之一,ZDR承诺在一定程度上回应了这一担忧。不过ZDR的具体执行范围(是否涵盖日志、推理中间结果等)公告未作细化,企业采购前仍建议向服务方确认合规细节。
零数据留存(ZDR,Zero Data Retention) 是一种数据治理承诺,指服务提供商在处理用户请求后,不持久化保存提示词、模型输出及相关交互记录,也不会将其用于模型训练或人工审核。对于企业开发者而言,ZDR 与常规的“数据不用于训练”条款不同:后者可能仍保留日志用于运维或滥用检测,而 ZDR 要求更彻底地即时丢弃。不过,ZDR 的具体边界——是否涵盖系统日志、错误追踪、计费元数据或推理中间状态——通常由服务协议细化,不同厂商的实现范围差异较大,这也是企业合规评估时需要逐项确认的地方。
开放权重模型竞争的新信号
Reflection AI选择以“开放权重+云托管”组合切入市场,而非纯本地部署或纯闭源API,这条路线在当下颇具代表性。开放权重降低了模型被单一平台锁定的风险,云托管则解决了大上下文模型对本地显存的苛刻要求——100万token上下文在消费级硬件上几乎不可行,云端推理是现实选择。
从生态角度看,Ollama以“Day 0合作伙伴”身份首发支持,说明其正在从本地模型运行工具向云端模型分发平台延伸。对开发者社区而言,多一个具备长上下文能力且限时免费的编程模型选项,本身就是值得关注的变量。至于Beam能否在代码生成质量上挑战现有主流模型,还需要真实项目中的对比数据来回答。
开放权重(open-weight) 指模型的训练参数可公开下载,使用者可以在本地或自有基础设施上部署和运行,但训练数据、训练代码和完整训练流程未必公开,因此它不等同于完全开源的模型。与闭源 API 相比,开放权重降低了平台锁定风险,允许社区微调和独立审计;与纯本地部署相比,云托管开放权重模型则绕开了大上下文模型对显存的苛刻要求。Reflection AI 采用的“开放权重+云托管”组合,正是试图在开放性与可及性之间取得平衡,这也是当前模型分发的一种典型折中路线。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
LLM应用越改越糟?三步构建有效评估体系
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。