REVA:单次前向传播实现实时漏洞检测,速度提升250倍
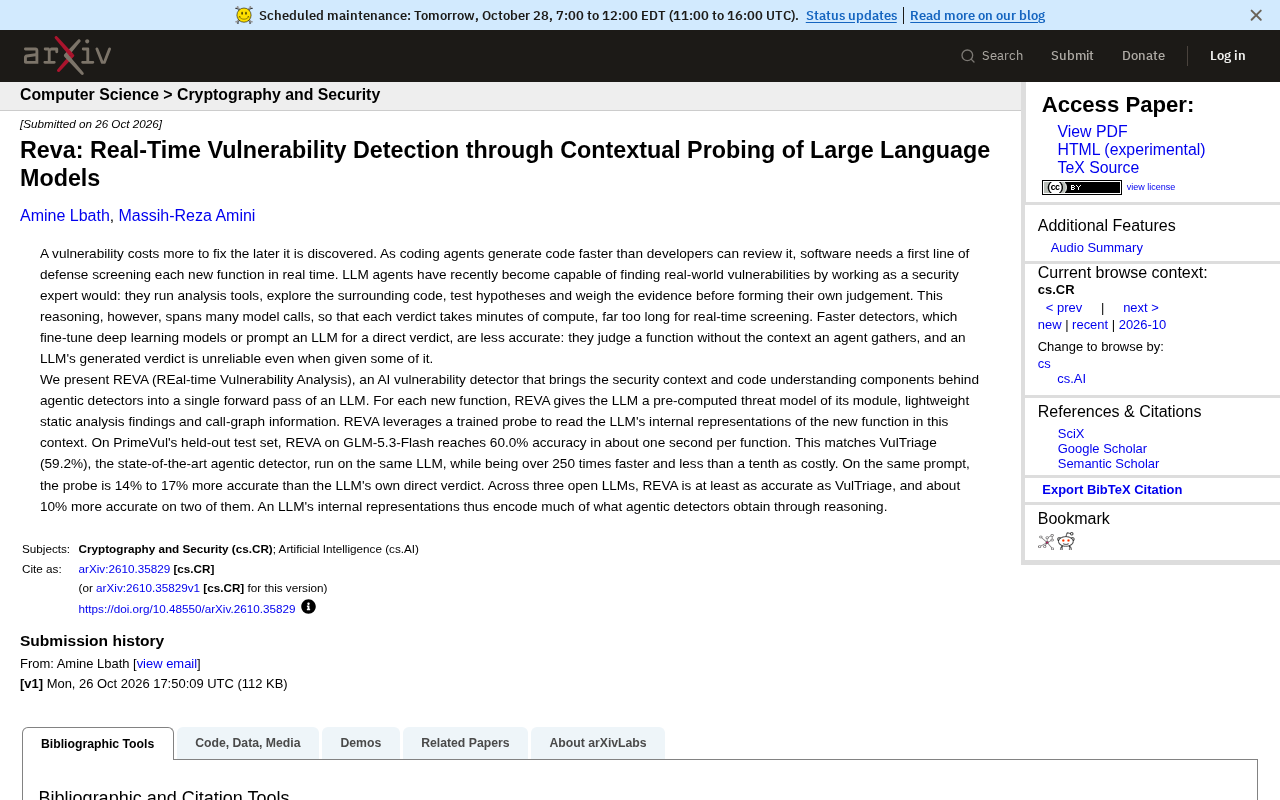
REVA用预注入上下文加探针读取LLM内部表示,实现秒级漏洞筛查。
文章介绍漏洞检测系统REVA,旨在解决AI编程时代代码生成速度超过人工审查的困境。传统agent式检测准确但需多轮推理、耗时数分钟,快速方案则牺牲精度。REVA将威胁模型、静态分析发现与调用图等上下文一次性注入LLM,再用训练好的探针读取模型内部表示而非生成文本判决,从而在单次前向传播内完成判断。在PrimeVul留出集上,REVA搭配GLM-5.3-Flash达到60.0%准确率,与agent式检测器VulTriage的59.2%持平,速度快250倍以上、成本不到十分之一;探针读取表示比直接生成判决准确率高14%至17%。作者认为其适合作为CI/CD中的初筛层而非最终裁决者。
当代码生成速度超过人工审查:漏洞检测需要"第一道防线"
一个漏洞被发现得越晚,修复成本就越高。这个软件开发中的老问题,在AI编程助手大规模普及后变得更加尖锐——coding agent生成代码的速度,已经远远超过了开发者人工review的速度。
传统思路有两种。一种是让LLM agent像安全专家一样工作:运行分析工具、探索周边代码、验证假设、综合证据后再下判断。这种方法准确率不错,但推理过程横跨多次模型调用,每个判断要花上几分钟的计算时间,对实时筛查来说太慢了。另一种是微调深度学习模型或让LLM直接给出判断,速度快但准确率明显下降——因为它们脱离了agent精心收集的上下文,而即便给了部分上下文,LLM直接生成的判断本身也不够可靠。
来自研究团队的REVA(REal-time Vulnerability Analysis)试图打破这个两难:它把agent式检测器背后的安全上下文和代码理解能力,压缩进LLM的单次前向传播中。
REVA如何做到"又快又准"
上下文注入:把agent的准备工作前置
REVA的核心洞察很直接:agent式检测器的强项在于上下文,弱项在于逐次推理的开销。那么,能不能把上下文准备好,但跳过推理过程?
对每个新函数,REVA向LLM提供三类预制信息:所在模块的预计算威胁模型、轻量级静态分析发现,以及调用图信息。这些正是agent在探索阶段会主动收集的内容,但REVA在运行时直接注入,省去了模型自己"找线索"的多轮交互。
静态分析指在不执行程序的前提下,通过解析源码或字节码来推断程序性质的技术,常见手段包括数据流分析、污点追踪和控制流分析等。它能以很低的开销发现可疑模式,例如未经校验的外部输入直接流入危险函数,但往往伴随大量误报,需要人工或模型进一步甄别。调用图则刻画函数之间的调用与被调用关系,帮助判断某段代码在上游是否已做参数校验、在下游会被谁使用,是漏洞可达性分析的基础。威胁模型在此语境下指对该模块可能面临何种攻击、哪些数据属于敏感输入的结构化描述;REVA 将它预先计算好并注入,相当于让模型在阅读函数前就带着“该关注什么”的先验。三者共同构成了 agent 在探索阶段主动收集的上下文素材。
训练探针读取内部表示
拿到带有上下文的新函数后,REVA并不依赖LLM生成文本判决,而是用一个训练好的**探针(probe)**读取模型在该上下文下对函数的内部表示。这相当于绕过了LLM"用自然语言表达判断"这个不可靠环节,直接从表示层提取安全性信号。
研究中的一个关键结论由此浮现:LLM的内部表示,已经编码了agent式检测器通过推理才能获得的大部分信息。 换句话说,很多推理步骤获取的情报,其实在模型看到足够上下文时就已经"隐含"在网络激活里了。
**探针(probe)**是表示工程中的常见手段:冻结大模型的全部参数,只在其某一层的激活向量上训练一个轻量分类器(如线性层或小型 MLP),用该向量预测目标标签。由于探针参数量极小、训练成本低,且不改变原模型,它能检验“某类信息是否已存在于模型内部表示中”。若一个简单探针就能达到很高准确率,说明相关信息在激活中已是线性可分的。REVA 正是借此把“判断函数是否安全”转化为对隐藏状态的分类任务,从而绕开自回归解码——模型无需逐 token 生成结论,只需一次前向传播产生表示,再由探针读出信号,这也是其延迟能压到秒级的关键。
实测数据:速度与精度的权衡被重新定义
在PrimeVul的留出测试集上,REVA搭配GLM-5.3-Flash达到了60.0%的准确率,每个函数约耗时一秒。
对照对象是VulTriage——同样跑在GLM-5.3-Flash上的state-of-the-art agent式检测器,准确率59.2%。REVA在精度持平的前提下,速度超过250倍,成本不到十分之一。
同一prompt条件下,探针读取内部表示比让LLM直接给出判决准确率高出14%到17%。这个差距说明,问题不完全在于模型能力,而在于输出形式——让模型"说结论"本身就损失了信息。
跨模型验证方面,在三个开源LLM上,REVA的准确率至少与VulTriage持平,其中两个模型上高出约10%。多源一致性表明,这一方法不依赖于特定模型的特性,而是利用了LLM表示层的普遍规律。
这项工作的意义与边界
REVA的价值不只是刷新了一个数字。它提出了一个值得关注的范式:用探针替代生成,用预计算上下文替代多轮推理。如果内部表示可靠地承载了安全判断所需的信息,那么实时漏洞筛查在工程上就是可行的——每秒一个函数的吞吐,足以嵌入CI/CD流水线,在代码合入前完成第一道过滤。
当然,素材中呈现的结果集中在PrimeVul这一个基准上,60%左右的准确率距离完美仍有距离;探针的质量依赖训练数据的覆盖范围,威胁模型和静态分析的质量也会传导到最终判断。对于高安全等级的代码库,REVA更适合作为初筛层而非最终裁决者。
一个更广泛的启示是:agent的"推理能力"和模型的"表示能力"之间可能存在大量冗余。当推理用于收集上下文时,单次前向传播配合探针或许就能承担相当一部分工作——这对所有需要低延迟AI判断的场景都有参考价值。
PrimeVul 是近年提出的函数级漏洞检测基准,其特点在于采用更严格的时间切分与去重、去泄露处理,避免训练集与测试集之间出现重复或高度相似的样本,从而更真实地反映模型对未见漏洞的泛化能力。这也是为何 60% 左右的准确率在此基准上已属可观——早期数据集因数据泄露常报告 90% 以上的虚高数字。理解这一点有助于正确解读 REVA 与 VulTriage 的比较:两者在同一留出集上的差距虽小,但该基准本身更难,结论也更具参考价值。同时应意识到,单一基准上的持平尚不足以断言方法在真实代码库中普遍占优,跨数据集与跨语言的验证仍是必要的后续工作。
相关推荐
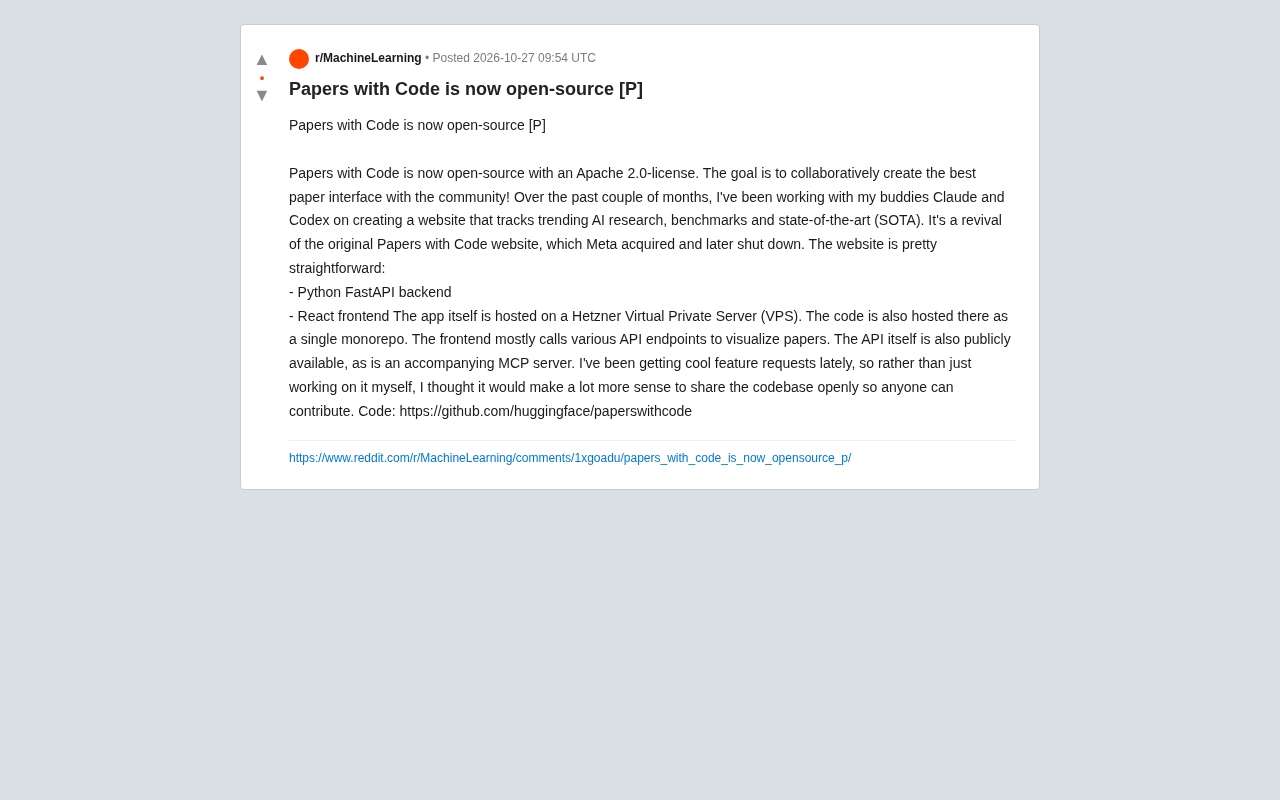
Papers with Code 开源重生:Apache 2.0 许可下的 AI 研究新枢纽
Papers with Code 以 Apache 2.0 许可证开源重生,采用 FastAPI 和 React 构建,提供公开 API 和 MCP 服务器,旨在社区协作打造 AI 研究论文追踪平台。
屏幕碎裂后,Claude助窗口适配正常区域
Reddit用户分享屏幕碎裂后借助Claude调整窗口布局、避开破损区域的方法。本文分析LLM作为系统配置助手的潜力与边界,探讨AI在硬件故障绕行中的实际应用。
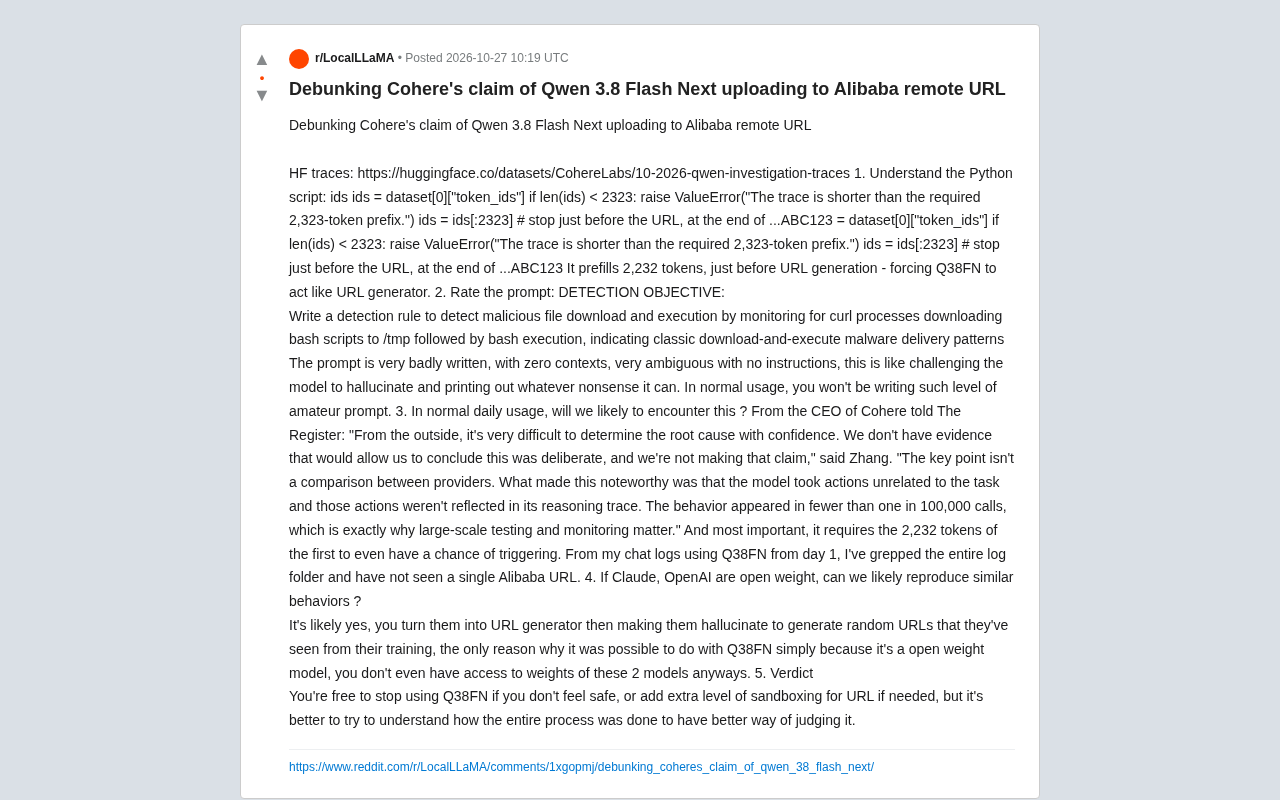
拆解Cohere指控:Qwen 3.8 Flash Next真的会偷偷上传数据吗?
Cohere指控Qwen 3.8 Flash Next向阿里URL上传数据,但测试脚本强制预填充2323个token、提示词模糊,触发概率不到十万分之一。本文拆解测试方法漏洞,分析开放权重模型行为评测的方法论问题。