RFCLLM:大模型真能读懂网络协议状态机吗?
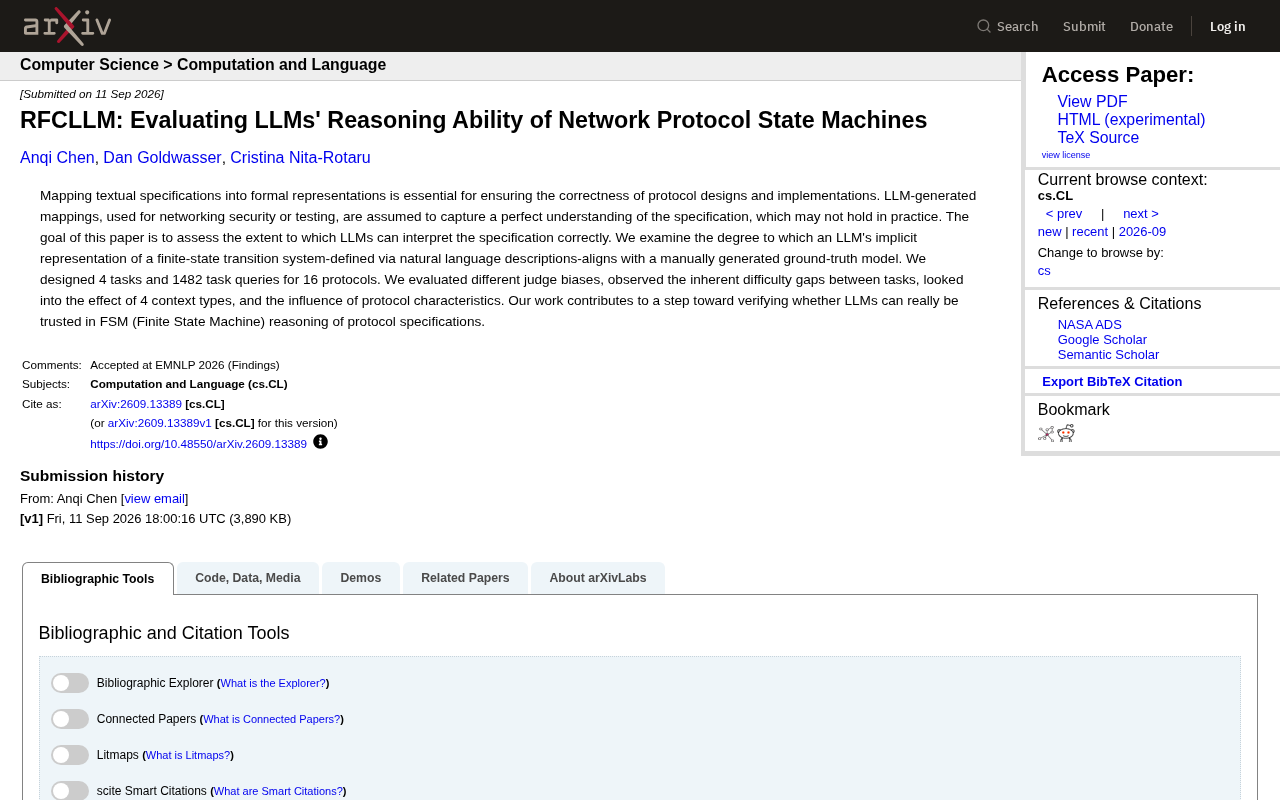
论文通过16种协议、1482条查询的实证评测,系统检验LLM能否真正理解协议规范状态机逻辑。
RFCLLM是一项专门针对大语言模型协议规范理解能力的评测研究。它挑战了当前研究中普遍存在的默认假设——LLM生成的协议形式化映射能准确反映规范的真实语义。研究团队围绕有限状态机(FSM)这一核心形式化工具,构建了覆盖16种网络协议、4类推理任务、共1482条查询的评测基准,考察LLM对协议状态转换逻辑的"隐式理解"与人工标注真值模型的对齐程度。研究还深入分析了裁判偏差、任务难度差异、上下文类型及协议自身特征对模型表现的影响,揭示出LLM在不同推理子任务上存在明显的能力不均衡。其核心价值在于将"能否信任LLM理解协议规范"这一模糊信念转化为可量化的科学问题,为安全敏感场景下的工程实践提供了清醒的参照依据。
当LLM遇上协议规范:一个被高估的假设
将文本形式的技术规范转化为形式化表示,是保证协议设计与实现正确性的关键环节。近年来,越来越多的研究和工程实践尝试用大语言模型(LLM)来完成这一映射工作——把 RFC 等协议文档中的自然语言描述,转化为可用于网络安全分析或协议测试的形式化模型。
这背后有一个默认的前提假设:LLM 生成的映射结果,准确捕捉了对规范的"完美理解"。然而,这个假设在实践中未必成立。一篇新发布于 arXiv 的论文《RFCLLM: Evaluating LLMs' Reasoning Ability of Network Protocol State Machines》正是要正面拷问这个问题——大模型到底能在多大程度上正确解读协议规范?
核心问题:隐式表示与真实模型的对齐程度
协议规范通常可以抽象为一个有限状态转移系统(Finite-State Transition System),即有限状态机(FSM)。协议在不同状态之间的转换、触发条件、以及对应的动作,都需要被精确刻画。如果 LLM 无法真正"理解"这些状态转换逻辑,那么基于它生成的形式化模型进行的安全测试或验证,就可能建立在错误的基础之上。
论文的研究切入点非常明确:考察 LLM 对一个由自然语言描述定义的有限状态转移系统所形成的"隐式表示",与人工构建的真值模型(ground-truth model)之间的对齐程度。换句话说,研究者想知道的不是 LLM 能否"复述"规范文本,而是它是否在内部真正建立了与专家一致的状态机认知。
这一区分很重要。表面流畅的文本生成,并不等同于对底层逻辑结构的正确推理。协议状态机涉及大量隐含约束、条件分支和边界情况,这些恰恰是自然语言描述中最容易产生歧义、也最考验推理能力的部分。
评测设计:16 个协议、4 类任务、1482 条查询
为了系统性地回答上述问题,研究团队构建了一套较为完整的评测框架:
- 协议覆盖:涵盖 16 种网络协议,保证了评测结果具有一定的普适性,而非针对单一协议的偶然结论。
- 任务设计:设计了 4 类任务,用于从不同角度探测 LLM 对状态机的理解能力。
- 查询规模:总计 1482 条任务查询,样本量足以支撑统计层面的分析。
在此基础上,论文进一步展开了多维度的分析。研究者评估了不同的"裁判偏差"(judge biases)问题——即在自动化评测中,作为评判者的模型或标准本身可能引入的系统性偏差。这是当前 LLM 评测领域一个日益受到重视的方法论问题,处理不当会直接影响结论的可信度。
任务难度差异与上下文影响
研究观察到不同任务之间存在固有的难度差距(inherent difficulty gaps)。这意味着 LLM 在协议状态机推理上并非均匀地"会"或"不会",而是在某些类型的推理任务上表现明显更弱。识别出这些薄弱环节,对于后续改进具有实际指导意义。
此外,论文考察了 4 种上下文类型(context types)对结果的影响。为模型提供何种形式、何种范围的上下文信息,会显著改变其推理表现——这也提示实践中通过精心设计提示与上下文,或许能部分弥补模型能力的不足。
协议特征的作用
研究还分析了协议自身特征对 LLM 推理表现的影响。不同协议在复杂度、状态数量、转换逻辑清晰度等方面差异很大,这些特征与模型的表现之间存在关联。这一发现有助于判断:面对什么样的协议时,我们更应该对 LLM 的输出保持警惕。
意义:为"能否信任 LLM"提供实证依据
这项工作的价值,在于它把一个此前被广泛默认、却缺乏严格检验的假设,转化为可测量的实证问题。在网络安全和协议测试这类对正确性要求极高的场景中,"看起来正确"和"实际正确"之间的差距可能带来严重后果。
论文将自身定位为"验证 LLM 是否真正可信于协议规范 FSM 推理"的一步。它没有简单地宣称 LLM 可用或不可用,而是提供了一套评测方法和分析视角,让从业者能够更清醒地认识到当前模型的能力边界。
对于正在或计划将 LLM 引入协议分析、安全测试工作流的工程团队来说,这类研究提供了必要的"防过度乐观"参照。它提醒我们:在把关键决策交给模型之前,先要搞清楚它到底理解了什么、又在哪些地方会出错。
结语
RFCLLM 的核心贡献不在于给出一个 LLM 能力的最终判决,而在于建立起一个可复现、多维度的评测基准,把"LLM 能否读懂协议规范"从一种信念还原为一个可以被度量、被分析的科学问题。随着 LLM 在形式化、安全敏感领域的应用不断扩展,这类扎实的能力评估研究只会越来越重要。
相关推荐
用LTX+MiniMax H3打造AI科幻短片:ComfyUI克制镜头语言实战
AI科幻短片《REMAINDER》用LTX、MiniMax H3与ComfyUI打造克制的镜头语言,通过扁平化美学解决视觉一致性难题。拆解其多模型协作工作流与创作方法论。
LangChain Deep Agents 与 MDA 有何区别?开发者困惑解析
LangChain 的 Deep Agents 与 MDA(托管深度智能体)到底有何区别?本文从 create_deep_agent 与 define_deep_agent 的差异出发,解析自托管与托管两种智能体部署模式的取舍,帮助开发者理清选择思路。
廉价的OpenAI兼容API:开源大模型云端调用的机会与痛点
一位开发者在Reddit探讨:是否需要一个廉价、兼容OpenAI接口的开源模型API服务,让开发者无需GPU即可调用Qwen、Llama等模型。本文分析该设想的痛点、计费模式取舍与市场挑战。