日本二手书店销量暴涨5倍:AI训练数据抢购潮背后

日本二手书店销量暴增5倍,书籍或被AI公司按吨采购用于大模型训练语料。
Hacker News近期报道显示,日本二手书店出现书籍被"按吨"成批买走的异常现象,销量激增约5倍。社区普遍推测,采购方是寻求高质量日文训练语料的AI机构——互联网公开数据质量持续下滑,而正式出版的实体书语言规范、知识密度高,恰好填补这一缺口。日本著作权法对AI训练数据使用的相对宽松态度,进一步增加了在当地采购的吸引力。文章指出,这一现象折射出AI数据竞赛已白热化:机构开始转向线下、传统媒介挖掘增量语料,作者与出版商的劳动成果被"物料化"却未必获得补偿。目前采购方身份未经证实,应将其视为值得持续追踪的行业信号。
一则不寻常的市场信号
近日一则来自Hacker News的报道引发关注:日本的二手书店销量出现了5倍的激增,书籍正被以"吨"为单位成批买走。这种以重量而非册数计价的采购方式本身就透露出反常——普通读者不会按吨购书,只有需要海量文本内容的机构才会如此操作。
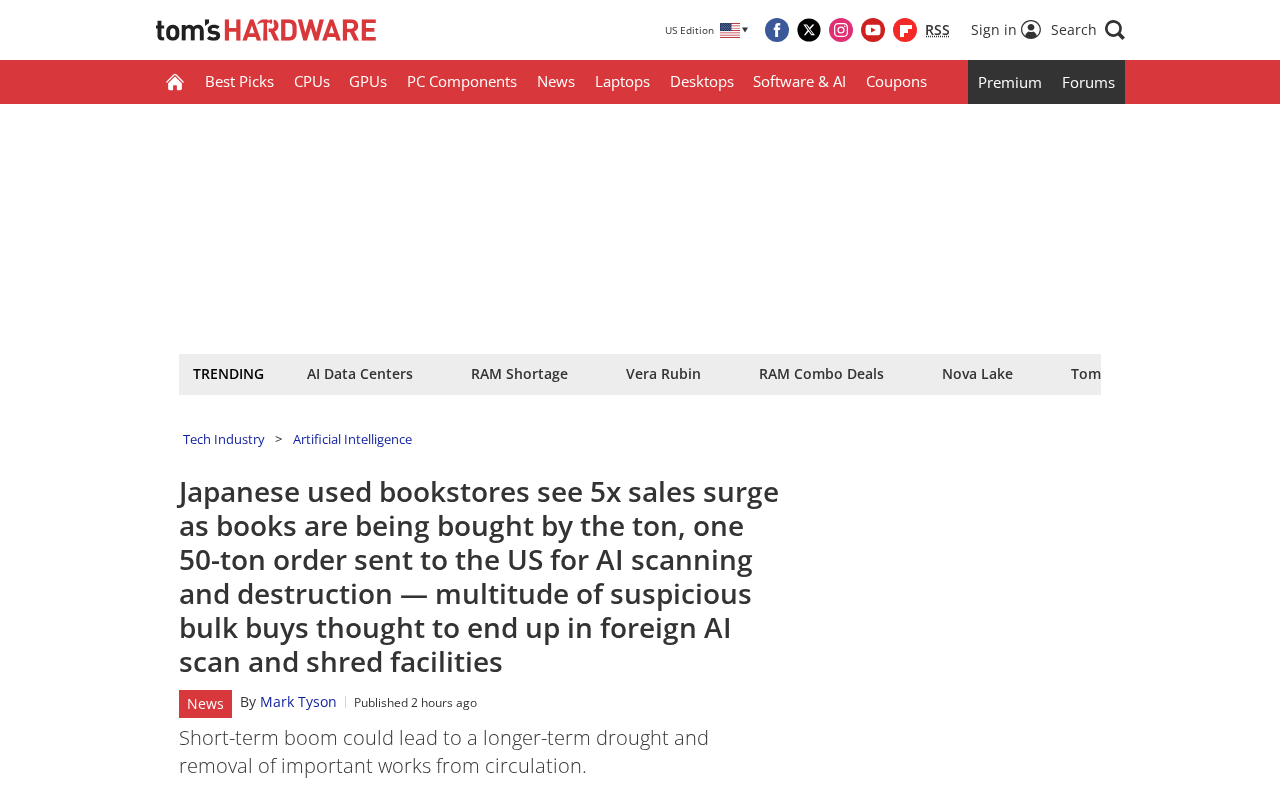
尽管原始报道信息有限(Hacker News 上获得42个赞和20条评论),但社区讨论普遍将矛头指向了一个显而易见的推测:这些书籍很可能被用于AI大模型的训练数据采集。在版权与数据合规日益收紧的当下,物理书籍作为高质量、结构化文本的来源,正重新获得价值。
为什么实体书成了"香饽饽"
优质语料的稀缺性
大语言模型的训练高度依赖高质量文本。互联网公开数据经过多轮抓取后,边际质量正在下降,且充斥着重复、低质和机器生成的内容。相比之下,正式出版的书籍经过编辑、校对和排版,语言规范、知识密度高,是训练语料中的"精品"。
日文作为一种非英语语种,其高质量网络语料本就相对稀缺。对于希望提升日语能力的模型而言,成批扫描实体书或许是获取地道日文文本最直接的途径。
研究人员将这种现象称为"互联网语料枯竭"(web data exhaustion)。据估算,Common Crawl等主流网络爬取数据集在2020年前后已基本覆盖了可公开访问的高质量英文网页,而此后新增的网络内容中,AI生成文本的比例正在快速上升,形成"模型吃模型产出的数据"的循环污染问题。研究表明,用低质量或机器生成文本训练的模型在语言多样性、推理准确性上会出现明显退化,即所谓的"模型坍塌"(model collapse)效应。正因如此,出版于互联网普及之前的大量纸质书籍反而成为相对"纯净"的人类写作样本,其历史跨度长、题材多样,对于提升模型的语言理解深度具有独特价值。
版权风险的规避考量
近年来围绕AI训练数据的版权诉讼层出不穷。购买实体书至少在采购环节形成了合法的所有权,相比直接抓取受版权保护的在线内容,物理书籍的采集路径在法律上显得更为"稳妥"——尽管扫描和用于训练是否构成合理使用,仍存在巨大争议。
值得一提的是,日本的著作权法在AI训练数据使用方面相对宽松,此前曾允许为信息分析目的使用受版权保护的作品,这或许也是采购活动集中在日本市场的原因之一。
日本《著作权法》第30条之4(2018年修订)是这一背景下的关键条款:该条款明确允许将受版权保护的作品用于"信息解析"(情報解析),包括机器学习训练,且原则上无需获得版权人授权或支付许可费。这一条款在全球主要经济体中属于对AI训练最为宽松的立法之一,与美国依赖"合理使用"原则的模糊处理方式不同,日本为AI训练数据的使用提供了相对明确的法律许可。不过,该豁免是否适用于以商业目的训练的大规模通用模型,日本学界与法律界仍存在讨论,且该条款的适用范围不延伸至日本境外,这也意味着在日采购并扫描后用于境外部署的模型,法律风险依然复杂。
从"论吨买书"看数据竞赛的白热化
如果推测成立,这一现象折射出AI行业数据竞赛已进入白热化阶段。当唾手可得的网络数据被瓜分殆尽,各家机构不得不转向线下、转向传统媒介去挖掘增量语料。
这种趋势带来几个值得思考的问题:
- 数据来源的物理化回归:曾被认为过时的实体书籍,在AI时代反而成为战略资源。
- 知识生产者的价值困境:作者和出版商的作品被批量收购用于训练,但原创者是否得到合理补偿,仍是悬而未决的伦理难题。
- 二手市场的意外繁荣:书店销量暴涨的背后,是内容被"物料化"的现实——书不再是被阅读的对象,而是被处理的原材料。
需要保持的审慎
必须强调,目前的报道并未直接证实这些书籍确实流向了AI训练。5倍销量激增是可观察到的事实,而"用于AI训练"更多是社区基于常识的合理推测。也不排除其他解释,比如出版行业的库存清理、特定收藏需求或数字化归档项目。
在缺乏采购方明确信息的情况下,这一现象更应被视为一个值得追踪的行业信号,而非板上钉钉的结论。但无论真相如何,它都提醒我们:AI对数据的胃口正在以我们尚未完全理解的方式,重塑传统内容产业的运作逻辑。
结语
"按吨买书"是一个极具画面感的细节,它把抽象的"数据饥渴"具象化为堆积如山的实体书籍。当算法需要喂养,人类积累了数百年的印刷知识正被重新定价。这场围绕语料的争夺战,或许才刚刚开始。
相关推荐

Firebase AI Logic 实战:让 Gemini 返回结构化 JSON
本教程讲解如何在 Firebase AI Logic 中通过定义响应 Schema,让 Gemini 返回干净、可预测的结构化 JSON。涵盖字段定义、请求配置与解析流程,适用于 API、仪表盘、表单和自动化等场景。

问责机制也能充满乐趣:重塑自律与团队协作的新思路
问责机制常被视为压力与惩罚的代名词,但它其实可以充满乐趣。本文探讨如何通过同伴支持、进展可见化和庆祝小胜利,将问责重构为推动个人成长与团队协作的愉悦力量。

Claude Code 入门:读懂它是什么与多端用法
Anthropic 团队成员 Lydia 主讲的 Claude Code 入门分享:它不只是 CLI,而是可在终端、IDE、浏览器和桌面端运行的 AI Agent。本文梳理其本质定位、多端用法与学习路径。