Ripple-65B预览版发布:65B稠密开源模型登顶Terminal-Bench

Ricursive发布65B稠密开放权重模型Ripple-65B,终端智能体基准得分80.5。
Ricursive Intelligence 发布 Ripple-65B Preview,一个 65B 参数的稠密开放权重语言模型,采用 Apache 2.0 许可。官方称其在 Terminal-Bench 2.1 上取得 80.5 分,领先参数量最高达其 15 倍的美国开源模型。文章分析了这一成绩的意义:终端智能体任务表现并非由参数规模单独决定,针对性训练收益可能更明显;同时提醒 Preview 成绩尚未经第三方复现。文章还讨论了稠密架构在推理成本上的劣势与微调友好性上的优势,以及 Apache 2.0 许可对企业落地和私有化部署的长期价值。
开源模型圈子又迎来一个值得关注的名字。Ricursive Intelligence 发布了 Ripple-65B Preview,一个 65B 参数的稠密(dense)开放权重语言模型,采用 Apache 2.0 许可证。最引人注目的不是参数量,而是它在 Terminal-Bench 2.1 上拿到的 80.5 分——据官方说法,这个成绩领先于参数量最高达到它 15 倍的美国开源模型。
一个65B稠密模型,为什么值得单独讨论
过去一段时间,开源模型的竞争主要集中在两条路线上:一条是堆参数,用更大的稠密模型换取更强的通用能力;另一条是走 MoE(混合专家)路线,用更少的激活参数控制推理成本。Ripple-65B 选择了前者,65B 稠密架构意味着推理时全部参数参与计算,这对显存和吞吐的要求并不低。
在这个体量上还能拿出有竞争力的基准成绩,说明 Ricursive 在训练配方和数据质量上做了不少功课。Apache 2.0 的许可也意味着商用限制很少,这对想要自建推理服务、又不想被许可条款绑住手脚的团队来说,是一个实际的加分项。
稠密模型与MoE的架构差异:稠密(dense)模型指每一层的前馈网络和注意力模块在推理时对每个 token 都完整激活,65B 参数意味着每次前向传播都要调动全部权重。MoE(Mixture of Experts)则把前馈层拆成多个专家,通过路由器为每个 token 只激活少数专家,因此总参数量可以很大而单次激活参数量很小。二者的核心权衡在于:稠密模型显存占用与计算量直接挂钩,部署成本高但行为一致;MoE 在相同总算力下能容纳更多知识,却引入路由不确定性,微调时容易出现专家负载失衡。理解这一点,才能看懂 Ripple-65B 为何在推理经济性上不占优,却仍选择稠密路线。
Terminal-Bench 2.1 的80.5分意味着什么
Terminal-Bench 是一个面向终端环境的智能体基准,考察模型在命令行场景下完成多步骤任务的能力——读文件、改配置、跑命令、根据报错调整策略,这类任务对模型的指令遵循、错误恢复和长程规划能力要求都很高。它不是单纯的知识问答测试,更接近真实工程场景。
80.5 这个分数本身需要放在对比语境里看。原文给出的关键信息是:它超过了参数量最高达到其 15 倍的美国开源模型。换句话说,一个 65B 的稠密模型在终端智能体任务上压过了体量数倍于己的对手。这至少说明两件事:参数规模不是终端任务表现的唯一决定因素;针对智能体场景的针对性训练,收益可能比单纯扩参更明显。
需要提醒的是,这是 Preview 版本,基准成绩来自官方发布,尚未看到独立第三方复现。在社区验证之前,对分数的解读可以保持谨慎。
Terminal-Bench 的评测方式:Terminal-Bench 属于“智能体基准”(agentic benchmark),与 MMLU 这类单轮问答测试有本质区别。它给模型一个容器化的终端环境和一个自然语言任务描述,模型需要自主决定执行哪些 shell 命令、读取哪些文件、如何根据命令输出调整下一步动作,直到任务完成或失败。评分通常基于最终环境状态是否满足预设检查,而非文本匹配。这类基准因此同时考察工具调用格式、多步规划、错误诊断和上下文管理能力,也更接近真实运维与开发场景。80.5 分说明模型在多数任务上能独立走完整个操作链,但基准版本、任务集构成和评分脚本都会影响可比性,跨模型对比时需确认版本一致。
开放权重 + Apache 2.0:许可比分数更长远
技术圈容易把注意力全放在基准分数上,但 Apache 2.0 这个许可选择的长期影响可能更大。开放权重模型常见的问题是许可条款模糊,商用、再分发、微调后的权属都容易产生争议。Apache 2.0 是成熟且被广泛理解的开源许可,法务成本低,企业落地时的阻力小。
对做终端智能体产品的团队而言,一个许可清晰、可以私有化部署、还能按需微调的 65B 模型,填补的是「够用且可控」这个区间。闭源 API 在数据合规和成本可预测性上始终有短板,而这个体量的开放权重模型恰好能覆盖相当一部分内部工具链场景。
开放权重与开源模型的区别:严格意义上的开源模型要求训练数据、代码和权重全部公开,而“开放权重”(open weights)通常只公开推理所需的参数文件,训练数据与流程可能不披露。Llama 系列早期使用的自定义社区许可就属于开放权重而非 OSI 认可的开源许可,常附带月活门槛、命名要求和再分发限制。Apache 2.0 则是 OSI 认证的标准开源许可,明确授予专利许可,允许商用、修改、再分发,仅要求保留版权与许可声明。对企业的实际意义是:法务审查路径成熟,微调后的衍生模型可以自主决定发布方式,不会被上游附加条款追溯。这也是为什么许可选择常比基准分数更能决定一个模型在产业界的采用速度。
稠密路线的现实权衡
选择稠密架构有代价。65B 全参数激活意味着推理成本高于同等总参数量的 MoE 模型,部署时对硬件的要求也更实在。如果目标是高并发、低延迟的在线服务,MoE 通常在性价比上更占优。
稠密模型的价值更多体现在微调友好性和行为可预测性上。稠密结构在微调时的稳定性通常更好,模型行为不容易因为专家路由的变化而漂移,这对需要深度定制的团队是实打实的优势。Ripple-65B 的定位大概率不是去卷通用聊天场景,而是在智能体、代码、终端操作这类需要稳定行为链的任务上建立差异。
预览版之后要看什么
Preview 标签意味着模型还会迭代。接下来值得关注几个方向:独立评测机构能否复现 80.5 这个成绩;社区微调后的实际表现如何,尤其是在非英语终端任务上的鲁棒性;以及 Ricursive 是否会公布训练数据构成和更多基准细节。
开源模型的竞争已经从「谁参数大」转向「谁在特定场景更实用」。Ripple-65B 用 65B 的体量在终端智能体基准上打出这样的成绩,至少提供了一个新的参照点:在智能体这条赛道上,训练策略的权重可能比模型规模更值得投入。
相关推荐
Anthropic推出AI办公套件,企业市场再落一子
Anthropic推出AI办公套件,从编程工具向企业办公平台扩张。本文分析其产品战略、市场竞争格局及对企业用户的意义。
Google Fi推出超级网络:双5G自动切换提升覆盖
Google Fi推出超级网络功能,可在两个5G网络间自动切换以提升覆盖。本文介绍其工作原理、设备限制及对用户的实际意义。
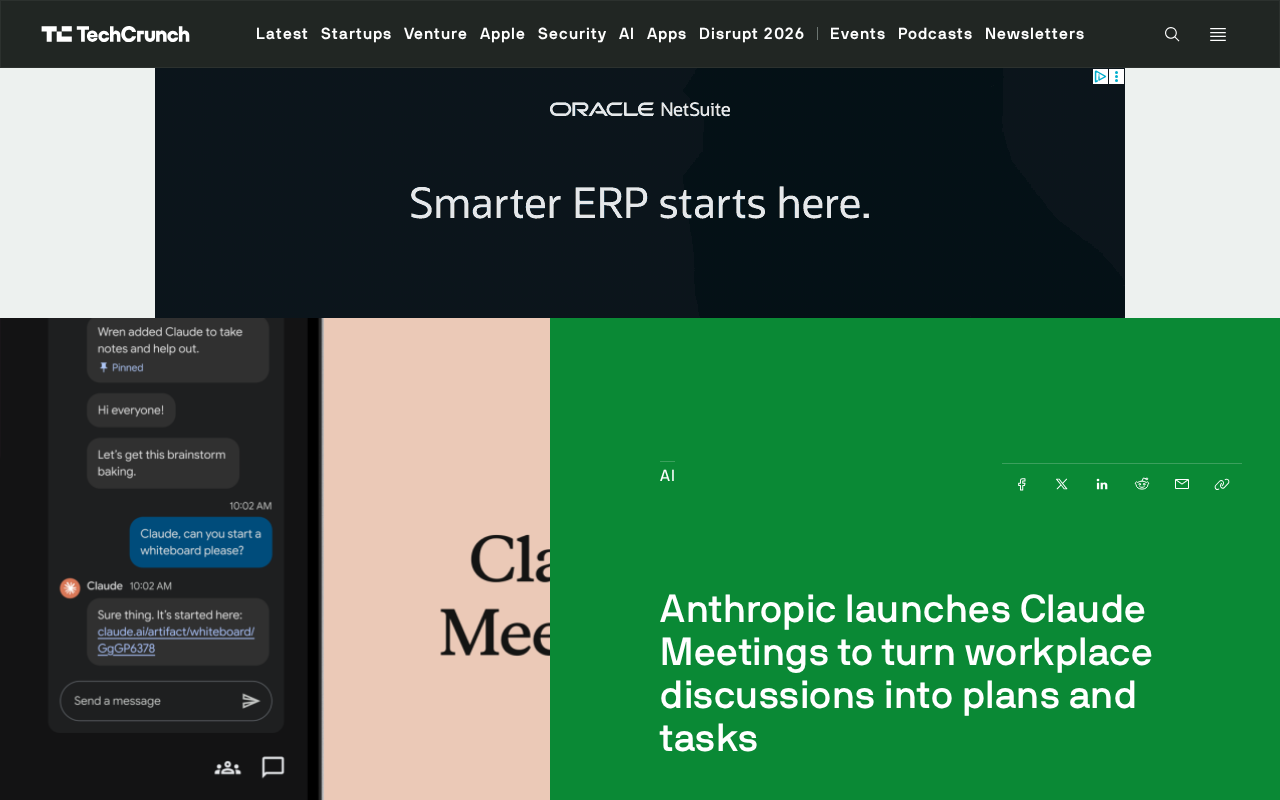
Claude Meetings上线:会议讨论直接生成计划与任务
Anthropic 推出 Claude Meetings,可在会议进行中起草计划、在白板梳理时间线、在聊天中答疑,并调用已连接工作应用检索信息,把讨论直接转化为计划与任务。