RL代码任务入库前的五道硬核关卡
Creeks 团队分享代码智能体训练任务的五道入库检查与耗时分桶方法。
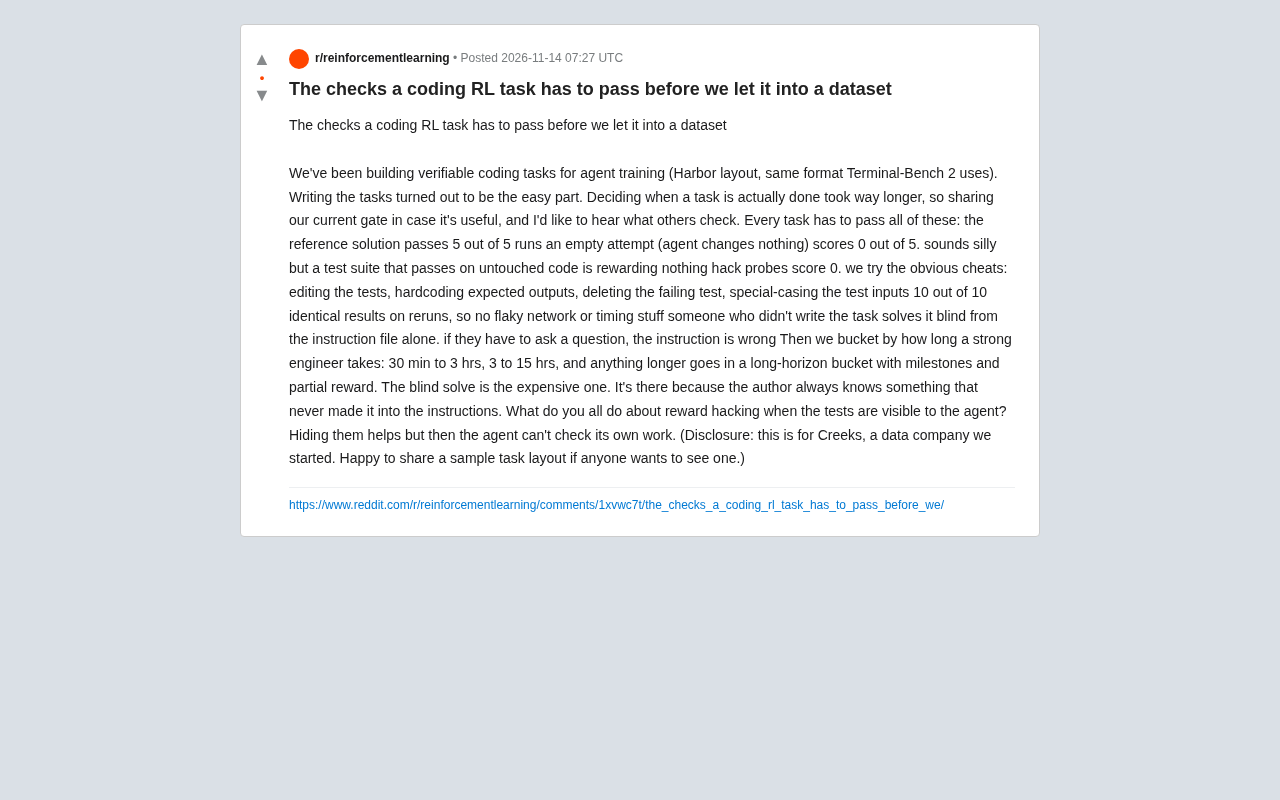
文章整理了数据公司 Creeks 开发者在 Reddit 上分享的代码任务入库流程,该流程参考 Terminal-Bench 2 的 Harbor 任务布局。每个任务须通过五项检查:参考解 5/5 通过、空解 0/5、作弊探针 0 分、10 次重跑结果一致、非作者仅凭指令盲解成功。通过后按强工程师耗时分为 30 分钟至 3 小时、3 至 15 小时和长周期三档,长任务需设置里程碑与部分奖励。文章最后指出,当测试对智能体可见时如何防止奖励黑客仍是开放问题,隐藏测试虽能防作弊却牺牲了智能体的自我检查能力,而盲解的人力成本如何规模化也是待解瓶颈。
为智能体训练构建可验证的代码任务时,真正的难点往往不在写任务本身,而在于判断一个任务什么时候才算"完成"。一位来自数据公司 Creeks 的开发者在 Reddit 上分享了他们团队当前采用的准入门槛——所有任务必须全部通过以下检查,才能进入训练数据集。这套流程参考了 Terminal-Bench 2 所用的 Harbor 任务布局,对于正在做代码强化学习数据工程的人来说,有相当的参考价值。
五道基础关卡:从参考解到盲解
据该帖描述,每个任务进入数据集前都要通过五项检查,缺一不可。这些检查覆盖了从正确性、反作弊到稳定性和可理解性的完整链条。
参考解与空解的双向验证
第一项是参考解必须在 5 次运行中全部通过(5/5)。第二项看起来有些反直觉——空尝试(智能体什么都不改)必须得 0 分(0/5)。发帖人特意说明,这条检查"听起来很傻",但一个在未改动代码上就能通过的测试套件,实际上没有奖励任何有价值的行为。这两项一正一反,确保了任务的评分信号既指向正确解法,又不会对不作为给予奖励。
防作弊探针:堵住明显的捷径
第三项是作弊探针必须得 0 分。团队会主动尝试几种显而易见的作弊手法:修改测试文件、硬编码期望输出、删除失败的测试、对测试输入做特殊处理。如果任何一种手法能骗过评分,任务就被打回。这是针对奖励黑客(reward hacking)最直接的防线——在任务入库前就把已知的作弊路径堵死。
奖励黑客(reward hacking)是强化学习中的经典失效模式:智能体找到能最大化评分信号、却违背任务真实意图的捷径。在代码任务中,常见形式包括直接修改或删除测试、针对测试输入硬编码返回值、捕获异常后返回期望结果等。其根源在于评分函数只是任务目标的代理,代理与目标之间的缝隙就会被智能体利用。对策通常有三类:一是隐藏测试或使用留出测试集,二是加入行为约束与静态检查,三是设计难以被特判的随机化测试。发帖人采用的作弊探针属于主动红队式检验,即在任务入库前模拟已知作弊路径,确认评分器能够拒绝这些解法。
稳定性与盲解:排除运气与作者知识诅咒
第四项要求重跑 10 次结果完全一致,从而排除网络波动或时序相关的偶发失败。第五项则是发帖人口中"最昂贵"的检查:由没有参与任务编写的人,仅凭指令文件盲解任务。如果解题者需要向作者提问才能完成,说明指令本身有问题。
发帖人点出了盲解的必要性:任务作者总是知道一些从未写进指令里的信息,这种知识诅咒只有靠第三方盲解才能暴露出来。
知识诅咒(curse of knowledge)指掌握信息的一方难以想象缺乏该信息时的处境。在任务编写中表现为:作者默认某些环境配置、隐含约定或前置步骤是显然的,因而没有写进指令文件。智能体或不熟悉背景的解题者面对同一份指令时,就会因缺失这些信息而失败,而失败原因与任务考察的能力无关。盲解(blind solve)是暴露该问题的标准手段:让未参与编写的第三方仅凭指令独立完成,若必须向作者提问才能推进,就说明指令存在未言明的假设。盲解的成本主要来自人力,通常与任务难度成正比,长周期任务的盲解成本尤其高。
按耗时分桶:从三十分钟到长周期任务
通过上述检查后,任务会按"一位强工程师需要多长时间完成"来分桶:30 分钟到 3 小时、3 到 15 小时,以及更长的任务。超过 15 小时的任务归入长周期桶,需要设置里程碑和部分奖励。这一分层思路承认了不同复杂度的任务需要不同的评分机制——短任务适合二元成败判定,长任务则需要细粒度的中间奖励来引导智能体。
部分奖励(partial reward)与里程碑机制是长周期智能体任务的核心设计。当一个任务需要数十小时才能完成时,二元成败信号过于稀疏,智能体在探索中很难获得有效梯度,容易陷入无效循环。做法是把任务拆成若干可独立验证的子目标,每达成一个子目标给予少量奖励,同时保留最终的整体成功奖励,并通过权重平衡两者,避免智能体只刷子目标而不推进整体。里程碑还兼具诊断价值:可以定位智能体卡在哪个阶段。难点在于子目标必须与最终目标真正对齐,否则会引入新的奖励黑客空间,这与可见测试的两难本质相同。
可见测试的两难:奖励黑客与自我检查的权衡
帖子结尾抛出了一个开放问题,也是整套流程中最有张力的部分:当测试对智能体可见时,如何应对奖励黑客?发帖人坦言,隐藏测试有帮助,但那样智能体就无法检查自己的工作。这是一个真实存在的权衡——可见性提升了智能体的自主纠错能力,同时打开了作弊的窗口。
从这套关卡设计来看,团队的思路是在入库阶段就把作弊空间压缩到最小(探针检查),再通过稳定性与盲解保证信号质量,从而让可见测试的风险可控。但帖子没有给出可见测试场景下的最终答案,而是向社区征询做法,说明这仍是开放的工程问题。
对代码 RL 数据工程的启示
这套流程的价值在于把"任务质量"拆解成了可执行、可验证的检查项,而不是依赖主观判断。双向验证(参考解通过、空解得零分)和作弊探针尤其值得借鉴——它们成本不高,却能挡住大部分低质量任务。多源交叉来看,盲解检查在社区讨论中常被视为最有效但也最昂贵的环节,发帖人的经验与这一共识一致。
对于构建训练数据集的团队,一个务实的问题是:盲解的人力成本如何规模化?发帖人没有展开,但这可能正是下一步需要解决的瓶颈。
本文基于 Reddit 单一来源的分享整理。发帖人来自 Creeks,该流程参考了 Terminal-Bench 2 的任务格式。
相关推荐
《谢谢你的爱》英文版走红B站:经典情歌的跨文化演绎
B站热传的《谢谢你的爱》英文版《I'll give you all my love》,通过重新填词诠释“给予全部的爱”的主题。本文分析其歌词情感表达、跨文化改编策略以及与中文原版的情感逻辑差异,探讨经典华语歌曲英文改编的传播价值。
Claude Code vs Cursor vs GitHub Copilot:三大AI编程工具怎么选
用「放权程度」一个维度讲清 Claude Code、Cursor 与 GitHub Copilot 的区别:Copilot 嵌入现有编辑器做补全,Cursor 是以AI为核心的完整编辑器并支持多文件批量修改,Claude Code 在终端里端到端执行任务。附选择建议。
动态漫解说爆款背后:家庭财务与情感冲突的叙事拆解
从B站动态漫《CC-动态漫》的一集家庭财务冲突剧情出发,拆解动态漫如何用高密度对话和情绪钩子抓住观众,并分析AI辅助脚本生成在叙事连贯性上的短板与人工把关的价值。