ROCmFix与InferBench:AMD显卡本地大模型部署实测
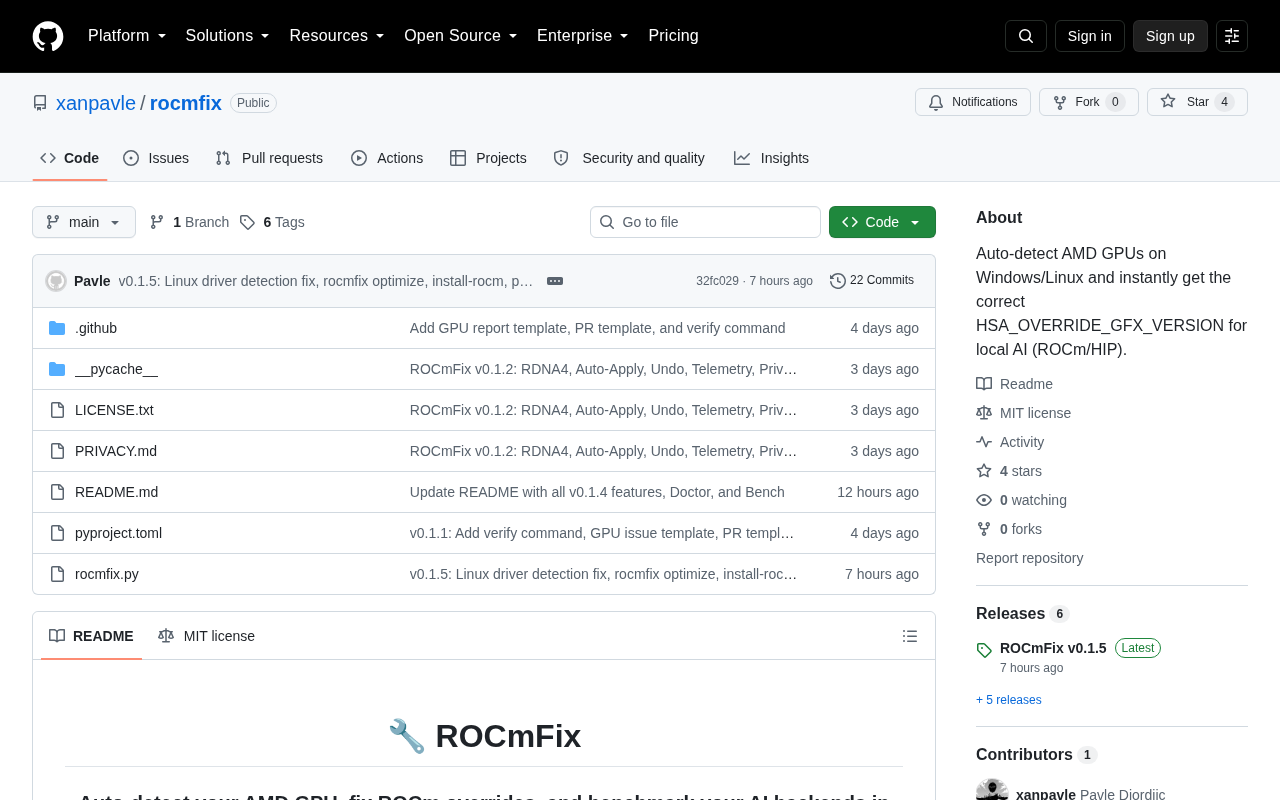
ROCmFix与InferBench两个社区工具,分别针对AMD显卡本地LLM部署难和Vulkan/HIP后端性能取舍不清的痛点。
本文介绍了在Hacker News上出现的两个面向AMD显卡用户的社区工具:ROCmFix和InferBench。ROCmFix旨在简化ROCm平台的环境配置流程,帮助用户在AMD显卡上更顺畅地部署Llama、Mistral等本地大语言模型,降低驱动版本冲突和依赖管理的门槛。InferBench则专注于一个长期缺乏系统化实测数据的问题:在同一块AMD显卡上,兼容性更广的Vulkan后端与性能潜力更大的HIP(ROCm原生)后端,究竟谁的推理速度更快?两个项目共同反映出社区开发者正主动填补AMD本地LLM生态在工具链和基准数据上的空白,对于希望以AMD显卡替代NVIDIA方案进行本地推理的用户具有参考价值。
背景:AMD显卡跑本地LLM的痛点
在本地运行大语言模型(LLM)的场景中,NVIDIA凭借成熟的CUDA生态长期占据主导地位。而AMD显卡用户想要跑通本地推理,往往要在ROCm(Radeon Open Compute)驱动栈上折腾许久——环境配置繁琐、依赖版本冲突、后端选择困难,是绕不开的三座大山。
最近一个名为 ROCmFix 和 InferBench 的项目在 Hacker News 上被分享,正是瞄准了这一痛点。前者试图简化 AMD 平台上本地 LLM 的部署流程,后者则聚焦于一个长期存在争议的问题:在 AMD 硬件上,究竟是用 Vulkan 后端更快,还是用 HIP(ROCm 的编程接口)后端更快?
ROCmFix:降低 AMD 本地部署门槛
ROCmFix 的定位是一个辅助工具,目标是让 AMD GPU 用户在配置本地 LLM 推理环境时少踩坑。ROCm 作为 AMD 对标 CUDA 的开源计算平台,虽然近年来在深度学习框架支持上有明显进步,但对普通用户而言,正确安装驱动、匹配 ROCm 版本、编译推理引擎仍是一道不小的门槛。
这类工具的价值在于把散落在各处的配置经验固化下来,减少用户在版本兼容和环境搭建上的试错成本。对于希望脱离云端、在自己 AMD 显卡上跑 Llama、Mistral 等模型的开发者和爱好者来说,这种"开箱可用"的方向是刚需。
ROCm(Radeon Open Compute)是 AMD 推出的开源 GPU 计算平台,定位类似于 NVIDIA 的 CUDA,为 GPU 通用计算提供驱动、运行时、编译器及数学库等完整软件栈。ROCm 的核心挑战在于其支持的 GPU 型号范围相对有限——主要覆盖 Radeon RX 6000/7000 系列及 Instinct 数据中心卡,部分消费级显卡(如 RX 5000 系列)处于官方支持边缘甚至不在列表内。此外,ROCm 的版本迭代较快,与 PyTorch、llama.cpp 等上游框架之间的版本对应关系复杂,一旦版本不匹配便可能导致编译失败或运行时崩溃。这也是为什么像 ROCmFix 这类"修复脚本/配置工具"在社区中有市场——它们本质上是将社区积累的版本适配经验和补丁脚本打包,让普通用户绕开繁琐的手动排查过程。
InferBench:Vulkan vs. HIP 的性能之争
InferBench 关注的核心问题非常具体——同一块 AMD 显卡,用不同的推理后端跑同一个模型,性能差距有多大?
两种后端的技术路线差异
HIP 是 ROCm 生态的原生编程接口,理论上能更贴近硬件、发挥更高的计算效率,但代价是对驱动和环境的要求更严格,兼容性问题更多。
Vulkan 作为跨平台图形与计算 API,近年来被 llama.cpp 等项目用作通用 GPU 推理后端。它的优势在于兼容性广、部署简单,几乎不依赖厂商专用驱动栈,缺点则可能是在特定硬件上的峰值性能不如原生方案。
值得补充的是,llama.cpp 作为目前本地 LLM 推理最主流的开源框架,同时支持多种 GPU 后端,包括 CUDA(NVIDIA)、Metal(Apple Silicon)、Vulkan(跨平台)以及基于 ROCm/HIP 的编译路径。其中 Vulkan 后端的加入让拥有任何支持 Vulkan 1.2+ 的 GPU 用户(包括部分 AMD 老款显卡甚至 Intel 集显)都能获得 GPU 加速,大幅降低了硬件门槛。HIP 路径则依赖 ROCm 工具链编译,生成的代码更贴近 AMD GCN/RDNA 架构的原生指令集,理论上可以利用更多硬件特性(如矩阵加速单元)。两条路线的性能差距在不同 GPU 型号和模型量化精度(Q4、Q8 等)上表现不一,缺乏统一结论,这正是 InferBench 试图用系统化测试回答的问题。
为什么这个对比重要
对 AMD 用户而言,选择后端不是纯粹的技术偏好,而是"能跑通"与"跑得快"之间的权衡。Vulkan 路线省心但可能有性能损失,HIP 路线潜力更大但配置成本高。InferBench 提供的基准测试数据,正是帮助用户做出这一取舍的关键依据。这也是本地 LLM 社区长期争论、却缺乏系统化实测数据的领域。
对本地 LLM 生态的意义
随着本地部署大模型的需求增长,打破 NVIDIA 的事实垄断成为社区关注的方向。AMD 显卡通常有更具竞争力的显存容量和价格,如果软件栈的易用性和性能能够跟上,将为本地 LLM 用户提供更多选择。
ROCmFix 和 InferBench 这类社区工具的出现,反映出开发者正在主动填补 AMD 生态在工具链和实测数据上的空白。它们本身可能还处于早期阶段,但代表了一种务实的努力:不是等待厂商把一切做好,而是先用工具和基准测试把现状摸清楚。
小结
需要说明的是,该项目目前在 Hacker News 上的讨论度还较低(5 分、1 条评论),公开信息有限,尚无法对其成熟度和实测结论下定论。但它触及的两个问题——AMD 本地部署的易用性、Vulkan 与 HIP 的性能取舍——都是本地 LLM 社区真实存在的痛点。对于手握 AMD 显卡、想要探索本地推理的用户,这类工具值得持续关注。
相关推荐
《美丽心灵》背后:胰岛素休克疗法与精神病治疗的黑暗史
医学史学者Andrew Scull回顾20世纪精神病治疗黑暗史:胰岛素休克疗法如何以"奇迹疗法"之名施加伤害,《美丽心灵》原型约翰·纳什也曾是受害者。解析这些危险疗法的兴衰与科学验证的教训。
电击疗法的血腥起源:从屠宰场到精神科的百年争议
医学史学家Andrew Scull在与Lex Fridman的对谈中揭示电击疗法(ECT)从罗马屠宰场获得灵感的血腥起源,剖析其从惩罚工具到循证疗法的演变、脑损伤与记忆丧失争议,以及背后更深层的科学公信力危机。
弗洛伊德与荣格决裂内幕:精神分析之父的爱恨情仇
历史学家 Andrew Scull 在 Lex Fridman 播客中解析弗洛伊德与荣格从师徒盟友到彻底决裂的内幕,回顾精神分析起源、安娜·O 案例及弗洛伊德「伟大仇恨者」的性格。