ROCm上实现训练与推理logprob逐位对齐:RL-Kernel破解RL训练精度难题
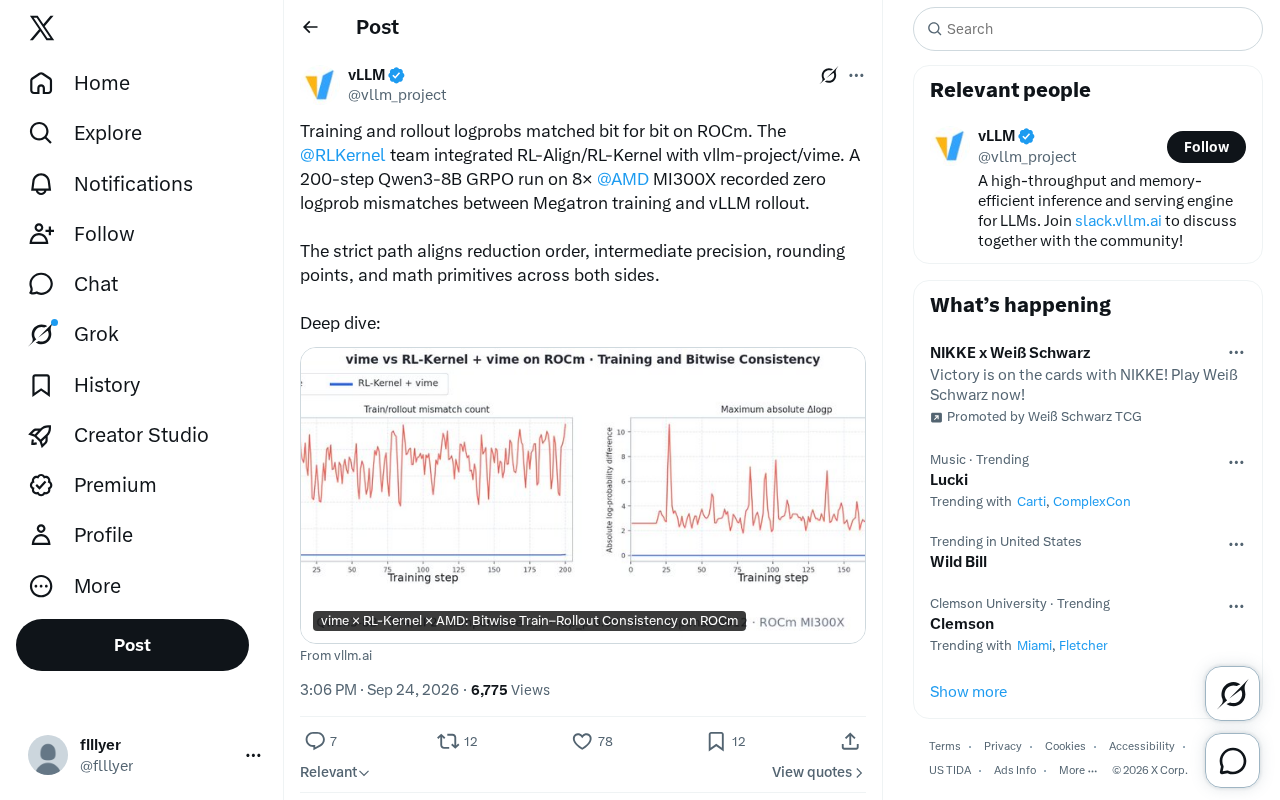
RL-Kernel团队在AMD MI300X上实现训练与推理logprob逐位匹配,从根本上解决RL训练数值偏差难题。
大模型强化学习训练中,训练端(Megatron)与推理端(vLLM)因归约顺序、数值精度等差异导致的logprob不匹配,会通过重要性采样权重放大为训练信号失真,是RL不稳定的深层根源。RL-Kernel团队通过统一归约顺序、中间精度、舍入点和数学原语四个关键计算环节,在AMD ROCm平台(8×MI300X)上完成了200步Qwen3-8B GRPO训练,记录到零logprob不匹配。这一"严格路径"工程成果使重要性采样权重可以精确计算,显著提升训练稳定性与可复现性,同时也展示了AMD ROCm软硬件栈在高要求大模型训练场景下的成熟度,为业界提供了可借鉴的数值对齐工程范本。
强化学习训练中的"隐形杀手":logprob不匹配
在大模型强化学习(RL)训练中,有一个长期困扰工程师的隐性问题:训练框架计算的对数概率(logprob)与推理框架在rollout阶段计算的logprob往往对不上。这种看似微小的数值差异,会在GRPO、PPO等算法的重要性采样权重中被放大,导致训练信号失真,甚至引发训练崩溃。
这个问题的根源在于,训练与推理通常由两套不同的系统承担——训练端常用Megatron等框架,推理端则依赖vLLM这类高吞吐引擎。两套系统在计算顺序、数值精度、舍入处理上的细微差异,累积起来就成了影响RL稳定性的"隐形杀手"。
对数概率(logprob)与重要性采样是理解这一问题的关键背景。在PPO和GRPO等策略优化算法中,重要性采样(Importance Sampling)用于校正"行为策略"(收集数据时的旧策略)与"目标策略"(当前更新中的新策略)之间的分布差异,校正权重正比于新旧策略在同一动作上的概率之比 exp(logprob_new - logprob_old)。由于这是一个指数函数,分子分母上哪怕只有 0.001 的 logprob 偏差,都会被指数放大为可观的权重误差。当训练端(Megatron)计算的 logprob_old 与推理端(vLLM)在 rollout 阶段实际生成时记录的 logprob_old 存在系统性偏差时,重要性采样权重便会持续出错,导致策略梯度方向偏移。这种误差不会平均抵消,而是随训练步数积累,最终表现为训练曲线震荡、奖励不收敛,甚至梯度爆炸式崩溃。
RL-Kernel团队的突破:在AMD MI300X上做到逐位一致
据@RLKernel团队披露,他们将RL-Align/RL-Kernel与vllm-project的相关组件进行了集成,在AMD ROCm平台上实现了训练与推理logprob的逐位(bit for bit)匹配。
验证实验颇具说服力:团队在8块AMD MI300X上运行了一个200步的Qwen3-8B GRPO训练任务,结果显示Megatron训练端与vLLM rollout端之间零logprob不匹配。换言之,整个训练过程中两套系统计算出的对数概率完全一致,没有任何数值偏差。
对于RL训练而言,这是一个重要的工程里程碑。零不匹配意味着重要性采样权重可以精确计算,训练过程中的策略更新更加可信,稳定性显著提升。
AMD MI300X 是 AMD 面向 AI 训练与推理的旗舰加速器,采用 Chiplet 封装,集成了 192 GB HBM3 统一内存,单卡峰值 BF16 算力约为 1.3 PFLOPS。ROCm(Radeon Open Compute)是 AMD 对标 NVIDIA CUDA 的开放软件栈,提供 HIP 编程接口以及与 CUDA 语义对齐的数学库(如 rocBLAS、rocRAND)。值得注意的是,数值对齐的难度在 ROCm 平台上并不低于 CUDA——不同硬件厂商的数学原语(尤其是超越函数 exp/log 的硬件实现)在末位精度上允许存在合规差异,这正是 RL-Kernel 需要在"数学原语"层面单独对齐的原因。在 MI300X 上实现逐位匹配,也间接证明 ROCm 数学库已具备足够的可控性,供上层框架进行精细的数值行为定制。
技术路径:对齐四个关键环节
RL-Kernel的"严格路径"(strict path)之所以能做到逐位对齐,核心在于它统一了训练与推理两端的四个关键计算环节:
归约顺序(reduction order)
浮点数的加法不满足结合律,不同的求和顺序会产生不同的结果。两端采用一致的归约顺序,是消除数值漂移的第一步。
中间精度(intermediate precision)
矩阵乘法、softmax等运算中间结果的精度选择会直接影响最终输出。严格路径确保两侧使用相同的中间精度配置。
舍入点(rounding points)
浮点运算在何处进行舍入、采用何种舍入模式,同样会导致结果分叉。统一舍入点让计算过程完全可复现。
数学原语(math primitives)
底层数学函数(如exp、log等)的实现差异也是误差来源之一。两端使用相同的数学原语,从根本上保证了一致性。
通过在这四个维度上实现训练侧与推理侧的严格对齐,RL-Kernel让两套本来独立演化的系统在数值层面达成了完全统一。
浮点运算不满足结合律这一特性在大规模并行计算中尤为突出。以 BF16 或 FP16 格式对一个长序列的 logit 求和为例,GPU 会将数据切分到数千个并行线程上分块归约(tree reduction),最终结果的精度取决于归约树的形状和每一级的舍入行为。训练框架(Megatron)为了吞吐量可能采用跨张量并行分片的归约策略,而推理框架(vLLM)在 KV-cache 优化模式下则使用另一套 kernel。即便两者输入完全相同,输出的最后几个 ULP(Unit in the Last Place,浮点精度的最小单位)也可能不同。"严格路径"的核心工作,就是让两套系统在这四个维度上调用相同的底层 kernel 实现,从根源上杜绝因实现路径分叉引入的数值噪声。
为什么这件事值得关注
这项工作的意义不止于一次技术验证,它触及了RL训练基础设施的一个核心痛点。
对RL训练稳定性的直接改善。 logprob不匹配是许多RL训练不稳定、难以复现的根本原因之一。实现逐位对齐后,训练结果的确定性和可复现性大幅提升,调试和迭代成本随之降低。
AMD生态在AI训练领域的推进。 这次验证选择在ROCm平台和MI300X硬件上完成,展示了AMD GPU在大模型RL训练场景下的成熟度。长期以来CUDA生态占据主导,而在ROCm上做到如此精细的数值对齐,说明AMD软硬件栈正在逼近高要求训练任务的门槛。
开源协作的价值。 RL-Align/RL-Kernel与vLLM项目的集成,体现了开源社区在解决底层基础设施难题上的协同能力。这类工作往往需要跨多个框架的深度打通。
小结
在8×MI300X上完成200步Qwen3-8B GRPO训练、实现零logprob不匹配,是RL训练基础设施的一次扎实进展。它通过统一归约顺序、中间精度、舍入点和数学原语四个环节,解决了训练与推理两端数值对齐的老大难问题。对于追求训练稳定性与可复现性的团队而言,这一"严格路径"思路提供了可借鉴的工程范本。感兴趣的读者可查阅团队发布的深度技术解析获取更多细节。
相关推荐

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。