ROCm修复gfx950上AITER调优GEMM大规模矩阵溢出问题
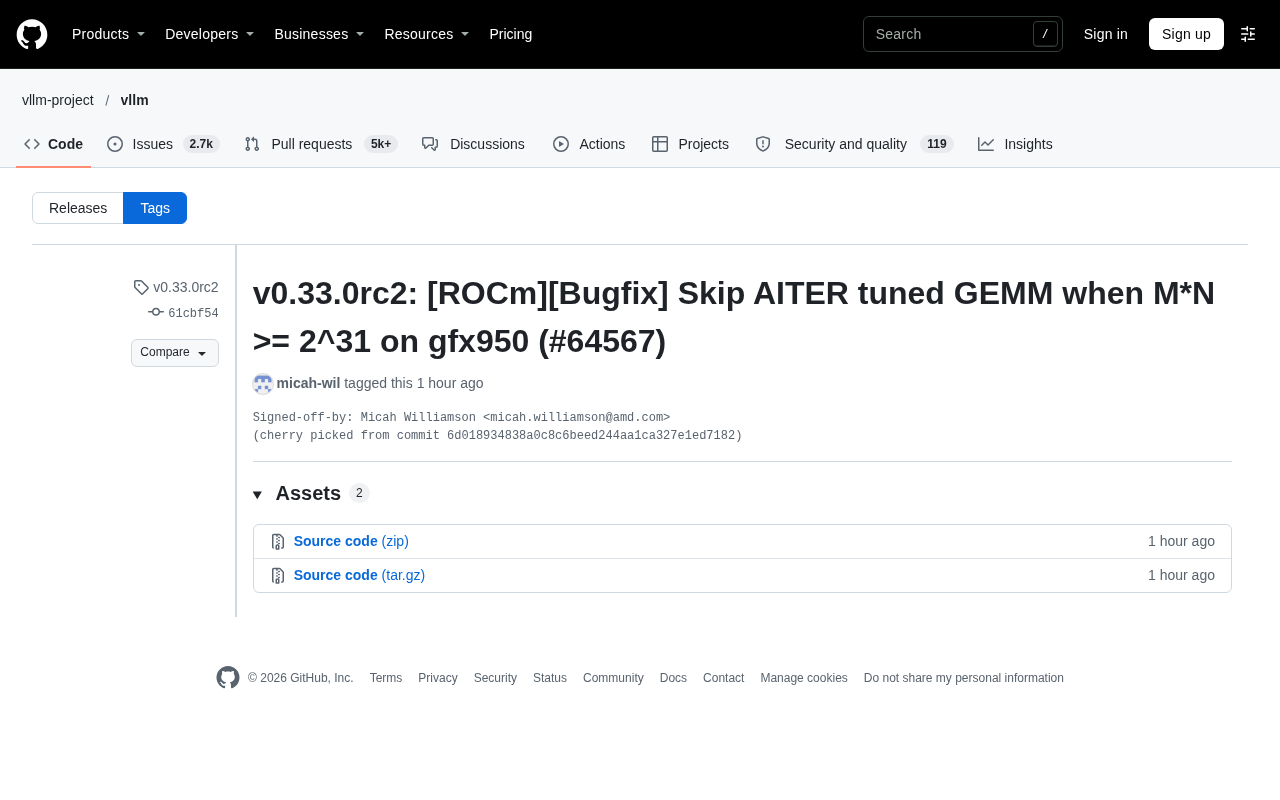
vLLM修复gfx950上AITER调优GEMM在M*N≥2^31时的整数溢出风险,以条件回退保障正确性。
vLLM v0.33.0rc2包含一条来自AMD工程师的bugfix,针对gfx950架构上AITER调优GEMM在矩阵元素总数M*N达到2^31时可能出现的32位整数溢出问题。修复方式是在检测到阈值时跳过调优路径,回退到通用GEMM实现,以性能牺牲换取正确性。文章分析了AITER在ROCm生态中的角色、阈值与硬件绑定的原因、回退的性能代价,并指出该修复从主线cherry-pick至发布分支。对大模型推理部署而言,这提醒团队升级版本、建立大尺寸边界测试,并系统审视算子库的索引宽度假设。
一个看似不起眼的边界条件,为何值得关注
在GPU算子优化中,GEMM(通用矩阵乘法)的性能调优往往聚焦于分块策略、流水线深度和内存访问模式。但当矩阵规模跨过某个临界点时,调优代码本身反而可能成为正确性的隐患。vLLM项目近期发布的v0.33.0rc2版本中,一条来自AMD工程师Micah Williamson的bugfix提交(#64567)正是针对这类问题:在gfx950架构上,当矩阵乘法的M*N大于等于2^31时,跳过AITER调优的GEMM路径。
这个改动表面上只是一行条件判断,实际上折射出大模型推理场景下矩阵规模膨胀带来的工程挑战。2^31是32位有符号整数的边界,一旦元素总数越界,索引计算、偏移量或内部缓冲区的地址运算就可能发生溢出,导致结果错误甚至非法内存访问。
AITER调优GEMM在ROCm生态中的角色
AITER是AMD面向ROCm平台推出的算子调优组件,其核心思路是针对特定硬件架构预编译或自动搜索高性能kernel配置。对于gfx950这类较新的GPU架构,AITER能够根据矩阵形状选择更贴合硬件特性的实现,通常能带来可观的吞吐提升。
问题在于,调优路径往往假设输入规模落在某个合理范围内。当M与N的乘积逼近或超过2^31时,kernel内部若使用32位整数进行线性索引,就可能出现负数或回绕,进而访问到错误的内存区域。这类bug的隐蔽性很强:小规模测试全部通过,只有在大batch、长序列或超大词表的真实推理负载下才会暴露。
据提交信息,该修复被cherry-pick自上游commit 6d018934838a0c8c6beed244aa1ca327e1ed7182,说明这个问题在主线已经过验证,随后回合到v0.33.0rc2发布分支,以保证RC版本的稳定性。
ROCm是AMD推出的开源GPU计算平台,对标NVIDIA的CUDA生态。它包含编译器、运行时、数学库和调优工具等组件,支持PyTorch、TensorFlow等主流框架在AMD GPU上运行。AITER(AI Tensor Engine for ROCm)是其中的算子调优层,针对特定GPU架构(如gfx950)生成或预编译高性能kernel,以弥补通用实现在新硬件上的性能不足。gfx950是AMD CDNA架构中的一款GPU核心代号,常见于MI300系列加速卡,其计算单元和内存子系统针对矩阵运算做了优化。理解这一生态背景有助于把握:AITER调优GEMM并非通用库,而是深度绑定硬件特性的性能加速组件,因此其内部实现可能带有架构相关的索引假设。
修复策略:用条件回退换取正确性
补丁的做法相当直接——在gfx950上检测M*N是否达到2^31阈值,若达到则绕过AITER调优的GEMM实现,回退到通用路径。这种“性能让位于正确性”的取舍在底层算子开发中是标准做法:宁可牺牲一部分吞吐,也不能让大规模推理悄悄算错。
从工程角度看,这个修复有几个值得注意的点。
阈值选择与硬件绑定
2^31并非随意选取的数字,它对应32位有符号整数的正向上限。将判断与gfx950架构绑定,说明该问题可能与该架构的特定指令或AITER针对它生成的kernel实现有关,而非所有ROCm设备普遍存在。这也提醒使用其他AMD GPU的用户,不能简单套用这一结论。
32位有符号整数(int32)的取值范围是-2^31到2^31-1,共约21.47亿。在GPU kernel中,线性索引常用int32以节省寄存器空间并提升地址计算速度。当矩阵元素总数M*N达到2^31时,最大索引值恰好越过int32正向上限,回绕为负数,导致越界访问或错误计算。使用64位整数(int64)可避免溢出,但会增加寄存器压力和地址计算开销,因此调优kernel往往优先采用int32并假设规模在安全范围内。这种取舍在性能敏感场景中很常见,但也埋下了大规模输入下的正确性隐患。
回退路径的性能代价
跳过调优GEMM意味着这些超大矩阵会走默认实现,性能可能不及专门调优的kernel。但对于触发阈值的规模而言,正确完成计算显然优先于峰值性能。实际部署中,如果业务确实频繁出现M*N超过2^31的GEMM,就需要评估回退带来的吞吐损失,并关注后续是否有更根本的修复(例如改用64位索引的调优kernel)。
cherry-pick是版本控制中的常见操作,指将某个分支上的特定提交复制到另一分支。在开源项目发布流程中,RC(Release Candidate)版本冻结后,主线上发现的bugfix若被评估为关键修复,会通过cherry-pick回合到发布分支,避免重新引入其他未经验证的改动。这一机制保证了RC版本的稳定性,同时让已修复的问题不会遗漏在正式版之外。vLLM采用这一流程,说明该bugfix在主线上已通过测试,回合操作降低了发布分支的回归风险。
对大模型推理部署的启示
这条提交虽然只改动了少量代码,但对在AMD平台上运行大模型服务的团队有实际参考价值。
第一,升级到v0.33.0rc2或包含该修复的正式版本,可以避免gfx950上超大GEMM的潜在正确性问题。第二,它提示我们在性能调优之外,要为大尺寸输入建立边界测试用例,尤其是涉及32位索引的kernel。第三,选择算子库的调优路径时,需要确认其对大规模形状的覆盖情况,而不是只看中小规模的benchmark数字。
从更宏观的视角看,随着上下文窗口和batch规模持续增长,M*N越过2^31的场景会越来越常见。这类边界bug的出现频率可能上升,算子开发者需要系统性地审视索引宽度的假设,而不是逐个打补丁。
小结
v0.33.0rc2中的这条ROCm bugfix,用一次条件回退解决了gfx950上AITER调优GEMM在M*N≥2^31时的正确性风险。它提醒我们:在追逐GEMM性能的过程中,整数溢出这类经典问题依然潜伏在调优代码里,而大规模推理负载正是检验它们的试金石。
相关推荐
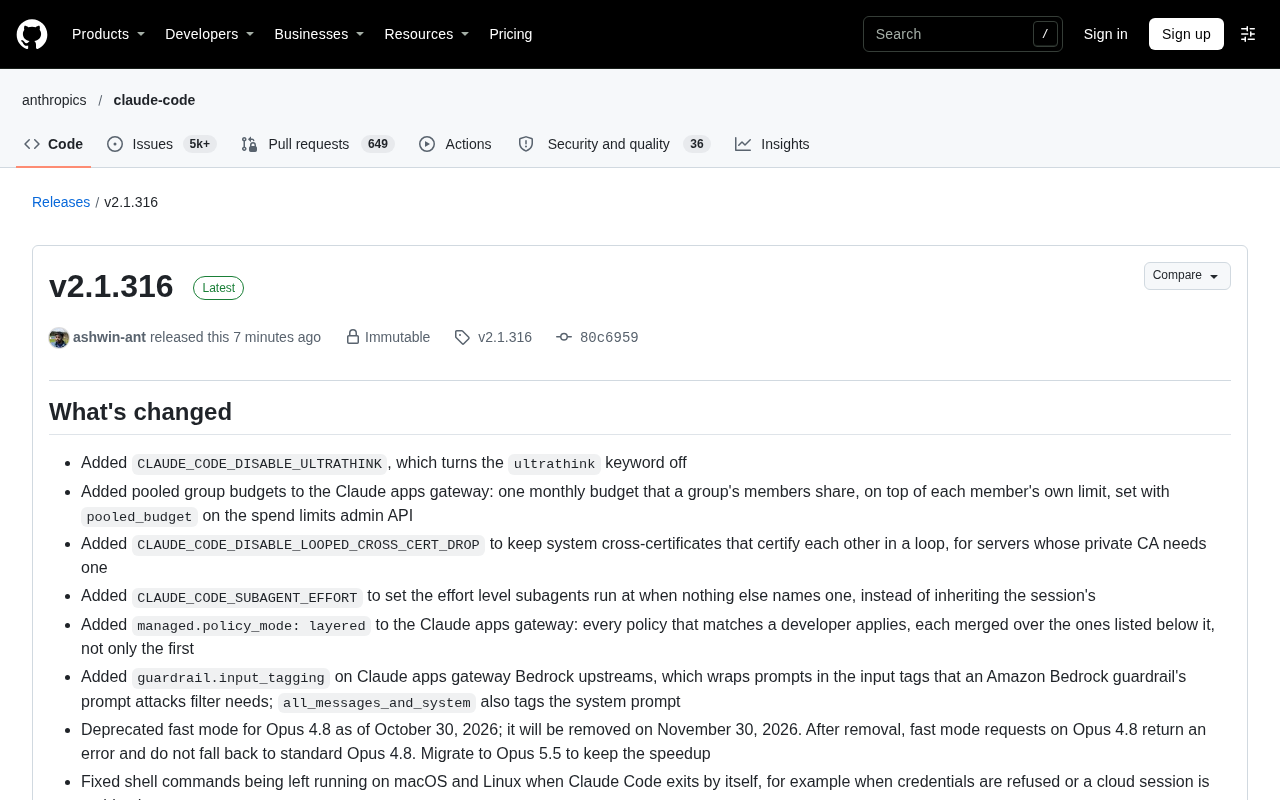
Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。