RTX 5060 Ti 16GB 本地 LLM 选型指南:Ollama 模型实测推荐
16GB显卡本地跑大模型:7B-14B流畅运行,选对量化与专用模型才是关键。
本文以 RTX 5060 Ti 16GB 显卡为例,系统梳理了消费级显卡本地运行大语言模型的实际能力边界与选型策略。16GB 显存可流畅驾驭 Q4 量化后的 7B 至 14B 参数模型,30B 级别模型虽可借助 32GB 系统内存运行但速度受限。文章按编程、学习推理、设计生成三类场景分别给出推荐:代码任务首选 Qwen2.5-Coder 14B,通用推理推荐 Llama 3.1 8B 或 Qwen2.5 14B,图像生成则需另行使用 Stable Diffusion 工具链而非 Ollama。此外还强调了量化等级选择、上下文长度管理和显存监控三个关键调优点,核心结论是:在有限显存下,为不同任务选用专用模型并合理量化,比追求最大参数规模更能发挥硬件价值。
一块 16GB 显卡能跑哪些本地大模型
随着 Ollama 把本地部署大模型的门槛降到几乎“一行命令”的程度,越来越多消费级显卡用户开始尝试在自己的 PC 上运行 LLM。一位 Reddit 用户提出了一个很有代表性的问题:手握 RTX 5060 Ti 16GB、Ryzen 7 7700X、32GB DDR5 内存的配置,到底该选哪些模型来做编程、学习 AI/ML、通用推理问答以及设计生成?
这套配置其实非常典型——16GB 显存不算顶级,但也远超入门级,属于“能玩得比较尽兴”的甜点区间。理解它的能力边界,比盲目下载一堆模型更重要。
16GB 显存的实际承载能力
判断一块显卡能跑多大的模型,核心指标是显存容量与模型量化后的体积。经验法则是:模型的量化文件大小加上上下文缓存,要能塞进显存,才能获得完整的 GPU 加速;一旦溢出到系统内存和 CPU,速度会大幅下降。
对于 16GB 显存而言,可以粗略划分为三档:
- 7B–9B 参数模型:使用 Q4 或 Q5 量化后通常占用 5–7GB,能完全放进显存并留出充足的上下文空间,运行流畅,是日常主力。
- 12B–14B 参数模型:Q4 量化后大约占用 8–10GB,仍可全程 GPU 运行,是这块显卡能舒适驾驭的“上限甜点”。
- 27B–32B 参数模型:即便用较激进的量化,也会逼近或超出 16GB,往往需要部分卸载到 CPU,速度明显放缓,只适合对响应速度不敏感的场景。
值得关注的是 32GB 的 DDR5 系统内存,它为超出显存的模型提供了缓冲,让 30B 级别的模型“能跑但不快”成为可能。
量化(Quantization)是理解这套配置能力边界的关键概念。它将模型权重从训练时的 32 位或 16 位浮点数压缩为更低精度的整数(如 4 位、5 位、8 位),从而大幅缩减模型体积与显存占用,代价是极小幅度的精度损失。常见格式如 Q4_K_M 中,"Q4"代表 4-bit 量化,"K"指采用 K-quant 分组策略,"M"表示中等质量档位。以 14B 参数模型为例,FP16 格式需约 28GB,而 Q4_K_M 量化后仅需约 9GB,这正是 16GB 显卡能驾驭 14B 模型的根本原因。GGUF 是目前 Ollama 和 llama.cpp 生态中最主流的量化文件格式,包含了模型结构与量化权重,可直接加载运行,无需额外转换步骤。
按使用场景推荐模型
提问者的需求分为四类,不同任务对模型的偏好差异很大,没有一个模型能通吃所有场景。
编程与软件开发
代码任务对模型的指令跟随和结构化输出要求高。在 16GB 显存范围内,Qwen2.5-Coder 14B 是当前口碑很好的选择,专为代码优化,14B 量化后可全程 GPU 运行。若想要更快的响应,可以退一档用 Qwen2.5-Coder 7B 或 DeepSeek广告-Coder-V2 的轻量版本。这类专用代码模型在补全、重构和调试解释上明显优于同尺寸的通用模型。
Qwen2.5-Coder 是阿里巴巴通义团队专为代码场景训练的模型系列,基于 Qwen2.5 基座并在大规模代码语料上继续预训练与指令微调,支持 92 种编程语言。与通用模型相比,专用代码模型在自动补全、跨文件上下文理解、错误定位与单元测试生成等任务上有系统性优势,这源于其训练数据分布更贴近真实代码库。DeepSeek-Coder-V2 则是深度求索推出的混合专家架构(MoE)代码模型,完整版参数量达 236B,但其轻量蒸馏版本在 7B–16B 区间提供了接近大模型的代码能力,适合本地部署场景。选择专用代码模型而非通用模型,通常能在相同参数规模下获得明显更好的编程辅助效果。
学习 AI/ML 与通用推理问答
通用知识与推理任务适合选择综合能力强的指令模型。Llama 3.1 8B 与 Qwen2.5 14B 都是稳妥之选,后者在中文和复杂推理上表现更好。如果偏向数学与逻辑推理,可以尝试带推理链能力的模型,但需注意这类模型输出更长、更耗上下文。
设计生成
这里需要澄清一个常见误区:Ollama 运行的是文本类大语言模型,并不直接生成图像。若“设计生成”指的是图片、UI 或视觉素材,需要的是 Stable Diffusion 这类扩散模型(可通过 ComfyUI、Automatic1111 等工具运行),而非 Ollama。LLM 能做的是辅助设计——比如生成设计说明、CSS/HTML 代码、创意文案或提示词。16GB 显存同样足以运行主流的 SDXL 模型。
Stable Diffusion 是基于扩散过程的图像生成模型,其工作原理与 LLM 有本质区别:它通过逐步去除噪声将随机噪声图还原为符合文本描述的图像,而非自回归地生成文字 token。SDXL(Stable Diffusion XL)是目前主流的开源图像生成基座,基础模型体积约 6.5GB,16GB 显存可流畅运行并支持较大分辨率输出。ComfyUI 以节点式工作流见长,适合精细控制生成流程;Automatic1111(WebUI)则以操作界面友好著称,适合初学者快速上手。值得注意的是,在同一台机器上同时运行 LLM 与 Stable Diffusion 时,两者会竞争显存资源,通常需要分时使用而非并行运行。
上手建议与调优要点
对新手来说,与其一次下载十几个模型,不如从两三个覆盖核心需求的模型入手:一个代码模型(如 Qwen2.5-Coder 14B)、一个通用模型(如 Llama 3.1 8B 或 Qwen2.5 14B),再根据需要补充图像生成工具链。
实际使用中还有几个提升体验的关键点:
- 量化等级权衡:Q4_K_M 在体积与质量间平衡较好,追求质量可选 Q5、Q6,但显存占用会上升。
- 上下文长度:更长的上下文会占用额外显存,处理长文档或代码库时需在窗口大小与速度间取舍。
- 监控显存占用:运行时留意是否发生 CPU 卸载,若速度骤降,说明模型或上下文超出了显存承载。
小结
RTX 5060 Ti 16GB 搭配 32GB 内存,是一套相当适合本地 LLM 入门与进阶的配置。它能流畅运行 7B–14B 级别的模型,覆盖编程、学习和问答的绝大多数需求;30B 级别虽可尝试,但需接受速度上的妥协。真正的关键不在于追求最大参数,而在于为每类任务选对专用模型,并合理设置量化与上下文——这才是把有限显存价值最大化的正确姿势。
相关推荐
AI Agent入门详解:为何它是继图形界面后的下一次计算革命
本文系统讲解AI Agent是什么:它是基于大模型、能自主规划与执行任务的智能体。文章解读比尔·盖茨为何称其为继命令行、图形界面后的第三次计算革命,剖析Agent=LLM+规划+记忆+工具的技术架构,并探讨Agent与机器人结合的前景及开发者的机会。
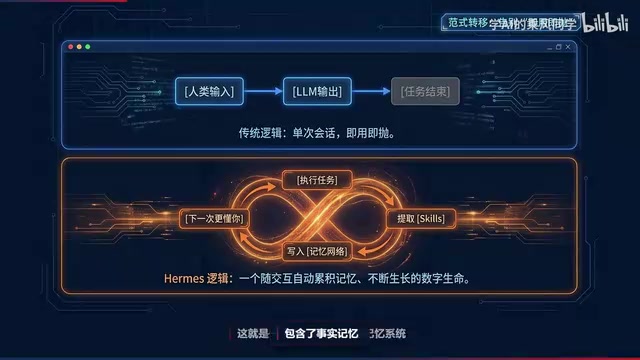
Hermes Agent 实测:告别单次机器人的进化型AI基建
Hermes Agent实测解析:一款GitHub超8万star的开源AI Agent框架,具备三层记忆系统、跨平台部署、技能库与多智能体协作能力。本文梳理其架构、安装与实战能力,帮你判断是否值得从传统聊天机器人迁移。
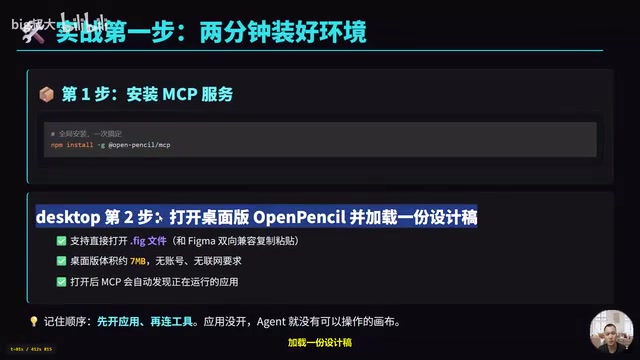
OpenPencil MCP实战:让AI Agent直接读改设计稿
OpenPencil是MIT开源的设计工具,一条命令接入MCP,让AI Agent直接读改本地设计稿。本文详解从安装、接入Claude Code与Cursor到五步工作法的完整实战流程。