RTX 5060 Ti 16GB被抢购:AI热潮下的显卡新宠

RTX 5060 Ti 16GB因显存与性价比成AI用户抢购焦点,折射硬件市场转向。
文章从Reddit社区讨论切入,分析RTX 5060 Ti 16GB显卡被AI用户抢购的现象。核心原因在于16GB显存能满足主流开源模型推理需求,且价格相对亲民,形成每美元性能比优势。购买者从游戏玩家扩展至独立开发者、AI爱好者和小型工作室,显卡定位从娱乐转向生产力。抢购潮导致供应紧张和二级市场涨价,同时推动AI民主化,降低本地推理门槛。厂商需平衡游戏与AI用户需求,优化软件生态。结论指出,AI普及正重塑硬件市场,显存和算力需求将成为新常态。
引言:AI需求催生显卡抢购潮
在AI浪潮席卷全球的当下,硬件市场正经历一场意想不到的转变。据Reddit社区的一则热门讨论,用户们已经开始成群结队地购买RTX 5060 Ti 16GB显卡,而背后的驱动力并非游戏,而是AI。帖子中一句“Oh look, thats us!”(哦看,那就是我们!)道出了许多AI实践者的心声。
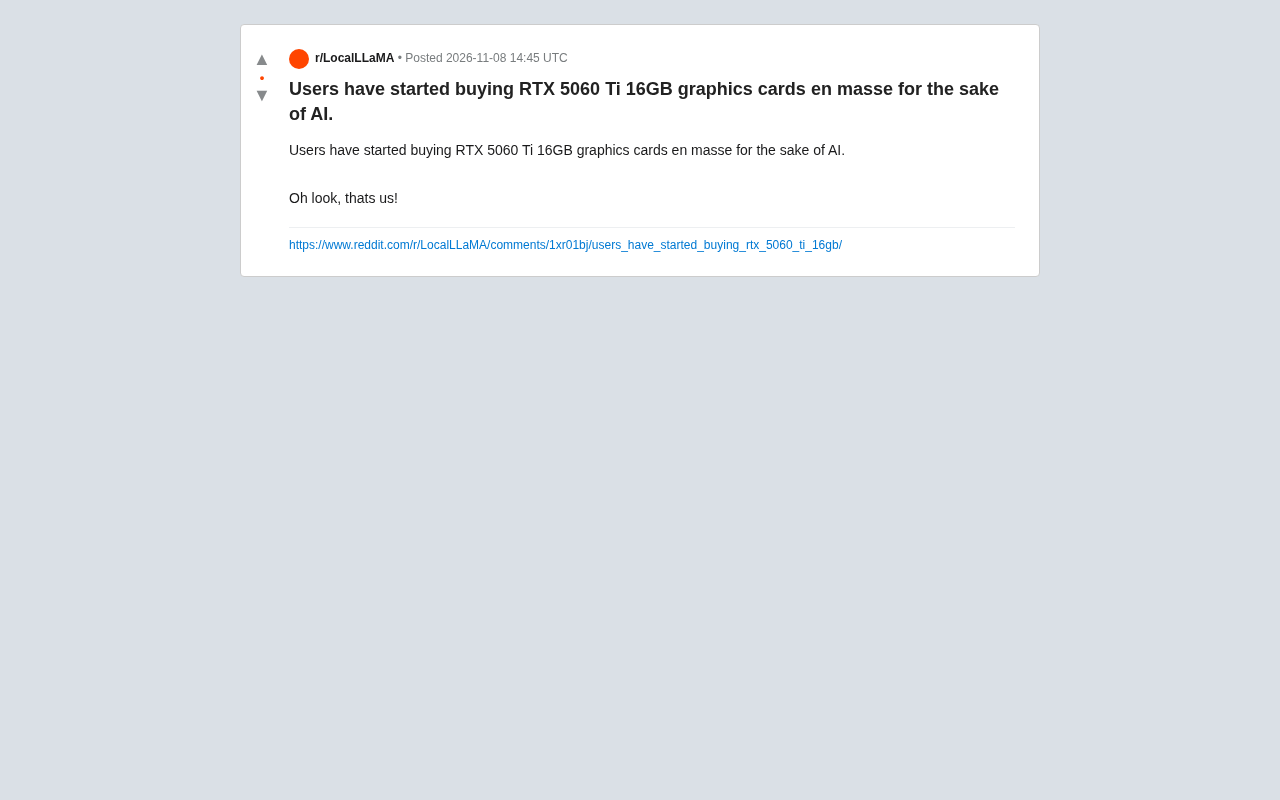
这并非孤例。随着本地AI模型部署的门槛降低,越来越多的开发者、研究者和爱好者开始寻找性价比高的硬件方案。RTX 5060 Ti 16GB凭借其显存容量和相对亲民的价格,成为了这场抢购潮中的焦点。本文将从多个角度分析这一现象背后的原因、影响以及潜在的挑战。
为什么是RTX 5060 Ti 16GB?
显存容量:AI推理的硬门槛
对于本地AI推理而言,显存容量往往是决定模型能否运行的关键因素。16GB的显存使得RTX 5060 Ti能够承载更大参数的模型,或在同一模型下支持更长的上下文长度。相比同价位段常见的8GB显卡,16GB提供了更充裕的缓冲空间,减少了因显存不足而导致的性能骤降或运行失败。
据Reddit用户的反馈,这一容量恰好满足了当前主流开源模型(如Llama系列、Stable Diffusion等)的推理需求,成为了“甜点级”选择。
显存(VRAM)是显卡上专用的高速内存,与系统内存(RAM)相互独立。在AI推理过程中,模型权重、激活值、KV缓存等都需要驻留在显存中才能被GPU高效访问。当显存不足时,系统会尝试将部分数据交换到系统内存或硬盘,导致带宽骤降和延迟激增,严重时直接触发内存不足错误。对于大语言模型,参数量与显存占用大致呈线性关系:FP16精度下每十亿参数约需2GB显存,量化到INT8或INT4可显著降低需求,但上下文长度增加又会推高KV缓存占用。因此,16GB显存成为运行中等规模开源模型的一个实用门槛。
性价比优势:平衡性能与成本
虽然RTX 5060 Ti并非旗舰产品,但其定价策略精准地切入了AI入门用户的心理价位。对于不想投入过多资金购买专业级显卡的用户来说,这款产品提供了可接受的性能与合理的价格。社区讨论中,不少用户表示,在对比了多款显卡后,RTX 5060 Ti 16GB在每美元性能比上表现突出,尤其适合长时间运行的推理任务。
每美元性能比是评估硬件性价比的常用指标,但在AI场景下需结合具体任务衡量。游戏性能主要看帧率,而AI推理更关注显存带宽、容量和特定算子效率。例如,RTX 5060 Ti的显存位宽和带宽可能低于高端卡,但在显存容量满足需求时,其推理吞吐量足以应对个人使用。此外,二手市场保值率、驱动成熟度和框架兼容性也会影响总拥有成本。社区讨论中强调的“甜点级”选择,正是显存容量、价格与可用性三者平衡的结果。
用户行为分析:谁在买?为什么买?
目标人群画像
从Reddit讨论的参与者和相关评论来看,购买者主要包括:
- 独立开发者与研究者:需要本地环境进行模型测试和原型开发;
- AI爱好者与学习者:希望在家用电脑上体验最新的AI应用;
- 小型工作室:预算有限但需要运行生成式AI工具进行内容创作。
本地AI推理通常指在用户自己的硬件上运行模型,而非调用云端API。其优势包括数据隐私可控、无按次计费成本、可离线使用和深度定制;劣势则是硬件投入高、维护复杂且性能受限于本地设备。独立开发者和爱好者常使用Ollama、LM Studio、text-generation-webui等工具简化部署,这些工具对显存容量较为敏感。小型工作室则可能运行Stable Diffusion等生成式模型,16GB显存能支持较高分辨率的图像生成和批量处理,减少因显存不足导致的中断。
购买动机:从游戏到AI的转变
传统上,显卡的购买主力是游戏玩家。然而,随着AI应用的普及,越来越多的用户将显卡视为生产力工具。帖子中的“Oh look, thats us!”正是这种身份认同的体现——AI实践者意识到自己已成为显卡市场的重要力量。这种转变也促使厂商重新思考产品定位和营销策略。
市场影响与潜在挑战
供需关系紧张
抢购潮直接导致了RTX 5060 Ti 16GB的供应紧张。部分地区出现缺货现象,二级市场价格也有所上涨。对于真正需要显卡进行AI工作的用户来说,这无疑增加了获取成本。同时,黄牛囤货行为也可能加剧市场失衡。
对AI民主化的推动
从积极的一面看,这一现象反映了AI技术的民主化趋势。更低的硬件门槛意味着更多人能够参与到AI创新中,不再受限于云端服务的成本和隐私顾虑。本地推理的兴起也带动了相关工具链和社区的发展。
厂商的机遇与挑战
对于NVIDIA等厂商而言,AI用户群体的崛起既是机遇也是挑战。如何平衡游戏玩家与AI用户的需求,如何通过产品细分满足不同场景,将成为未来竞争的关键。此外,软件生态的优化(如驱动支持、框架兼容性)同样重要。
结论:AI硬件需求的新常态
RTX 5060 Ti 16GB的抢购潮并非偶然,而是AI普及过程中的一个缩影。它揭示了硬件市场正在因AI而重塑,用户需求从单纯的图形性能转向综合的AI算力。随着模型规模的持续增长和应用场景的不断拓展,对显存和算力的需求只会更加强烈。对于厂商和用户而言,适应这一新常态,或许比追逐短期的抢购更为重要。
(本文基于Reddit社区讨论及公开信息分析,不构成购买建议。)
相关推荐
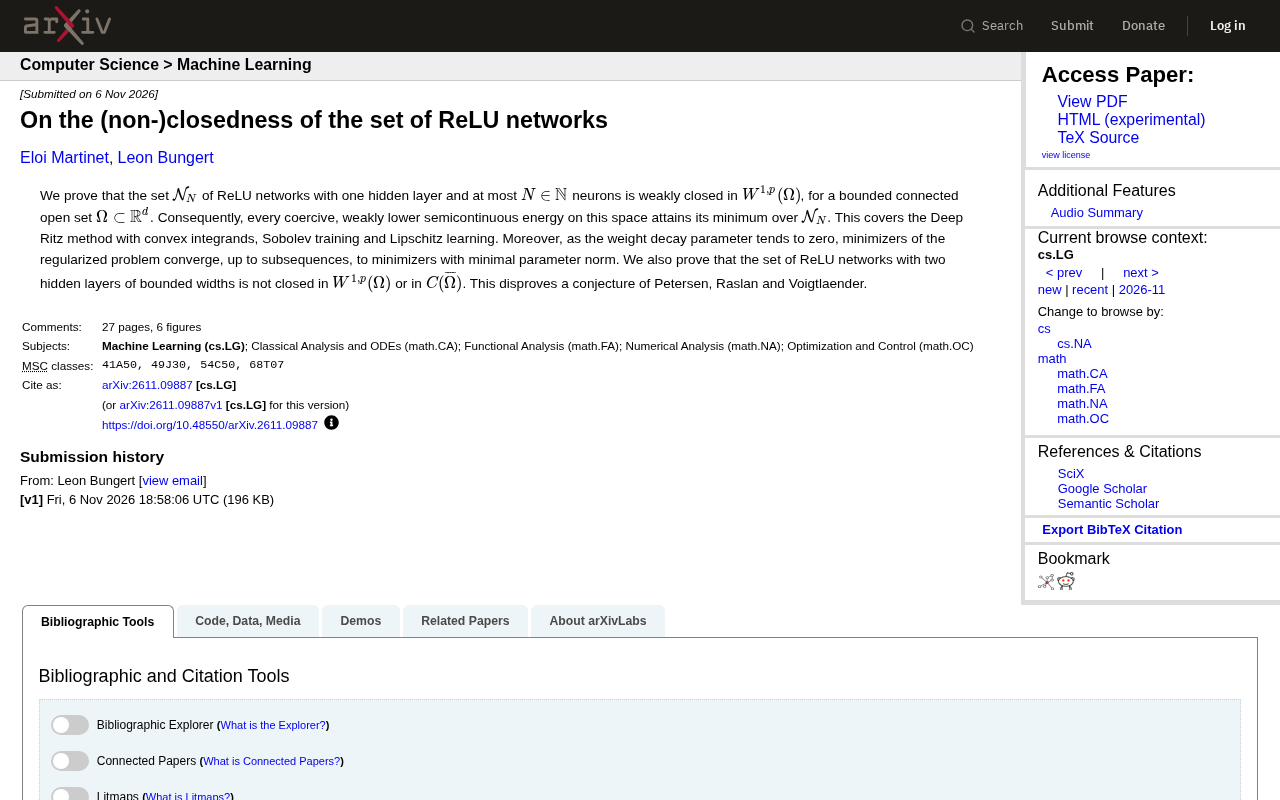
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
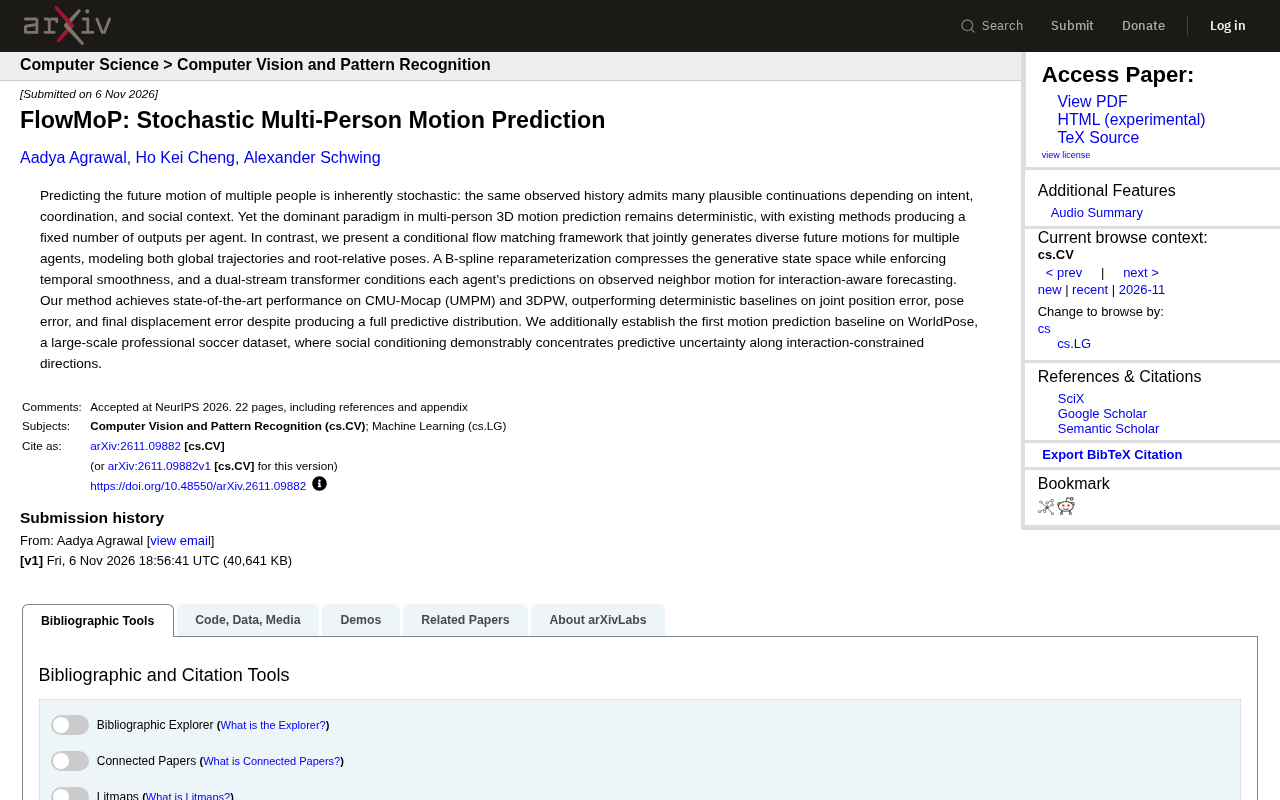
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
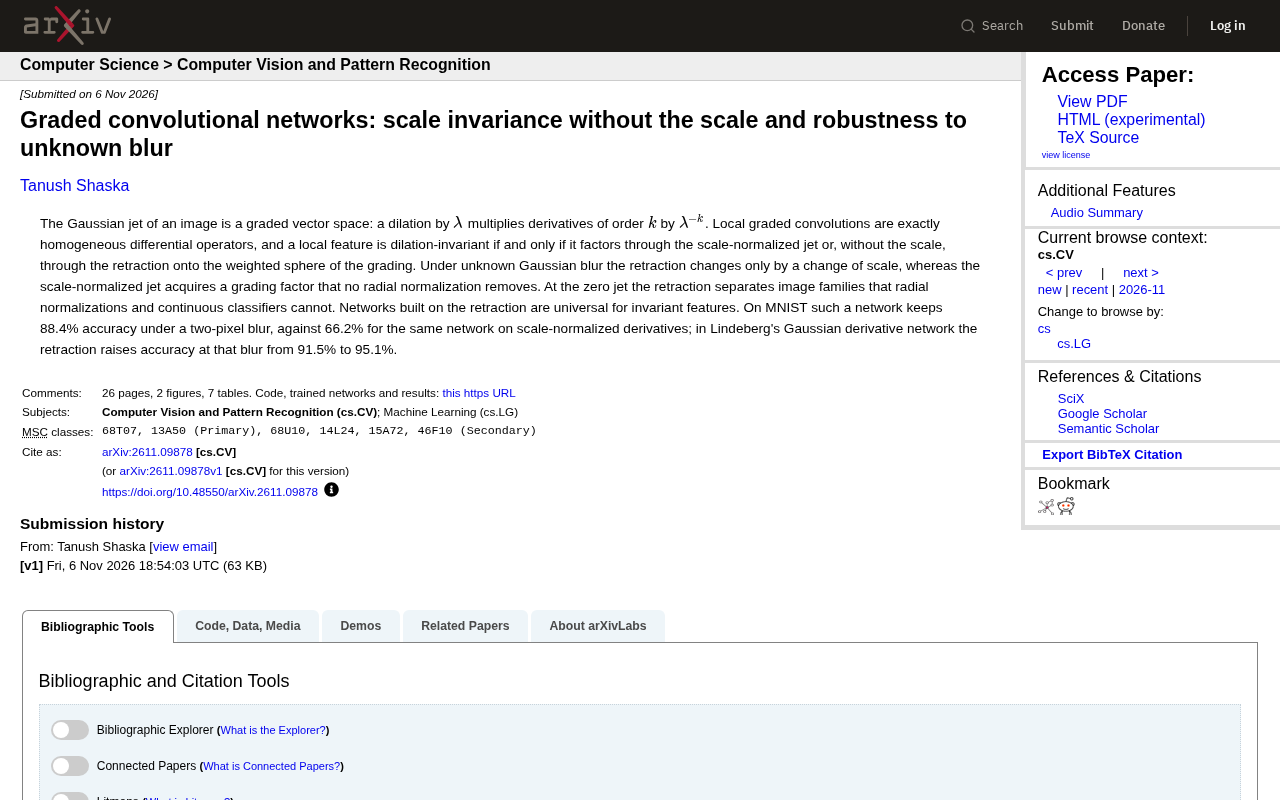
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。