RTX 5090对决M5 Ultra:本地AI推理谁更强

RTX 5090与M5 Ultra代表本地AI推理的两种路线:速度与容量的取舍。
文章对比了NVIDIA RTX 5090与苹果M5 Ultra在本地AI推理上的差异。规格上,5090算力419 TFLOPS、带宽1.8TB/s但仅有32GB显存,M5 Ultra为110 TFLOPS、1.2TB/s带宽但支持最高256GB统一内存。在Qwen 3.8 27B 4-bit测试中,5090提示处理约3000 tokens/秒、开启MTP后生成136 tokens/秒,均领先M5 Ultra的1700和100。核心决策公式为推理速度≈带宽÷模型大小:模型能装进32GB显存时5090更快,超出则只有M5 Ultra能胜任。功耗方面,M5 Ultra约214瓦远低于5090的300-575瓦,影响散热、噪音与长期成本。结论是没有绝对赢家,应按典型模型尺寸选择。
苹果刚刚开始出货搭载M5 Ultra的Mac Studio,一场关于本地AI推理硬件霸主的讨论随之升温。NVIDIA RTX 5090与苹果M5 Ultra,一个是消费级显卡的性能天花板,一个是苹果工作站芯片的最新旗舰,它们代表了两种截然不同的AI计算路线。YouTube技术频道对两者的规格和实际推理性能进行了详细对比,结果比简单的跑分输赢更有参考价值。
规格对比:算力与带宽各有侧重
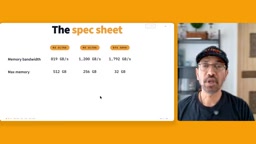
从纸面参数看,两者的设计哲学差异一目了然。M5 Ultra的内存带宽为1.2TB/s,RTX 5090达到1.8TB/s,显卡在带宽上仍保持领先。但在内存容量上,M5 Ultra可以订购256GB统一内存,未来还将支持512GB配置,而RTX 5090仅有32GB显存。
计算性能方面差距更为悬殊:M5 Ultra约为110 TFLOPS,而RTX 5090可达到419 TFLOPS,几乎是前者的四倍。功耗同样天差地别——M5 Ultra持续峰值负载约214瓦,RTX 5090则在300至575瓦之间大幅波动。这意味着如果你追求能效比和静音体验,苹果芯片的优势非常明显;如果追求绝对算力密度,NVIDIA仍然占据上风。
统一内存架构是理解苹果芯片定位的关键。传统PC中,CPU使用系统内存(DDR),GPU使用独立显存(GDDR/HBM),两者之间通过PCIe总线搬运数据,带宽通常只有几十GB/s。苹果的M系列芯片将CPU、GPU、神经引擎和内存封装在同一块硅片或封装体内,所有计算单元共享同一块高带宽内存池,这就是"统一内存"的含义。它的直接好处有三个:一是GPU可以直接寻址全部内存容量,不再受限于独立显存的大小;二是省去了CPU与GPU之间的数据拷贝,降低了延迟;三是整体功耗和封装面积大幅缩小。这正是M5 Ultra能配置256GB甚至512GB内存、而RTX 5090受限于32GB显存的根本原因。不过统一内存也有代价——内存控制器需要同时服务多个计算单元,峰值带宽通常低于同代的专用显存方案,这解释了为什么M5 Ultra的1.2TB/s仍低于5090的1.8TB/s。
推理实测:Qwen 3.8 27B模型上的表现
在Qwen 3.8 27B 4-bit量化、6K提示词的实际测试中,两款硬件的表现揭示了一个关键规律:提示处理和生成速度遵循不同的瓶颈逻辑。
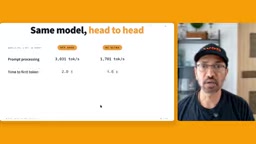
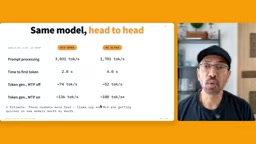
RTX 5090的提示处理速度约为3000 tokens/秒,M5 Ultra约为1700 tokens/秒。首token延迟方面,5090约2秒,M5 Ultra约4秒。
Token生成环节,关闭MTP(多token预测)时,5090约75 tokens/秒,M5 Ultra约52 tokens/秒;开启MTP后,5090飙升至136 tokens/秒,M5 Ultra达到约100 tokens/秒。这些数字说明,在模型能装进32GB显存的前提下,RTX 5090的推理速度优势是实质性的——提示处理快将近一倍,生成速度也有明显领先。
但需要提醒的是,这些数据是基于当前快速迭代的推理引擎得出的估算值,实际表现会随软件优化而变化。
MTP(Multi-Token Prediction,多token预测) 是近年来推理加速的一项重要技术。传统自回归生成每次只能输出一个token,因为每个新token都依赖前一个token的计算结果,形成串行瓶颈。MTP通过在模型中增加额外的预测头,让模型在一次前向传播中同时预测多个后续token,再通过验证机制确保输出质量,从而在保持结果基本一致的前提下大幅提升吞吐量。文中5090从75 tokens/秒提升到136 tokens/秒、M5 Ultra从52提升到100,正是MTP带来的效果。需要注意的是,MTP对显存占用和算力都有额外要求,因此在小显存设备上可能无法启用或收益有限,这也是为什么是否支持MTP会直接影响不同硬件的实际表现排序。
核心权衡:模型大小决定硬件选择
视频中给出了一个极为实用的决策公式:推理速度(tokens/秒)≈ 内存带宽 ÷ 模型大小。这个公式解释了为什么两款硬件的适用场景完全不同。
如果模型加上必要开销能装进32GB显存,RTX 5090凭借更高的带宽和算力,能提供更快的推理体验。但一旦模型超出32GB——无论是更大的未量化模型,还是混合专家(MoE)架构——RTX 5090就无能为力了,而M5 Ultra凭借最高256GB(即将支持512GB)的统一内存,可以轻松容纳这些大模型。
这本质上是一道"速度还是容量"的选择题。对于运行70B以下量化模型的用户,5090是更快的选择;对于需要运行超大模型、未量化模型或MoE架构的开发者,M5 Ultra几乎是唯一能在桌面级设备上完成任务的选项。
混合专家(MoE,Mixture of Experts)架构是当前大模型的主流设计之一。与传统的稠密模型(每次推理都激活全部参数)不同,MoE模型包含多个"专家"子网络,每次前向传播只激活其中一小部分,因此在同等推理成本下可以拥有更大的总参数量。例如一个总参数670亿的MoE模型,每次可能只激活约120亿参数。这对硬件的要求变得复杂:虽然激活参数少、计算量低,但全部专家权重仍需驻留在内存中,因此显存占用取决于总参数量而非激活参数量。这正是文中提到的关键点——MoE模型很容易超出32GB显存,却在M5 Ultra的大容量统一内存中游刃有余。对于这类模型,M5 Ultra不仅容量占优,其带宽÷激活参数的比值也往往能带来不错的生成速度,是桌面端运行大型MoE模型的现实选择。
功耗与散热的隐性成本
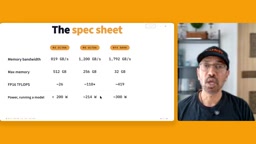
功耗差异不只是电费问题。RTX 5090在持续峰值负载下300至575瓦的功耗,意味着你需要足够功率的电源、高效的散热方案,以及在长时间推理任务中不可忽视的噪音。M5 Ultra约214瓦的持续功耗,让它在Mac Studio紧凑机身内就能稳定运行,对工作室环境更为友好。
这种差异在7×24小时持续推理的场景下会被放大——功耗差距直接转化为散热设计复杂度和长期运行成本的差距。
能效比(性能每瓦) 在持续推理场景中的重要性常被低估。RTX 5090的300至575瓦动态功耗意味着散热系统必须按最坏情况设计,通常需要三风扇、多槽厚度的散热器,加上整机电源要预留充足余量。而M5 Ultra约214瓦的持续功耗使其能在Mac Studio这类紧凑、近乎无声的机身内稳定运行。对于需要7×24小时不间断推理的工作室或小型服务器环境,功耗差异会直接转化为三重成本:电费、空调制冷负担,以及因散热设计复杂度带来的硬件采购与维护成本。此外,高功耗显卡在长时间满载下的降频风险也需纳入考量,实际持续性能可能与短时跑分存在差距。因此评估本地AI硬件时,不能只看峰值算力,还要结合典型工作负载下的能效与热设计。
谁才是你的AI利器?
这场对比没有绝对的赢家,只有更适合具体需求的选择。RTX 5090在32GB显存能覆盖的范围内提供无可匹敌的推理速度,适合模型尺寸可控、追求极致响应速度的用户。M5 Ultra则以超大统一内存容量和优异的能效比,打开了桌面端运行大模型的可能性。
对本地AI部署感兴趣的开发者,建议根据自己的典型模型尺寸来做决定:先量一下模型的显存占用,再对照这个公式估算预期速度,答案会比任何跑分都更清晰。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。