如何构建AI工具:从问题定义到监控的7步清单
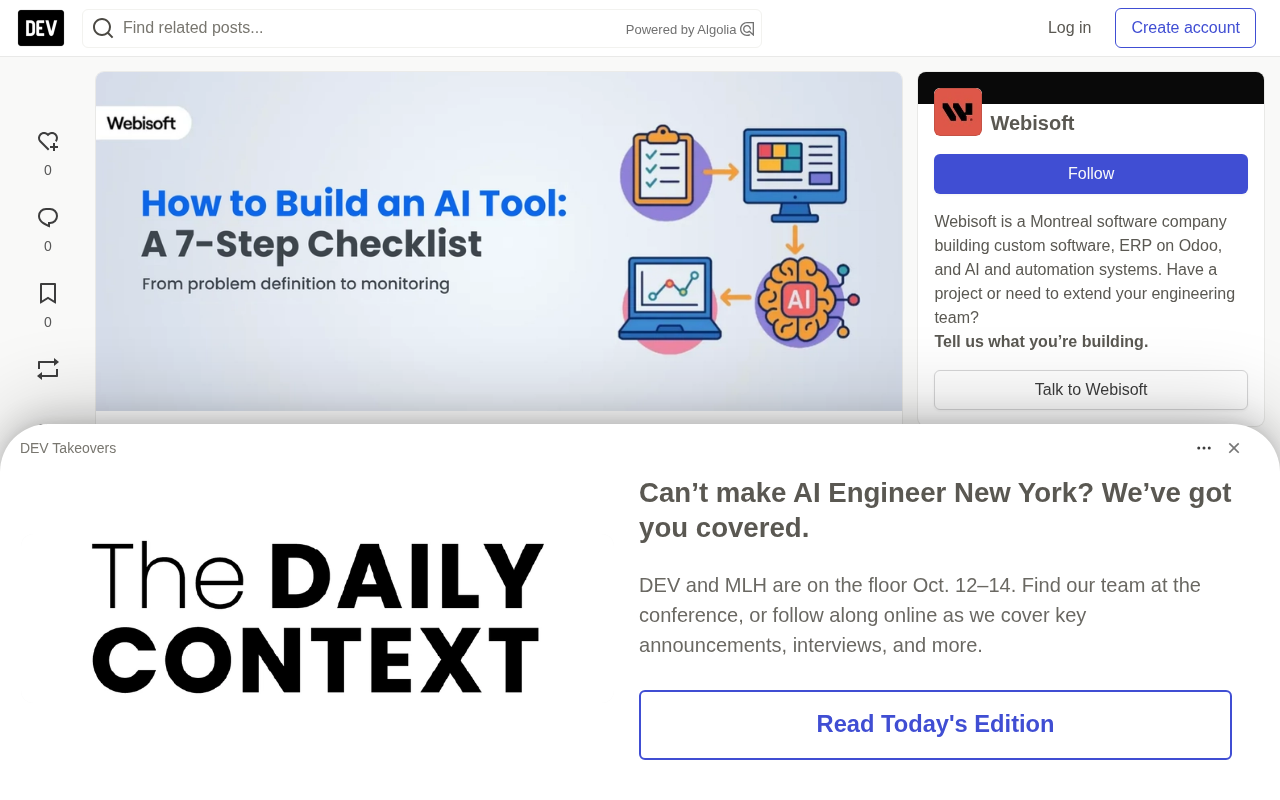
AI工具落地是涵盖问题定义、数据、训练、部署与监控的七步闭环,而非只训练一个模型。
本文提炼Webisoft实战指南,将AI工具构建拆为七步:先精确定义任务、输出和用户,再收集干净且标注一致的数据并按70/15/15等比例划分;随后按需选择Python、Scikit-learn、spaCy等工具,避免过度设计;训练时从简单模型起步,用验证集调参并防过拟合;评估时用留出测试集和精确率、召回率、F1等匹配指标;部署阶段打包模型、构建API并加安全机制;上线后则要监控模型漂移、持续补充新数据。指南估算标准项目需8至16周,其中数据准备和模型训练占比最大。全文强调:最大的错误不是技术选型,而是跳过问题定义直接写代码。
从客服工单自动打标到智能推荐系统,构建一个真正能落地的AI工具,远不止训练一个模型那么简单。Webisoft发布的一份实战指南将整个流程拆解为7个步骤,并以"自动按紧急程度标记客服工单"为贯穿案例,给出了每个环节的工具选择与避坑建议。
这篇文章提炼该指南的核心框架,并结合当前AI工程实践补充分析。
第一步:把问题定义清楚
在收集数据或写代码之前,先想明白你究竟在解决什么问题。"提升客户服务"这种目标太宽泛,无法指导后续决策。你需要定义具体任务、目标用户和预期产出。
以工单打标为例:任务是自动按紧急程度给客服工单分类;输出是高、中、低三个简单标签;用户是客服人员,他们根据标签决定响应优先级。这一步看似简单,实际上划定了整个项目的边界——它决定了你需要什么数据、怎么衡量成功、什么状态算"完成"。
第二步:收集和准备数据
模型从数据中学习,所以数据必须准确、有标注且干净。具体操作包括:
- 使用真实且相关的数据源,比如CRM或客服系统中已标注的工单记录
- 保持标签清晰一致,避免"可能紧急"这类模糊标注
- 清洗数据:去重、修复缺失值、统一格式(比如文本全部转小写)
- 训练前完成数据集划分:训练集70%-80%、验证集10%-15%、测试集10%-15%
一个容易被忽视的原则是:小而精的数据集往往胜过大而乱的数据集。数据质量对模型表现的影响,通常超过算法选择本身。
训练集、验证集与测试集的划分逻辑
这三个数据集各司其职:训练集用于让模型学习参数;验证集用于在训练过程中调参和选择模型版本,它相当于"模拟考";测试集则完全不参与训练和调参,只在最后评估时使用一次,代表模型在真实世界中的表现。之所以要严格隔离测试集,是因为如果反复用测试集调参,模型就会间接"记住"它,评估结果将虚高,无法反映真实泛化能力。常见的70/15/15或80/10/10比例并非硬性规定,数据量越小,验证集和测试集的比例通常需要适当提高,以保证评估结果的统计可靠性。
精确率、召回率与F1分数
在分类任务中,准确率(accuracy)只统计预测正确的比例,在类别不均衡时会产生误导。例如1000张工单中只有20张真正紧急,模型全部预测为"不紧急"也能达到98%准确率,却毫无实用价值。精确率(precision)衡量"被判为紧急的工单中有多少是真紧急",召回率(recall)衡量"真正紧急的工单中有多少被找出来",二者往往此消彼长。F1分数是精确率与召回率的调和平均,用于综合权衡。在工单打标场景中,如果漏掉紧急工单代价很高,就应优先保证高召回率。
第三步:选对工具和框架
技术栈的选择应匹配项目需求,而非追求最新最热。
- 语言:Python凭借简洁性和丰富的库生态,是AI开发的主流选择
- 结构化数据:Scikit-learn或XGBoost
- 自然语言任务:spaCy或Hugging Face框架
- 深度学习:TensorFlow或PyTorch
- 开发环境:实验阶段用Google Colab或Jupyter Notebook起步,需要规模化时再迁移到AWS SageMaker或GCP
核心原则是不要过度设计技术栈。用最简单的工具把事做好,有需要再升级。
第四步:训练模型
训练的本质是让模型从数据中识别模式并做出预测。这里有五个实操要点:
- 从简单模型开始,比如逻辑回归或决策树,先观察数据的行为特征
- 逐步增加复杂度,基础模型效果不佳时再转向神经网络
- 用验证集微调学习率、层数等参数,避免过拟合
- 使用dropout或正则化等技术防止模型"死记硬背"训练数据
- 记录每次实验,MLflow或Weights & Biases可以帮你对比结果、保持条理
先简后繁的策略能帮你快速判断:问题到底出在数据上,还是出在模型能力上。
过拟合、正则化与dropout
过拟合指模型在训练数据上表现极好,但在新数据上表现很差,本质是它"背下"了训练样本的噪声和细节,而没有学到通用规律。判断过拟合的典型信号是:训练集准确率持续上升,而验证集准确率停滞甚至下降。正则化通过在损失函数中加入对模型复杂度的惩罚(如L1、L2正则),抑制参数过大,从而提升泛化能力。Dropout是神经网络中常用的正则化手段,训练时随机"关闭"一部分神经元,迫使网络不依赖某几个特定节点,相当于一种廉价的模型集成。对于逻辑回归这类简单模型,正则化强度是核心超参数;对于深度网络,dropout比例和学习率同样需要仔细调校。
第五步:评估模型准确度
用模型没见过的数据来测试,才能判断它是否真的可以投入使用。
- 使用留出的测试集,训练和验证阶段不要碰它
- 选择匹配任务的指标:分类任务看精确率、召回率和F1分数;预测任务用MAE或RMSE
- 研究错误案例,分析哪些输入导致了错误结果,这可能揭示偏差、标注问题或模型盲区
单一准确率指标远远不够。模型还需要在日常场景、边缘案例和噪声数据中稳定工作。
第六步:部署工具
部署是把模型放进可运行的应用或服务中。
- 用joblib、pickle或ONNX打包模型,便于保存和迁移
- 构建接口:实时场景用Flask或FastAPI创建REST API;定时场景设置批量处理
- 搭建基础设施:小项目用Heroku或Render即可;大型系统考虑Docker容器、Kubernetes和AWS等云平台
- 加入安全机制:输入校验、使用限制和日志记录
部署不是终点,而是实际测试的起点。
第七步:持续监控和改进
现实世界在变,数据在变,模型需要持续更新。
- 用Prometheus或Grafana监控线上表现
- 关注模型漂移:如果输入分布改变或准确率下降,可能需要重新训练
- 定期收集和标注新数据,持续优化模型
- 记录失败和边缘案例,这些是未来训练中最有价值的素材
在医疗、法律等敏感领域,高风险预测必须有人工审核环节,这是保证工具可信和安全的前提。
模型漂移(Model Drift)
模型漂移指模型上线后性能随时间下降的现象,通常分为两类。数据漂移(data drift)指输入数据的分布发生变化,例如客服工单的措辞、渠道或业务类型改变,导致模型看到的输入与训练时不同。概念漂移(concept drift)指输入与输出之间的映射关系本身改变,例如业务调整后"紧急"的判定标准发生变化。两者的应对方式不同:数据漂移往往需要补充新数据重新训练,概念漂移则可能需要重新定义标签甚至重新标注历史数据。监控漂移的常用做法包括统计输入特征的分布变化(如PSI指标)、跟踪线上预测结果的分布,以及定期抽样人工复核。建立自动化的再训练触发机制,是维持工具长期有效的关键。
整个流程需要多长时间?
根据该指南的估算,一个标准AI项目通常需要8到16周,前提是团队具备相应的技能水平:
| 阶段 | 预估时间 |
|---|---|
| 问题定义 | 1-2周 |
| 数据收集与准备 | 2-4周 |
| 工具与框架选择 | 1周 |
| 模型开发与训练 | 2-6周 |
| 模型评估 | 1-2周 |
| 部署准备 | 1-2周 |
| 部署与测试 | 1-2周 |
| 监控与迭代 | 持续进行 |
实际工期会因复杂度和行业差异而有较大波动,模型训练阶段的时间跨度最大(2-6周),这与数据质量、问题难度和调参轮次直接相关。
常见问题
不写代码能构建AI工具吗? 可以。无代码AI平台能帮你创建基础工具,但复杂项目通常仍需编程能力或专家支持。
什么编程语言最适合AI? Python最主流,因为简洁且库生态丰富。R、Java和C++也在特定项目中广泛使用。
这份清单的价值在于它把AI开发从"训练一个模型"的狭隘视角,扩展为包含问题定义、数据工程、部署运维和持续迭代的完整闭环。对于准备启动AI项目的团队来说,最容易犯的错误不是技术选型失误,而是跳过第一步直接写代码。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。