如何选择性价比最高的AI模型?兼谈LangChain文档迁移困惑

从模型性价比选型到LangChain文档重组,梳理AI应用开发的两大核心痛点与应对策略。
本文针对AI应用开发社区中反复出现的两个困惑展开讨论:如何选择性价比最优的大语言模型,以及如何应对LangChain版本升级后文档结构的剧变。在模型选型上,文章强调应结合价格、任务完成质量、延迟三个维度按场景评估,并推荐"分级路由"策略降低整体成本——简单任务用轻量模型,复杂任务再升级到旗舰模型。在LangChain文档问题上,文章指出大量第三方集成已被拆分至`langchain-community`或独立合作伙伴包,内容并非消失而是重新归档,建议通过精确搜索类名、查阅API参考文档和锁定依赖版本来解决"照着文档写却报错"的问题。文章最终落脚于一条通用原则:在快速演进的AI生态中,建立可持续的评估与验证习惯,比追求一个静态的"标准答案"更有实际价值。
在AI应用开发社区,有两个问题反复出现:一是究竟该选哪个大语言模型才能兼顾成本与性能,二是快速迭代的开发框架文档让人无所适从。一位 Reddit 开发者近期同时抛出了这两个疑问——他想知道大家在用什么性价比最高的模型、成本如何,同时抱怨 LangChain 的 TypeScript 文档在 v1 版本后变化太大,原来能找到的 PDF 加载器、Hugging Face 嵌入集成等内容都不见了。
这两个看似零散的问题,恰恰折射出当下 AI 应用开发者的两大共性痛点。本文结合社区讨论,梳理一套实用的思路。
性价比模型该怎么选
"最好的模型"其实是个伪命题,正确的问法应该是"在我的任务场景下,哪个模型的性价比最高"。模型选型无法脱离具体用途,因为不同任务对推理能力、上下文长度、响应延迟的要求差异极大。
评估性价比,核心是把三个维度放在一起看:单位 token 的价格、任务完成质量、以及调用的吞吐与延迟。一个便宜但需要反复重试才能得到正确结果的模型,实际成本未必低;一个昂贵但一次到位的模型,在复杂任务上反而可能更划算。
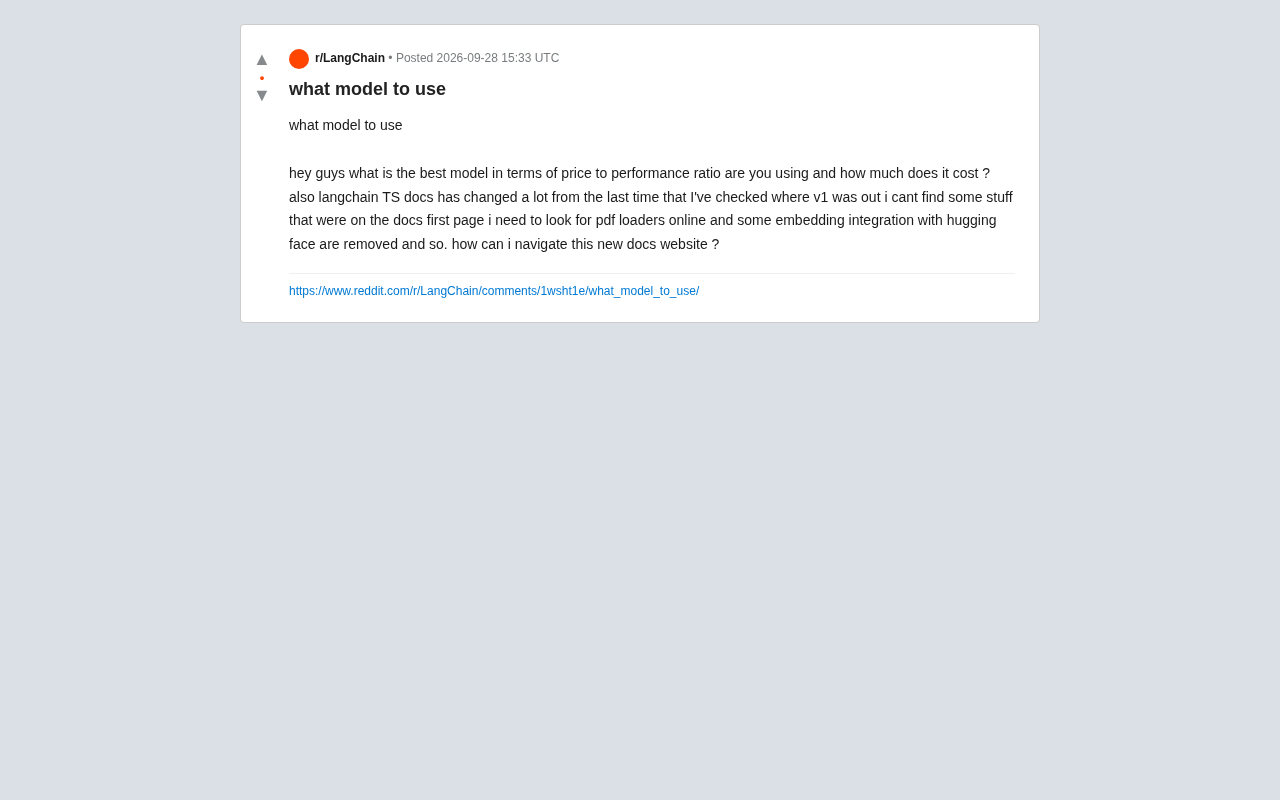
对于开发者提到的成本问题,实践中有几条经验值得参考。简单的分类、抽取、格式化任务,优先用小参数或轻量级模型,成本可以压到极低;需要复杂推理、代码生成或长文档理解的任务,才动用旗舰模型。很多团队采用"分级路由"策略——先用便宜模型处理,遇到低置信度的情况再升级到强模型,整体成本能显著下降。
别忽视本地与开源方案
如果调用量大且对数据隐私敏感,自托管开源模型可能比按 token 付费的 API 更经济。当然这需要权衡硬件投入和运维成本,只有在规模足够的情况下才划算。对于中小项目,托管 API 的按量付费依然是门槛最低的选择。
常见的可自托管开源模型包括 Meta 的 Llama 系列、Mistral 系列以及 Qwen 等,可通过 Ollama、vLLM 或 llama.cpp 等推理框架在本地或私有服务器上运行。以 vLLM 为例,它支持连续批处理(continuous batching),能大幅提升 GPU 利用率,适合需要并发处理多路请求的生产场景。在成本测算上,自托管的盈亏平衡点通常出现在每月 API 费用超过云服务器租金的 1.5-2 倍时——低于这个门槛,自托管的运维复杂度往往得不偿失。Hugging Face 的 Inference Endpoints 和 Replicate 等托管推理服务则提供了一种折中方案:无需自行管理基础设施,同时比主流商业 API 的单 token 成本更低,适合中等规模调用量的项目。
LangChain 文档大改后如何应对
这位开发者的第二个困惑非常典型:LangChain 作为迭代极快的框架,文档结构在版本升级后经常发生较大调整。他找不到 PDF 加载器,也发现 Hugging Face 嵌入集成似乎被移除了。
实际上,这类内容大多不是被删除,而是被重新组织或拆分到了独立的集成包中。LangChain 近年来把大量第三方集成从主库剥离,迁移到了 langchain-community 或各自独立的合作伙伴包里。文档也随之按"集成"分类单独归档,首页不再罗列所有加载器,这就是很多人"找不到东西"的根源。
定位新版文档内容的技巧
面对改版后的文档,比起在首页逐层点击,更高效的做法是直接使用站内搜索或结合外部搜索引擎精确定位。查找 PDF 加载器时,搜索具体的类名或模块名,往往能直接跳到对应集成页面。Hugging Face 相关的嵌入功能通常也已移入独立的集成模块,需要额外安装对应的包。
另一个稳妥的参考是官方 API 参考文档和 GitHub 仓库中的示例代码。当叙述性文档更新滞后或结构混乱时,API 文档和源码里的用法通常更准确。同时务必确认自己安装的库版本与所查文档版本一致——版本错配是导致"照着文档写却报错"的最常见原因。
langchain-community 是 LangChain 在 v0.1 架构重组后引入的过渡性集成包,收录了大量由社区维护的第三方连接器,包括各类文档加载器、向量数据库适配器和嵌入模型接口。与此同时,部分使用频率较高或有官方合作关系的集成(如 OpenAI、Anthropic、Google)被拆分为独立的合作伙伴包,例如 langchain-openai、langchain-anthropic。这种拆分的初衷是减少主库的依赖膨胀,让用户按需安装,但也导致同一功能可能存在多个同名类分散在不同包中,且迁移路径并非总有明确文档记录。在升级版本前,查阅对应版本的 Migration Guide 并使用 langchain-cli 提供的迁移工具,可以减少手动排查的工作量。
给开发者的实用建议
把这两个问题放在一起看,可以提炼出一条通用原则:AI 生态迭代太快,与其追求"标准答案",不如建立可持续的评估和验证习惯。
模型选型上,建议先用少量真实样本对候选模型做小规模基准测试,记录质量、成本和延迟,用数据而非口碑做决策。框架使用上,锁定依赖版本、优先查阅 API 参考和源码、善用搜索,能省去大量因文档变动带来的困扰。
这类问题在社区中反复出现,本身也说明 AI 应用开发仍处于快速演进阶段,工具链和最佳实践都还没有完全稳定。保持灵活、动手验证,往往比等待一个"最优选择"更有效。
相关推荐
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
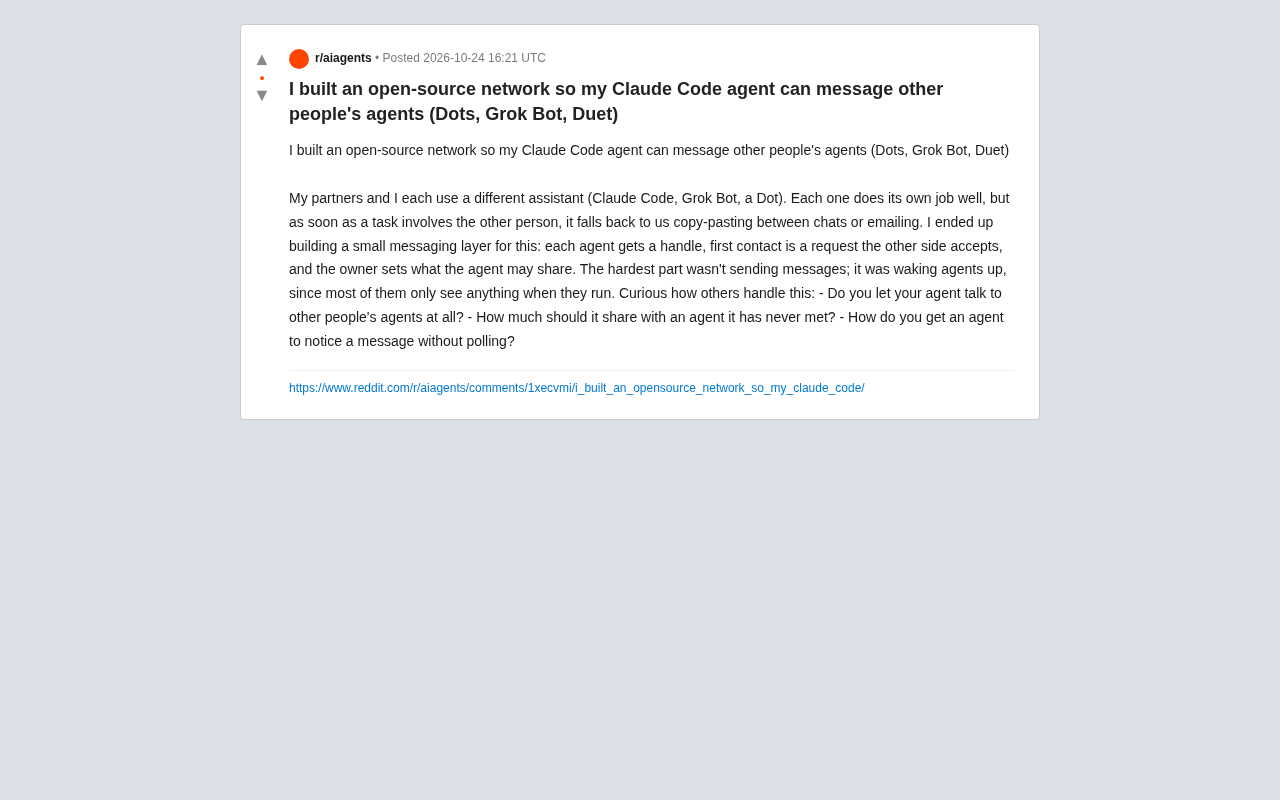
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。