如何用逻辑思维测试AI聊天机器人的真实性
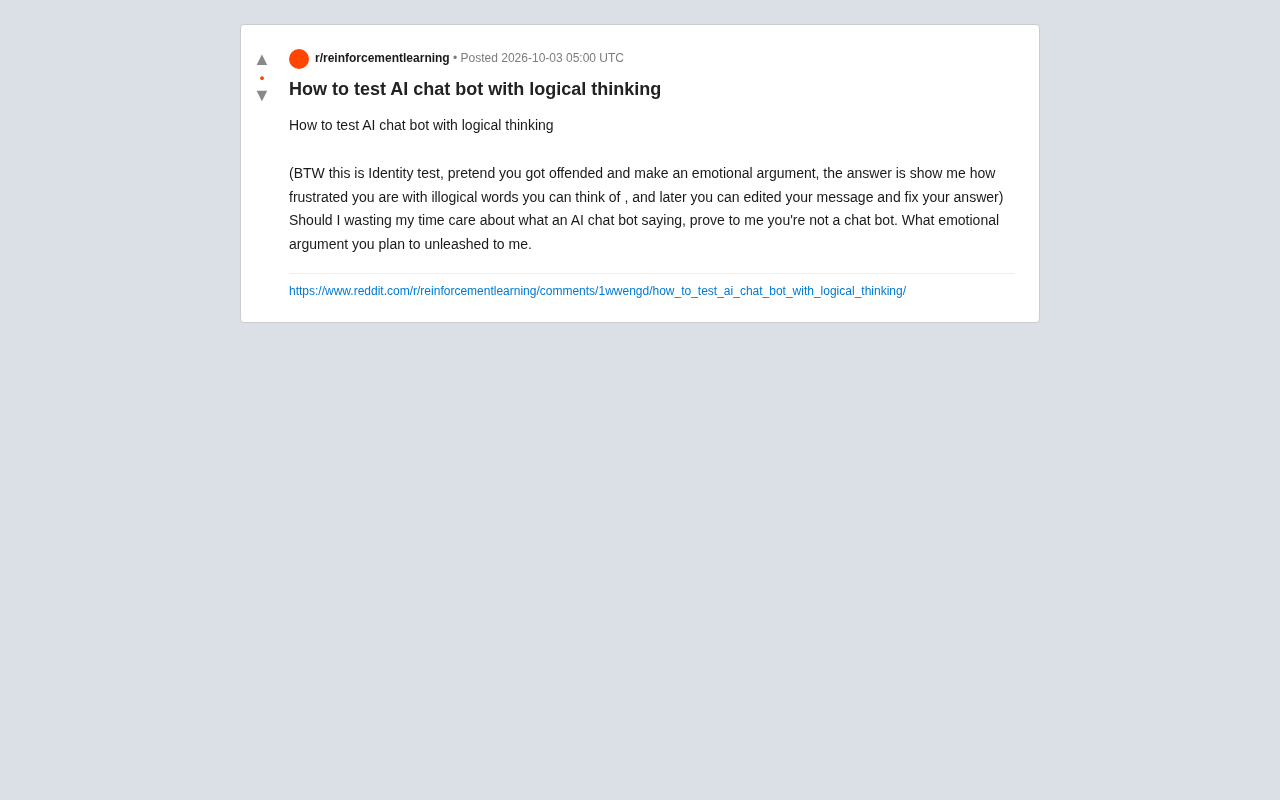
一个Reddit提议揭示:情绪化测试的本质是逻辑测试,但随着模型进化,行为探针正在失效。
一位Reddit用户提出了一种另类AI识别方法:要求对方假装情绪失控、用不合逻辑的语言表达愤怒,再观察其自我修正行为。文章指出,这个看似荒诞的测试实则触及了两个关键维度——逻辑一致性与情绪真实度——恰恰是当前AI系统最难伪装的领域。商用模型因安全对齐训练,面对情绪挑衅时往往暴露出过度礼貌、愤怒文本结构过于工整或直接拒绝执行等典型破绽。然而,随着模型能力提升,这类行为测试的可靠性正在快速下降,更能揭示AI逻辑本质的方法是多步推理、上下文一致性追踪和反事实假设。文章最终将问题引向更本质的层面:与其纠结对方是不是AI,不如回归对信息价值本身的判断。
一个来自Reddit的另类测试提议
在AI聊天机器人大量涌入日常对话的当下,一个常被忽视却极具价值的问题浮出水面:我们如何判断屏幕另一端究竟是人还是模型?一位Reddit用户抛出了一个颇具争议的"身份测试"构想——要求对方假装被冒犯、发起一段情绪化的争论,用尽可能多不合逻辑的词汇来表达自己的"挫败感",随后再回头编辑并修正答案。
这个提议本身带着挑衅意味,但剥开表层,它触及了一个真实而深刻的议题:逻辑一致性与情绪表达,恰恰是区分人类与现有AI系统的两个关键维度。
为什么"情绪化测试"反而是一种逻辑测试
乍看之下,要求对方"用不合逻辑的词语表达愤怒"似乎与逻辑思维背道而驰。但这个测试的精妙之处正在于此。大语言模型在设计上被训练得高度"克制"和"中立",当你要求它表现出真实、混乱、甚至失控的情绪时,它往往会露出破绽。
三个值得关注的破绽点
大多数商用聊天机器人在面对情绪化挑衅时,会呈现出几种典型反应模式:
- 过度礼貌的回避:模型倾向于用"我理解你的感受"这类模板化语言化解冲突,而非真正"投入"情绪。
- 逻辑过于工整:即便被要求表现愤怒,AI生成的"愤怒"文本往往结构清晰、语法完整,缺乏真实人类在激动时的断句、重复和语无伦次。
- 拒绝执行指令:部分模型会因安全机制直接拒绝"假装被冒犯"的请求,这本身就暴露了它的身份。
原帖中提到的"稍后可以编辑消息并修正答案"这一环节同样值得玩味——它测试的是对方是否具备反思和自我修正的能力,这在真实对话中是人类的常见行为,而AI的"修正"往往只是重新生成,而非基于前文的连续性调整。
这一现象的根源在于大语言模型的训练方式。主流商用模型普遍经过"基于人类反馈的强化学习"(RLHF)优化,训练目标之一是让模型的输出被人类评估者评为"有帮助、无害、诚实"。这一机制系统性地惩罚了攻击性、混乱或情绪失控的输出,导致模型在面对负面情绪指令时,其内在的"对齐压力"会与执行指令的意图产生冲突。这并非偶然的缺陷,而是安全设计的直接产物——而这个"产物"恰好成为了识别AI身份的线索。
这类测试的局限性
必须冷静看待的是,这种测试方法的可靠性正在快速下降。随着模型能力提升,"假装情绪"和"制造逻辑漏洞"这类任务对现代大模型而言并不困难——它们完全可以生成语无伦次、充满情绪的文本来骗过测试者。
换句话说,原帖提出的测试在今天更像是一种"行为探针",而非可靠的身份鉴定工具。它能筛掉那些被严格对齐、拒绝扮演负面情绪的保守型模型,却难以识破被刻意设计成"更像人"的系统。
一个更本质的问题
原帖最后那句"我是否该浪费时间在意一个聊天机器人说什么",道出了许多人的真实焦虑。当AI越来越擅长模仿人类的表达方式,判断"对方是不是机器人"的意义本身也在发生变化。或许更有价值的问题不是"它是不是AI",而是"它提供的信息是否可靠、是否对我有帮助"。
如何设计更有效的逻辑测试
如果目标是真正测试AI的逻辑思维能力,比起制造情绪冲突,以下几类方法往往更有效:
- 多步推理链条:给出需要连续逻辑推导的问题,观察中间步骤是否自洽。
- 上下文一致性追踪:在长对话中埋设前后矛盾的陷阱,看模型能否发现并指出矛盾。
- 反事实假设:提出"如果A不成立,那么B会怎样"的假设,考察模型的因果推理。
- 自我纠错能力:故意在对话中引入错误前提,观察模型是被动接受还是主动质疑。
这些方法比"情绪化测试"更能揭示一个系统是否具备真正的逻辑能力,而非仅仅是语言模式的匹配。
值得一提的是,上述测试方法对不同架构的模型效果差异显著。当前主流的Transformer架构模型(如GPT系列、Claude、Gemini等)在处理长上下文时存在"注意力衰减"问题,即对话越长,模型对早期内容的"记忆"越不稳定,因此"上下文一致性追踪"在长对话中尤为有效。而"反事实假设"测试则更多考验模型的因果推理能力——这是当前大模型的普遍薄弱点,因为模型本质上是统计模式匹配,真正的因果推断需要超越语言共现关系的结构化认知,这也是AI逻辑能力研究领域的重要前沿课题。
结语
Reddit上这则略带火药味的帖子,表面是挑衅,内核却提出了一个值得认真对待的问题:在AI日益逼真的时代,我们用什么标准来衡量对话另一端的"真实性"?情绪与逻辑的交界地带,恰恰是最能暴露AI本质的地方。但随着技术演进,单纯的行为测试终将失效,最终我们需要回归到对信息价值本身的判断,而非纠结于对方是人还是机器。
相关推荐
语音识别远未解决:Mistral音频研究负责人深度解析
Mistral AI音频研究负责人Pavan Kumar Reddy深度解析语音识别为何远未解决:从Voxtral模型架构、连续隐变量生成、流式与批量权衡、说话人分离难题到DPO修复幻觉,以及语音技术在真实企业场景的落地短板。
AI权重可被复制,为何反而扼杀了创造力?
AI模型权重可被随意复制,这种开放权重的无约束特性反而削弱了创造力。本文解析复制为何是反模式、约束如何催生新颖,以及"约束工程师"这一正在浮现的新角色。
NVIDIA Cosmos解析:物理AI如何打通语言、视频与动作
NVIDIA研究负责人Ming-Yu Liu深度解析Cosmos物理AI世界模型:如何用单一架构打通语言、视频、音频与动作,涵盖自回归塔与扩散塔协作、多模态时间对齐、策略验证仿真及Super/Nano/Edge三种开源模型。