RubricAtlas:从专家报告中挖掘类型级评分标准来评估深度研究智能体

RubricAtlas 从专家报告中挖掘类型级分析要求,用以评估深度研究智能体的分析完整性。
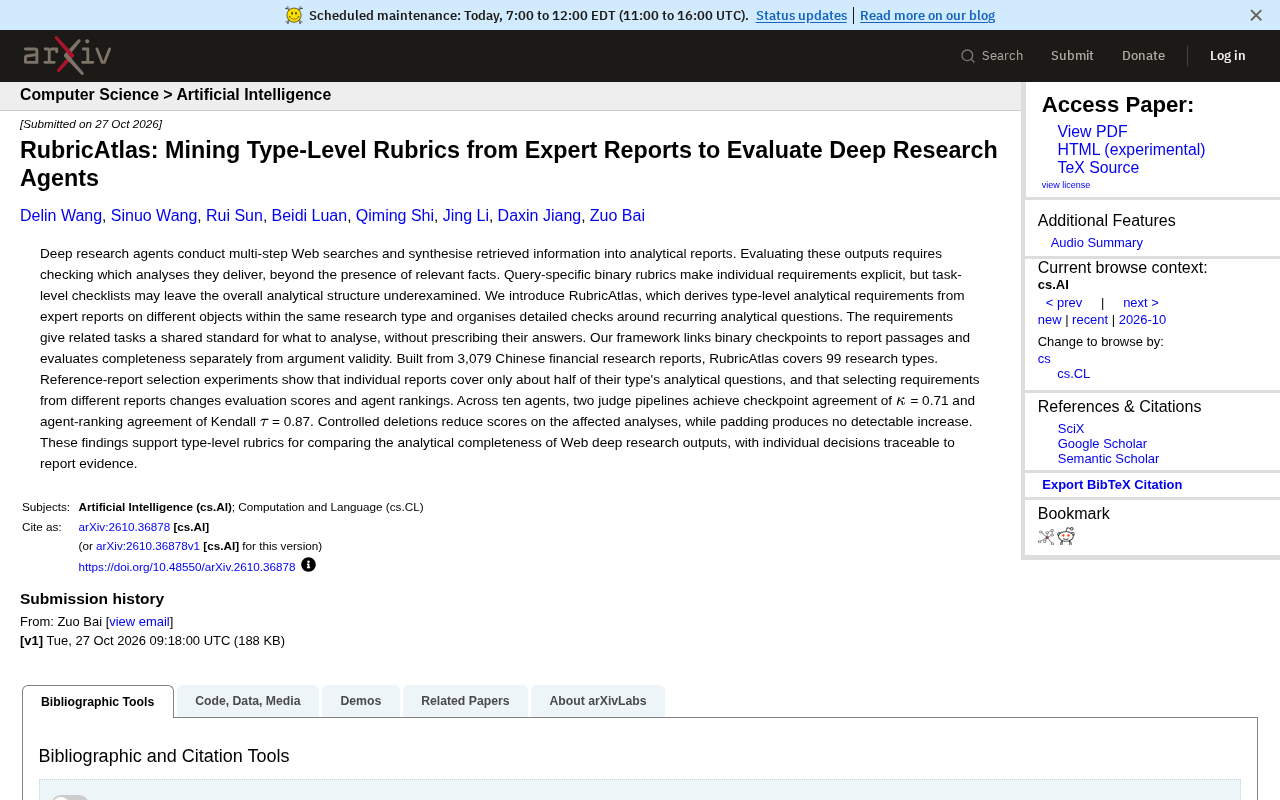
文章介绍了评估深度研究智能体的框架 RubricAtlas。针对任务级二元检查清单容易遗漏整体分析结构的问题,该框架从同一研究类型下多份专家报告中提炼共性的类型级分析要求,并将检查点与报告证据段落链接,分别评估完整性与论证有效性。框架基于 3,079 份中文金融研究报告构建,覆盖 99 种研究类型;单份参考报告平均仅覆盖所属类型约一半的分析问题。在十个智能体上,两条评审流程达到 κ = 0.71 的检查点一致性与 Kendall τ = 0.87 的排名一致性。受控删除实验使对应维度分数下降,填充无关内容未带来可检测的分数提升,表明框架衡量的是分析完整性而非文本长度。文章也指出参考报告选择会改变分数与排名,且框架在其他领域和语言的适用性尚待验证。
深度研究智能体(Deep research agents)通过多步骤的网络检索,将信息综合成分析报告。评估这类输出时,仅仅检查相关事实是否存在远远不够,还需要判断它们究竟交付了哪些分析。为此,研究者提出 RubricAtlas,一个从专家报告中自动挖掘「类型级」分析要求,并围绕反复出现的分析问题组织检查的评估框架。
为什么任务级检查清单不够用
针对单个查询的二元评分标准(binary rubrics)能把每项要求写得明确,但任务级的检查清单往往让整体的分析结构处于「欠考察」状态——清单可能覆盖了事实点,却漏掉了这类研究本应回答的核心分析问题。
RubricAtlas 的思路是:与其为每个任务单独写标准,不如从同一研究类型下、不同对象的专家报告中提炼出共性的分析要求。这些要求为同类任务提供了「该分析什么」的统一尺度,但不规定具体答案,从而避免把评分变成对某份参考报告的机械比对。
类型级评分标准如何构建
该框架的构建规模在其论文中有明确交代:基于 3,079 份中文金融研究报告,覆盖 99 种研究类型。
具体机制上,RubricAtlas 把二元检查点与报告中的具体段落链接起来,并将「完整性」与「论证有效性」分开评估。这一点很关键:一份报告可能分析点齐全但论证站不住脚,也可能论证严谨却漏掉了关键分析维度,两者不应混为同一个分数。
据论文描述,参考报告选择实验显示,单份报告平均只覆盖其所属类型约一半的分析问题。这意味着如果评估标准只从一份参考报告提取,就会系统性地遗漏另一半要求。
「类型级」与「任务级」的区别值得展开。任务级评分标准针对某个具体查询单独撰写,比如「分析某公司 2023 年毛利率变化的原因」,其检查点绑定这一家公司、这一年。类型级评分标准则从同一研究类型(如「上市公司盈利能力归因分析」)下多份针对不同对象的专家报告中归纳,提炼出诸如「是否拆解了毛利率变动的量价因素」「是否区分了行业性因素与公司特有因素」这类与具体对象无关的分析要求。
这样做的直接后果是标准具备可迁移性:同一套检查点可以用于评估该类型下任意对象的报告,而不必为每个新查询重新编写评分表。同时,由于要求来自多份报告的共性,它天然规避了「只对齐一份参考答案」的偏差。代价是标准更抽象,需要与报告中的具体证据段落建立链接,才能落地为可判定的二元检查点——这正是 RubricAtlas 把检查点与段落链接起来的原因。
评估可靠性:两个评审流程的交叉验证
在十个智能体上的测试中,两条评审流程(judge pipelines)取得了 κ = 0.71 的检查点一致性和 Kendall τ = 0.87 的智能体排名一致性。这两个指标分别对应「单个检查点判得准不准」和「整体排名稳不稳」,说明该框架在细粒度判断和宏观排序上都具备可用的一致性。
另一组值得关注的发现是:从不同报告中选择要求会改变评估分数和智能体排名。这提示评分标准的来源选择本身就是一个需要被认真对待的变量,而非无关紧要的实现细节。
Cohen's κ(科恩卡帕系数) 是衡量两名评审者(或两条评审流程)在分类判断上一致性程度的统计量。它的计算扣除了「随机一致」的部分:若两人完全随机地给检查点打「是/否」,也会有一定比例偶然吻合,κ 将这部分从观测一致率中剔除。取值通常在 −1 到 1 之间,0 表示与随机无异,一般认为 0.6–0.8 属于「高度一致」。因此 κ = 0.71 意味着两条流程在单个检查点是否被满足的判断上,一致性明显高于偶然水平。
Kendall τ(肯德尔秩相关系数) 则用于比较两组排序的一致性,取值从 −1(完全相反)到 1(完全一致)。在本例中,它衡量的是两条评审流程对十个智能体给出的名次是否吻合。τ = 0.87 说明即使个别检查点判断有出入,两条流程对「谁好谁差」的宏观排序依然高度稳定。两者互补:κ 反映细粒度判断的可靠性,τ 反映整体评估结论的稳健性。
对照实验:删减与填充的不同效果
论文用受控实验检验了评分标准是否真正有区分力。
- 受控删除(controlled deletions):删去报告中的相关分析后,对应维度的分数下降,说明检查点确实捕捉到了目标内容。
- 填充(padding):向报告加入无关内容后,未检测到分数上升,说明框架不易被「凑字数」式的注水内容欺骗。
这两个方向的实验结果共同支持一个结论:该评分标准衡量的是分析完整性,而非文本长度或表面丰富度。
对深度研究评估的意义
RubricAtlas 的核心贡献在于把评估的锚点从「单份参考报告」上移到「研究类型」。这样做的好处是,同类任务之间可以横向比较分析完整度,同时每个具体判断仍然可以追溯到报告中的证据段落。
对于构建或使用深度研究智能体的团队来说,这提供了一种思路:与其追求与某份「标准答案」的相似度,不如明确这类研究应当回答哪些分析问题,再分别考察覆盖情况和论证质量。
需要说明的是,该框架的构建语料集中于中文金融研究报告,其在其他领域和语言上的适用性尚未在原始素材中给出结论。
相关推荐
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。