Ruby-OPD:流匹配TTS的发音可控性突破
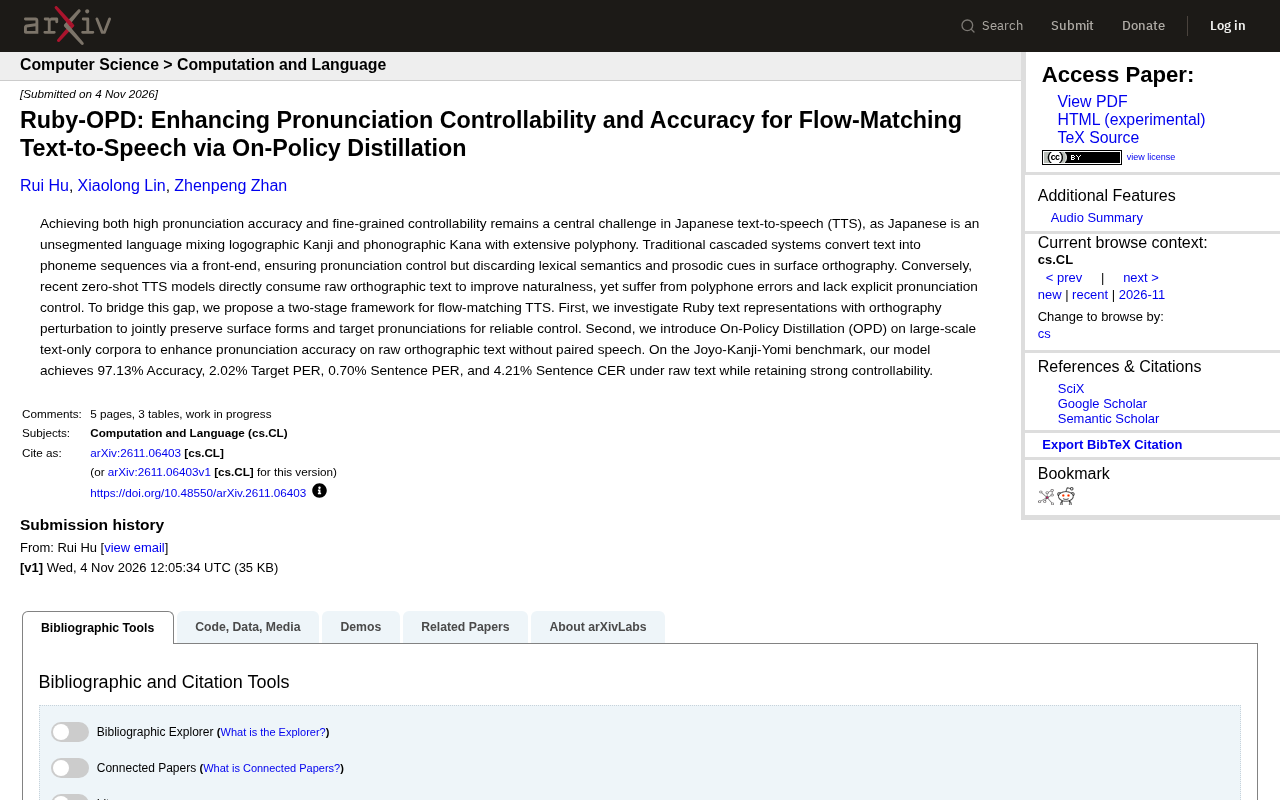
Ruby-OPD用Ruby表示加On-Policy蒸馏,兼顾日语TTS发音精度与可控性。
Ruby-OPD 针对日语 TTS 中“前端音素化保证发音可控但丢失语义韵律线索”与“零样本模型直接吃原始文本提升自然度却多音字误读”的两难,提出两阶段框架。第一阶段以 Ruby 文本表示结合正字法扰动,让模型在保留表层书写形式的同时获得发音锚点;第二阶段在大规模无配对语音的纯文本语料上做 On-Policy 蒸馏,使模型在自身策略输出上自我修正多音字错误。在 Joyo-Kanji-Yomi 基准上,原始文本输入下准确率达 97.13%,目标音素错误率 2.02%,句子级音素错误率 0.70%,句子级字符错误率 4.21%,同时保留较强可控性。该方法对中文多音字等正字法与发音不一致的语言具有借鉴意义。
日语TTS长期面临一个两难:要么通过前端将文本转为音素序列以确保发音可控,但丢失语义和韵律线索;要么让零样本模型直接吃原始文本以提升自然度,却牺牲了多音字准确性和显式控制。Ruby-OPD提出两阶段框架,试图在流匹配TTS架构上同时解决这两个问题。
日语TTS的结构性难题
日语是未分词语言,汉字(表意)与假名(表音)混写,且汉字存在大量多音现象。传统级联系统依赖前端把文本转成音素序列,发音控制因此变得确定,但代价是表层正字法中的词汇语义和韵律线索被丢弃。近年流行的零样本TTS模型直接消费原始正字法文本,自然度显著提升,却频繁出现多音字误读,并且缺乏显式的发音控制接口。
Ruby-OPD的作者将这一矛盾归纳为“发音精度”与“细粒度可控性”的取舍,并提出用两阶段设计来桥接。
第一阶段:Ruby文本表示与正字法扰动
Ruby文本原本是日语中在汉字上方标注读音的排版惯例。Ruby-OPD将其作为表示层的手段:通过正字法扰动(orthography perturbation),模型在训练中同时接触表层书写形式和目标发音,从而保留正字法信息的同时获得可靠的发音控制信号。
这一设计的巧妙之处在于,它没有像传统前端那样把文本彻底音素化,而是让模型学会在保留原始文本语义线索的前提下,将Ruby标注作为可控的发音锚点。
什么是正字法扰动
正字法扰动(orthography perturbation)指在训练时对输入文本的表层书写形式施加受控变化,例如随机移除、替换或插入 Ruby 注音标注,使模型同时见到“纯汉字”“汉字+读音”“纯假名”等多种表示。这样做的目的是防止模型过度依赖某一种输入格式:推理时即便用户只提供原始文本、没有 Ruby 标注,模型也能凭借训练中习得的对齐关系推断发音。扰动策略的设计需要在覆盖率与噪声之间权衡——扰动过强会让发音信号变得不可靠,过弱则无法泛化到无标注场景。
第二阶段:基于大规模纯文本语料的On-Policy蒸馏
仅有Ruby标注数据不足以覆盖真实场景中无标注的原始文本。Ruby-OPD引入On-Policy Distillation(OPD),在无需配对语音的大规模纯文本语料上继续优化发音准确率。
所谓On-Policy,意味着蒸馏过程使用模型自身在当前策略下产生的输出进行学习,而非依赖固定教师强制轨迹。这使得模型能够在原始正字法文本上自我修正多音字错误,同时不需要成对的语音数据——这对低资源场景下的日语TTS尤为关键。
On-Policy 与 Off-Policy 蒸馏的区别
在知识蒸馏中,学生模型的学习数据来源决定了策略类型。Off-Policy 蒸馏使用固定的教师模型输出或标注数据作为监督信号,学生只能被动模仿,训练分布与推理时的真实输入分布容易产生偏移。On-Policy 蒸馏则让学生模型先针对当前输入生成自己的输出序列,再借助发音判别器或奖励信号对这些“自身策略下产生”的样本进行纠正。由于训练样本来自模型当前分布,多音字错误的修正能直接作用于推理时会遇到的文本形态,收敛更稳定。代价是训练过程需要在线采样,计算开销高于离线蒸馏,且对奖励信号的可靠性提出更高要求。
基准测试结果
在Joyo-Kanji-Yomi基准上,Ruby-OPD在原始文本输入下取得:
- 准确率97.13%
- 目标音素错误率(Target PER)2.02%
- 句子级音素错误率(Sentence PER)0.70%
- 句子级字符错误率(Sentence CER)4.21%
同时模型保留了较强的可控性。这组数据表明,两阶段框架在发音精度上已经接近甚至达到前端音素化系统的水平,而无需放弃原始文本输入带来的自然度优势。
Joyo-Kanji-Yomi 基准与 PER/CER 指标
Joyo-Kanji-Yomi 基准聚焦常用汉字(Joyo Kanji)的读音准确性,是评估日语 TTS 多音字处理能力的代表性测试集。文中出现的 PER(Phoneme Error Rate,音素错误率)以音素为单位计算替换、删除、插入错误的比例;Target PER 只统计目标多音字所在位置的音素错误,Sentence PER 和 Sentence CER 则分别在整句层面衡量音素与字符的错误率。目标音素错误率低说明模型对关键多音字的判断准确,句子级指标低则反映整体发音序列的稳定性,两者结合才能全面评价发音精度。
对TTS工程实践的启示
Ruby-OPD的价值不只限于日语。任何存在正字法与发音映射不一致的语言——例如中文多音字、英语同形异读词——都可能从“Ruby式标注+On-Policy蒸馏”的组合中受益。流匹配TTS架构本身以生成质量见长,补上发音可控性这块短板后,其在需要精确发音控制的场景(如播报、教育、无障碍朗读)中的适用性会明显提升。
当然,Ruby标注的获取成本、扰动策略的设计细节,以及OPD在更大规模语料上的稳定性,仍是后续需要观察的工程问题。但从方法论上看,把发音控制从“前端硬约束”转变为“表示层软引导+策略内蒸馏”,是一条值得跟进的路线。
相关推荐
七年蜕变:初代折叠屏与现在差距有多大
从初代折叠屏到最新产品,七年时间带来了哪些改变?折痕变浅、亮度提升、机身更薄、软件迁移更顺畅,折叠屏是否已经跨越从发烧友到普通用户的鸿沟?本文基于视频对比分析展开讨论。
人类何时开始吃盐?一段跨越万年的盐史
人类何时开始吃盐?从11000年前农业兴起时的加盐实践,到古代海水蒸发、岩盐开采,再到盐贸易、盐税与甘地食盐长征,本文梳理盐在人类文明中的关键角色。
微软Paza研究:非洲语言语音识别如何突破架构与数据瓶颈
微软Paza研究系统评估53个语音模型在39种非洲语言上的表现,揭示架构选择比预训练覆盖更关键、200-300小时为实用数据门槛,以及语言类型学对识别性能的深层影响。