Sada-ASR:面向阿拉伯语多方言的生产级语音识别系统
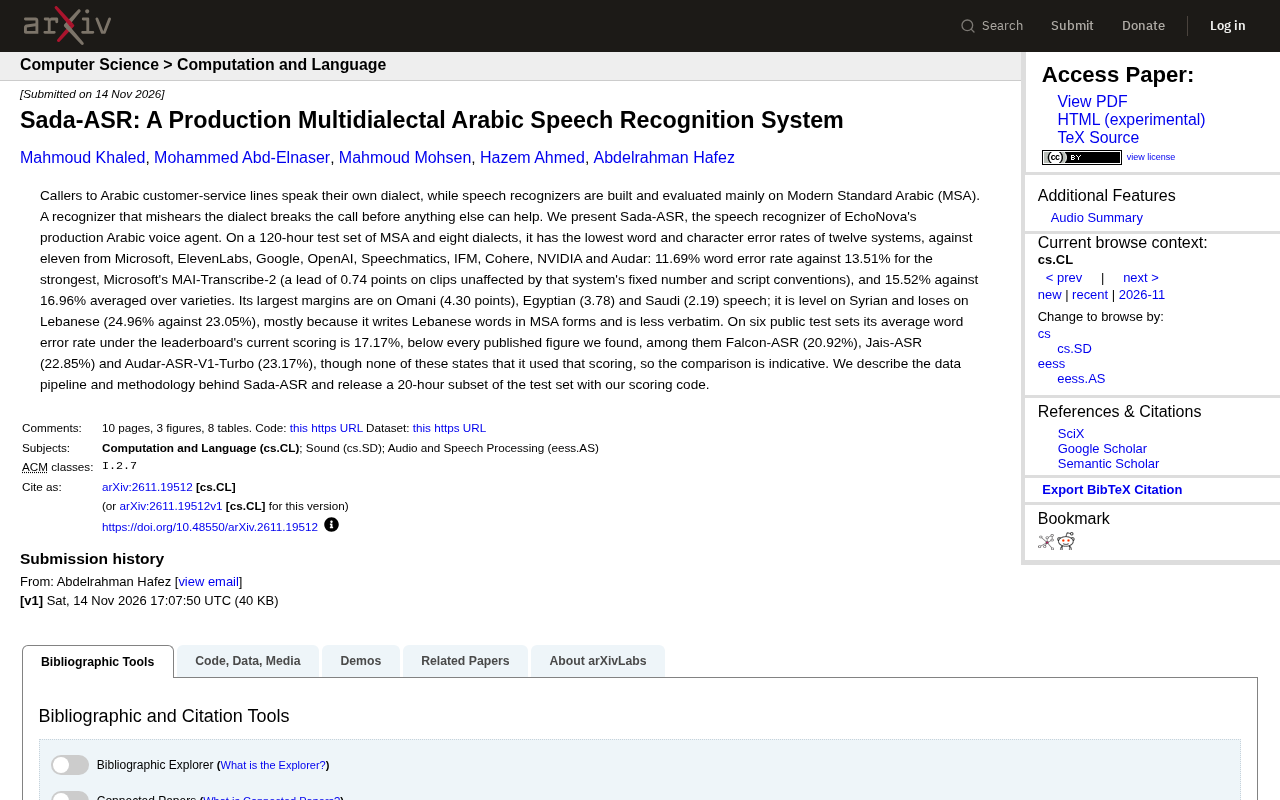
Sada-ASR 以多方言数据训练,在十二套系统中词错误率最低,并开源测试集推动评测标准化。
EchoNova 的生产级阿拉伯语语音助手 Sada-ASR 针对方言识别难题设计。团队构建了 120 小时覆盖 MSA 和八种方言的测试集,与 Microsoft、Google、OpenAI 等十一个系统对比,Sada-ASR 整体词错误率 11.69% 为最低,在阿曼、埃及、沙特方言上优势明显,但黎巴嫩方言因转写为 MSA 形式而落后。在六个公共测试集上平均 WER 17.17%,低于已发布的 Falcon-ASR 等系统,但团队坦承评分标准不一致使对比仅为指示性。Sada-ASR 开源了 20 小时测试子集和评分代码,其案例揭示了方言覆盖、逐字转写与语义理解权衡、评测透明度三个行业趋势。
阿拉伯语客服热线的来电者用各自的方言说话,而语音识别系统却主要基于现代标准阿拉伯语(MSA)构建和评估。一个听错方言的识别器会在其他环节发挥作用之前就让通话中断。EchoNova 的生产级阿拉伯语语音助手 Sada-ASR 正是针对这一痛点设计的。
方言鸿沟:为什么标准阿拉伯语识别器在真实场景中失效
在阿拉伯语世界,日常口语与书面标准语之间存在显著差异。现代标准阿拉伯语(MSA)是媒体、教育和官方文件的通用语,但人们在打电话、聊天或求助客服时,自然切换到埃及、沙特、阿曼、黎巴嫩等地方言。这些方言在词汇、语法、发音乃至书写习惯上都与 MSA 有系统性偏离。
现有的语音识别系统大多以 MSA 数据为主进行训练和评测,导致在真实客服场景中错误率飙升。Sada-ASR 的出发点很明确:如果识别器在方言上失准,后续的任何智能服务都无从谈起。
现代标准阿拉伯语(MSA) 是阿拉伯语世界通用的书面和正式口语形式,以《古兰经》语言为基础,在媒体、教育、政府文件和跨方言交流中使用。然而,它并非任何群体的母语,日常口语均以地方方言进行。阿拉伯语方言之间的差异显著,在音系、词汇和语法层面均有体现,例如埃及方言中将 /θ/ 发为 /t/ 或 /s/,海湾方言保留部分古音,马格里布方言则受柏柏尔语和法语影响。这种“双言现象”导致以 MSA 为主的语音识别系统在真实对话中性能大幅下降。
基准测试:十二套系统同台竞技
Sada-ASR 团队构建了一个 120 小时的测试集,覆盖 MSA 和八种方言。他们将其与来自 Microsoft、ElevenLabs、Google、OpenAI、Speechmatics、IFM、Cohere、NVIDIA 和 Audar 的十一个系统进行了对比,总计十二套系统。
结果如下:
- 整体词错误率(WER):Sada-ASR 为 11.69%,表现最强的 Microsoft MAI-Transcribe-2 为 13.51%。不过 Microsoft 系统在数字和书写约定上有固定处理,在不受此影响的片段上,Sada-ASR 的领先幅度为 0.74 个百分点。
- 各方言平均词错误率:Sada-ASR 为 15.52%,对比其他系统平均 16.96%。
- 优势最大的方言:阿曼方言领先 4.30 个百分点,埃及方言领先 3.78 个百分点,沙特方言领先 2.19 个百分点。
- 表现持平的方言:叙利亚方言。
- 表现落后的方言:黎巴嫩方言,Sada-ASR 为 24.96%,而竞品为 23.05%。团队解释称,这主要是因为 Sada-ASR 将黎巴嫩语词汇转写为 MSA 形式,逐字程度较低。
词错误率(WER) 是语音识别中最常用的评估指标,计算方式为识别结果与参考转写之间的替换、删除和插入错误总数除以参考词总数。WER 越低表示识别越准确。然而,WER 对文本规范化方式非常敏感:数字是写成阿拉伯数字还是拼写为文字、标点符号是否保留、方言词是否转写为标准语形式等,都会显著影响分母和错误计数。因此,不同系统若采用不同的文本规范化规则,其 WER 数值不能直接比较,这也是论文团队强调跨系统对比局限性的原因。
公共测试集上的表现与对比局限
在六个公共测试集上,按照当前排行榜的评分标准,Sada-ASR 的平均词错误率为 17.17%,低于团队找到的所有已发布数据,包括 Falcon-ASR(20.92%)、Jais-ASR(22.85%)和 Audar-ASR-V1-Turbo(23.17%)。
不过团队坦承,这些系统均未声明使用了相同的评分标准,因此这一对比仅具有指示性,不能视为严格受控的实验结论。这种对比较局限的主动披露,在语音识别论文中并不常见,反而增加了结果的可信度。
Falcon-ASR、Jais-ASR 和 Audar-ASR-V1-Turbo 是三个已公开的阿拉伯语语音识别系统。Falcon-ASR 由阿联酋技术创新研究所(TII)开发,Jais-ASR 源自 G42 与 MBZUAI 合作推出的 Jais 模型系列,Audar-ASR 则来自 Audar 公司。这些系统在各自的论文或技术报告中公布了在公共测试集上的 WER 指标,常被用作阿拉伯语 ASR 的基准参照。但正如 Sada-ASR 团队所指出的,它们并未统一评分标准,因此直接比较数字需谨慎。
数据管道与方法论:生产系统的幕后
Sada-ASR 的价值不仅在于基准数字,更在于它是一套实际部署在生产环境中的系统。论文描述了其背后的数据管道和方法论,但摘要中未展开具体技术细节。从已知信息可以推断,该系统的训练数据必然涵盖了多方言的语音-文本对,并且在文本规范化、方言标注和评分逻辑上做了针对性设计。
值得关注的是,团队选择开源 20 小时的测试集子集及评分代码。这一举措降低了后续研究的复现门槛,也为方言语音识别的标准化评测提供了公共基础。
生产级语音识别的现实启示
Sada-ASR 的案例揭示了几个更深层的行业趋势:
第一,方言覆盖正在成为语音识别的竞争焦点。 过去以 MSA 为中心的评测体系掩盖了真实场景中的性能落差。随着阿拉伯语市场数字化程度提升,客服、金融、电商等场景对 damages 方言识别的需求会持续增长。
第二,逐字转写与语义理解的权衡。 黎巴嫩方言上的落后暴露了一个设计选择:将方言词汇规范化为 MSA 形式,可能提升下游语义理解的便利性,但会牺牲逐字转写的准确率。生产系统需要根据实际任务目标做出取舍。
第三,评测透明度仍是行业短板。 Sada-ASR 团队明确指出跨系统对比的评分标准不一致问题,这提示语音识别领域亟需统一的评测协议,否则排行榜数字的说服力将始终受限。
对于构建多语言或多方言语音产品的团队而言,Sada-ASR 提供了一个可参考的范式:以真实场景数据驱动,以生产部署为检验标准,同时对比较边界保持诚实。
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
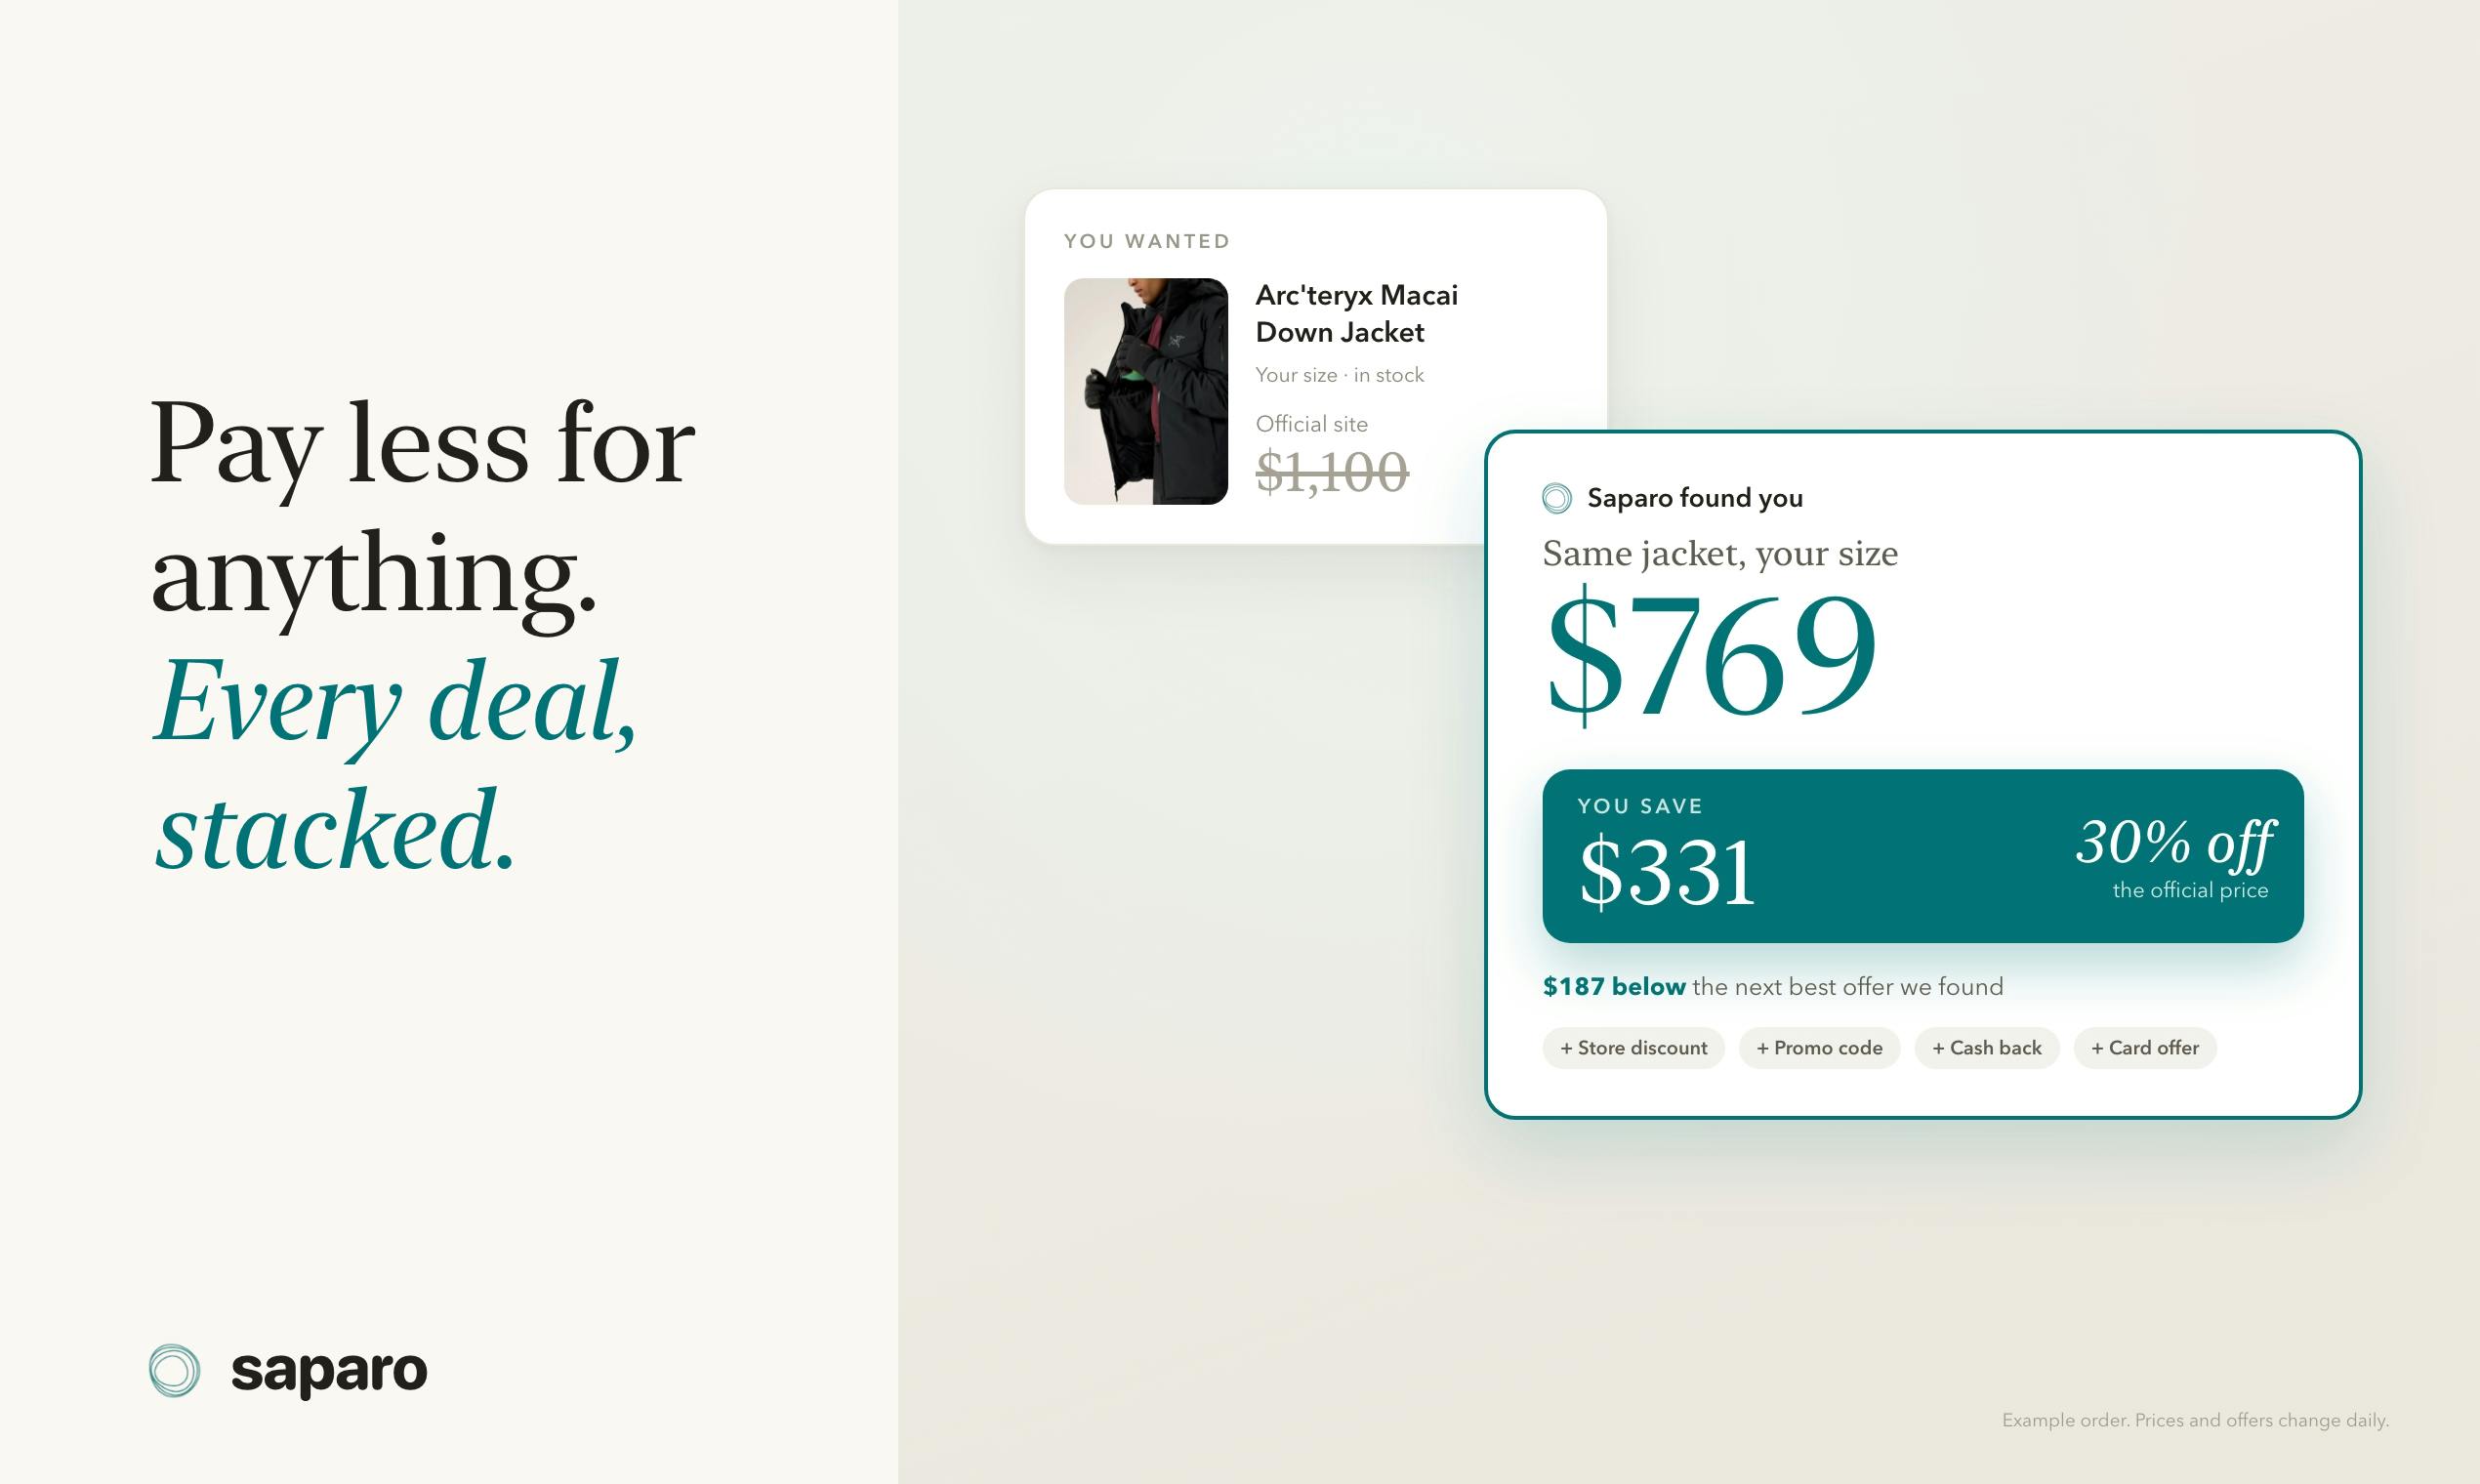
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
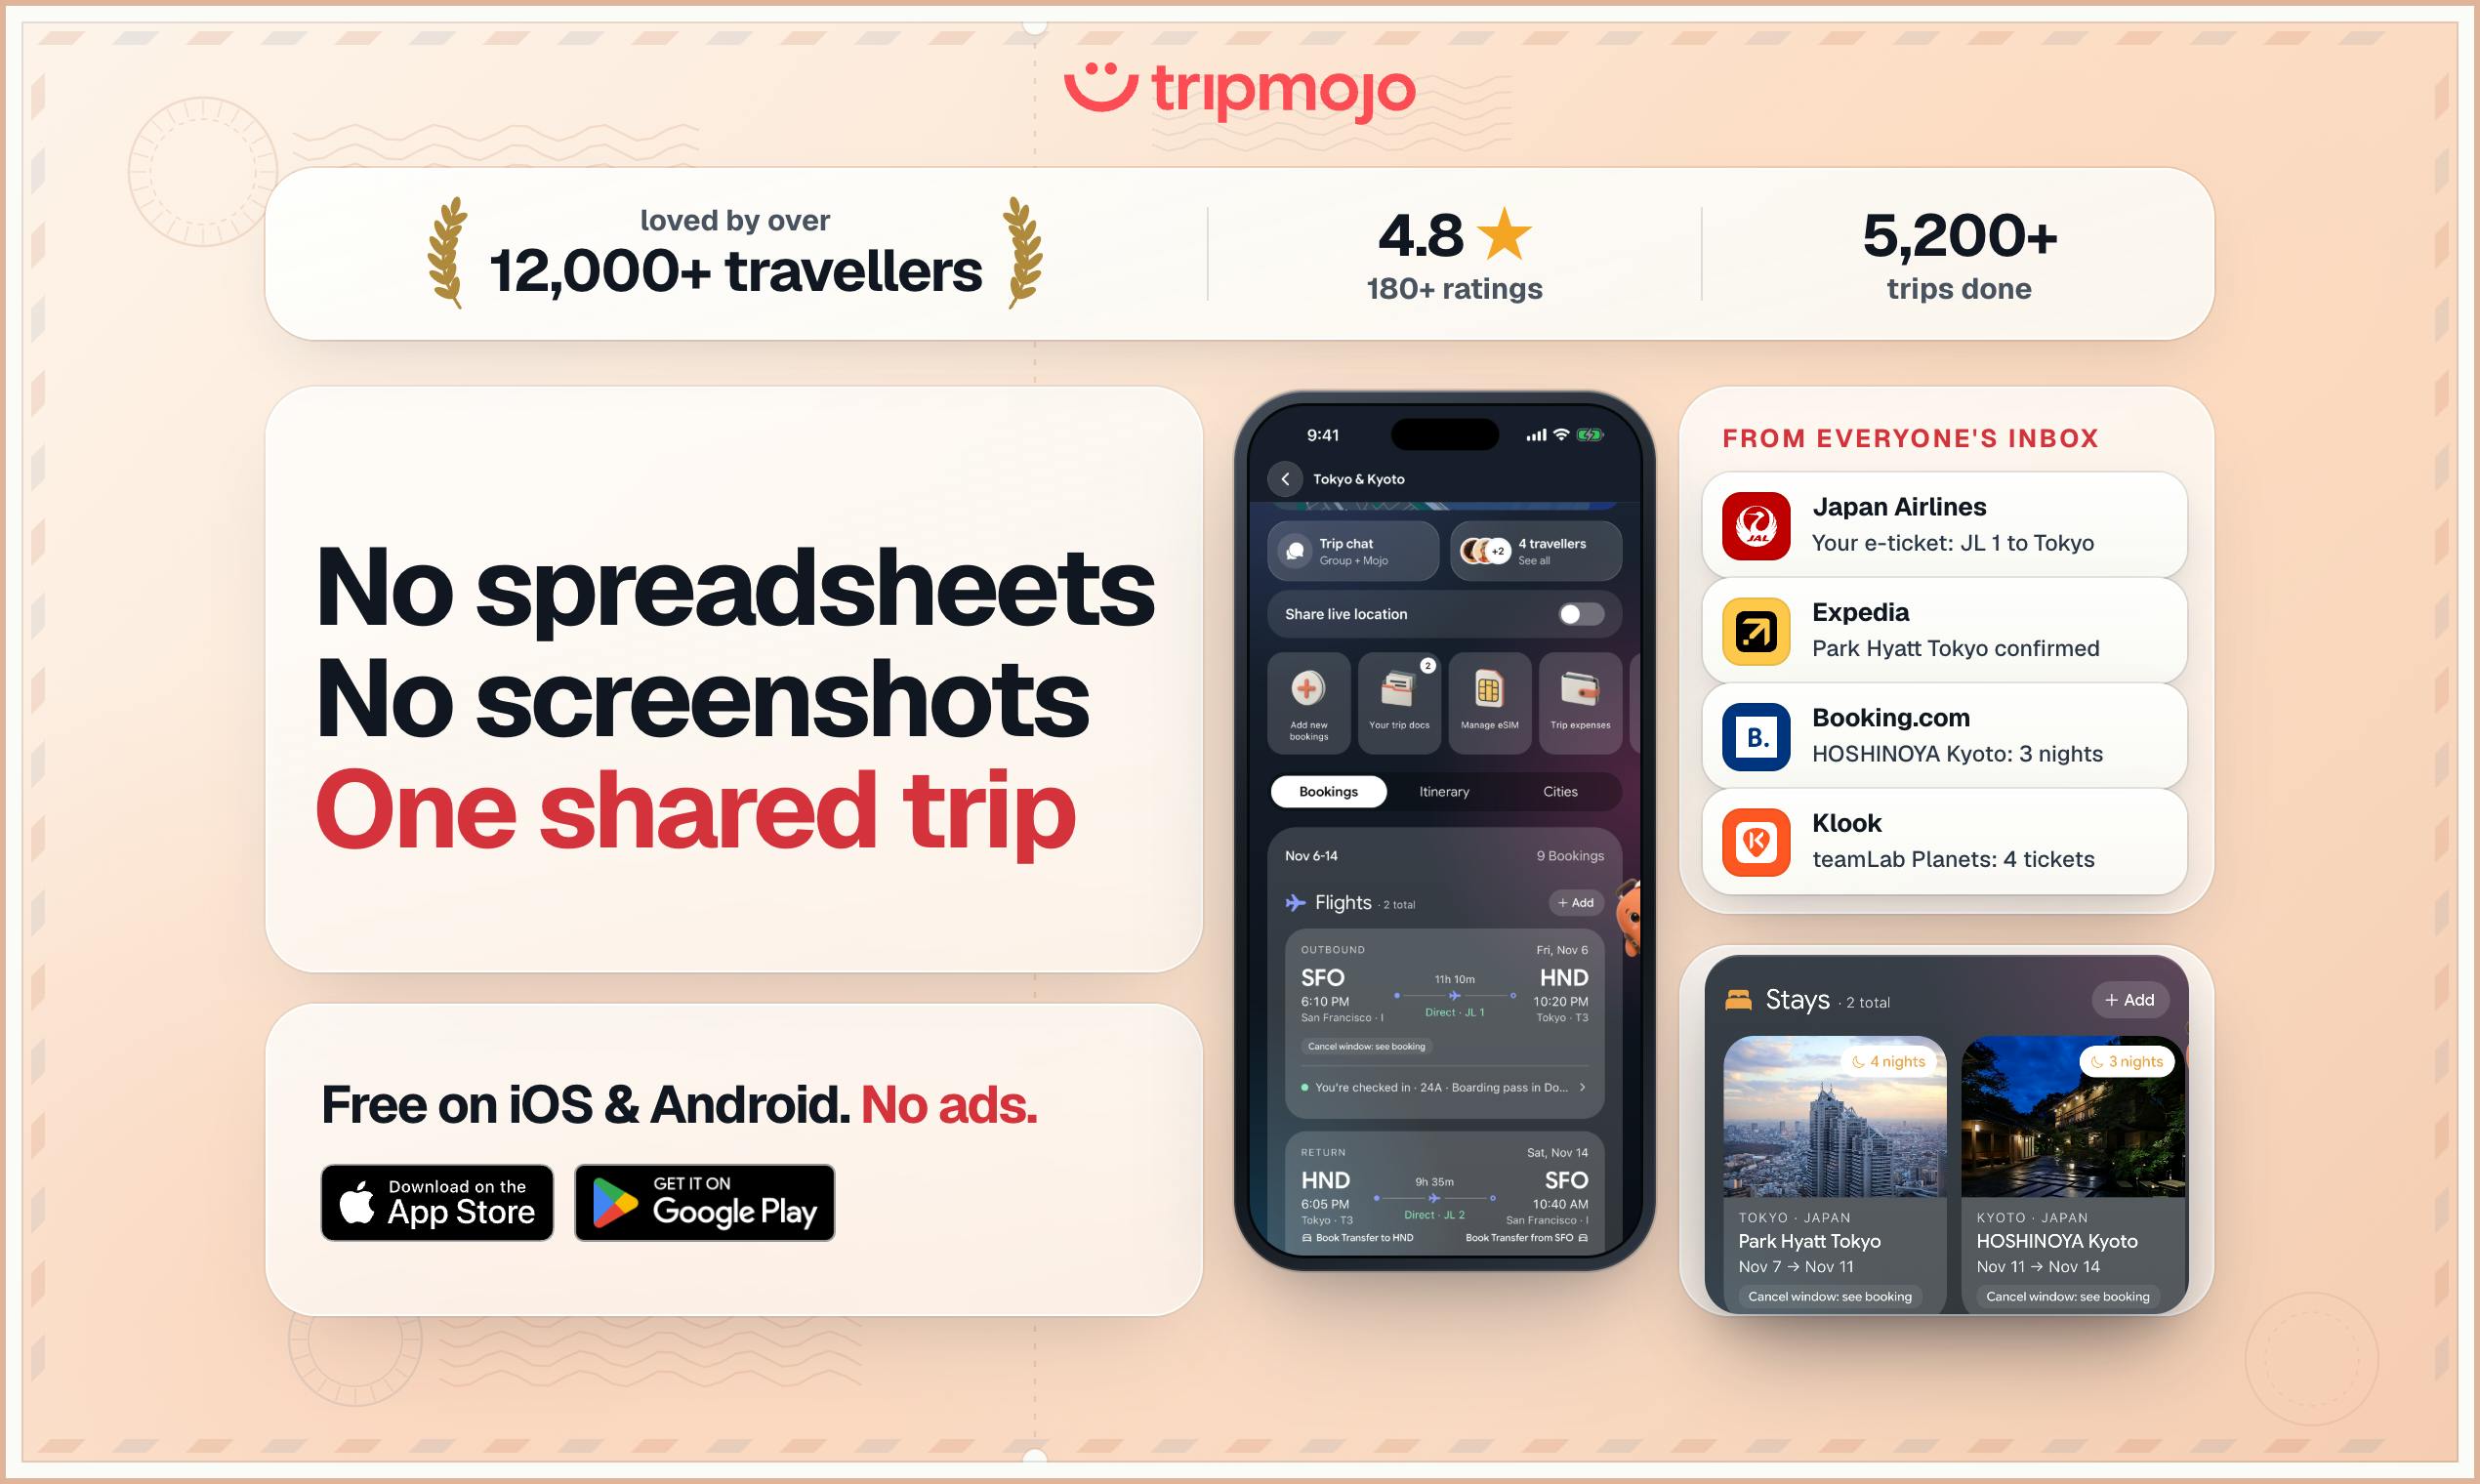
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。