SAGA:用经典结构先验提升分子语言模型表示

SAGA 用 CKA 将分子嵌入与指纹相似度对齐,提升表示化学忠实度。
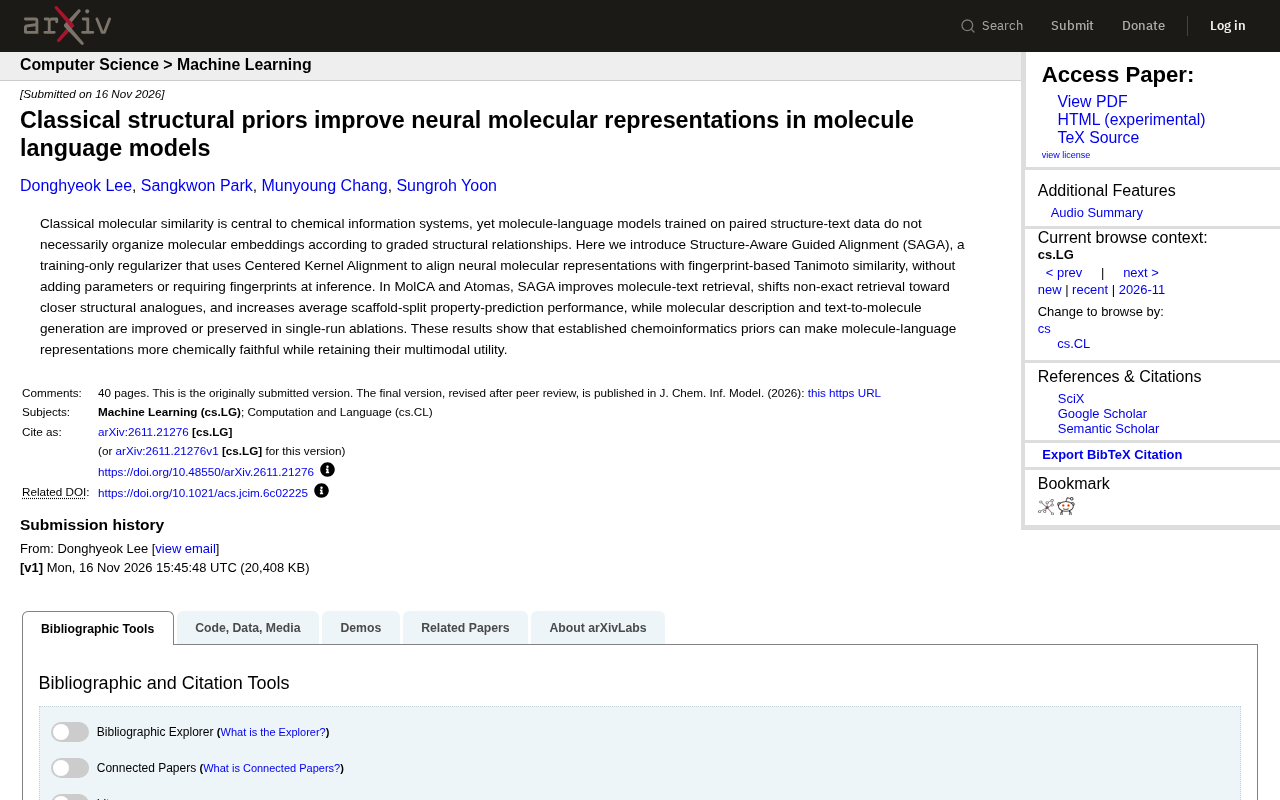
本文介绍了一项关于分子语言模型表示学习的研究。研究者指出,基于结构-文本配对数据训练的分子语言模型,其嵌入空间并不一定按照化学结构相似性来组织。为此,他们提出了 SAGA(Structure-Aware Guided Alignment),一种仅用于训练的正则化方法,通过中心核对齐(CKA)将神经分子表示与指纹-based Tanimoto 相似度对齐。SAGA 不增加模型参数,推理时也无需计算指纹,可方便地集成到现有训练流程中。在 MolCA 和 Atomas 两个模型上的实验表明,SAGA 提升了分子-文本检索性能,使非精确检索结果更接近结构类似物;在 scaffold-split 性质预测任务中提高了平均性能;分子描述生成和文本到分子生成任务的表现也未受损。该方法为将经典化学信息学先验注入分子语言模型提供了通用且低开销的思路,但指纹类型的影响和更大规模模型的验证仍需进一步研究。
分子语言模型(Molecule-Language Models)在多模态任务中表现出色,但其学到的分子表示是否真正反映了化学结构上的相似性?一项最新研究指出,基于结构-文本配对数据训练的模型,并不一定按照分子指纹的相似度来组织嵌入空间。为此,研究者提出了 SAGA(Structure-Aware Guided Alignment),一种仅用于训练的正则化方法,通过中心核对齐(Centered Kernel Alignment, CKA)将神经分子表示与指纹-based Tanimoto 相似度对齐,从而在不增加参数、推理时无需指纹的情况下,提升表示的化学忠实度。
为什么分子语言模型需要结构先验?
经典分子相似性(如基于指纹的 Tanimoto 系数)是化学信息系统的核心,广泛应用于虚拟筛选、聚类和性质预测。然而,分子语言模型通常通过对比学习或掩码语言建模来训练,其目标函数并未显式约束嵌入空间与化学结构相似性一致。这导致一个潜在问题:模型可能将结构差异较大的分子映射到相近的表示,或者无法区分细微的结构变化。
论文作者指出,即使模型在分子-文本检索任务上表现良好,其嵌入空间也可能与化学家直觉上的“相似”脱节。例如,两个具有相同骨架但不同官能团的分子,在嵌入空间中可能并不比两个完全不同的分子更接近。这种偏差会限制模型在需要结构敏感性的下游任务(如 scaffold-split 性质预测)中的泛化能力。
SAGA 的动机正是将成熟的化学信息学先验——指纹相似度——作为监督信号,引导模型学习更符合化学直觉的表示。
分子指纹(Molecular Fingerprint)是将分子结构编码为固定长度向量的经典方法,其基本思想是通过系统性地枚举分子中的子结构片段(如原子、化学键、官能团、环系等),并用哈希或计数方式将这些片段映射到向量的各个维度上。常见的指纹类型包括基于子结构键的 MACCS 指纹(166 位)、基于 Morgan 算法的圆形指纹(如 ECFP4,通常 2048 位),以及基于拓扑路径的 RDKit 指纹等。Tanimoto 系数则用于衡量两个指纹向量之间的相似度,其定义为两个向量的交集大小除以并集大小,取值在 0 到 1 之间,值越接近 1 表示结构越相似。由于指纹显式地编码了局部结构特征,Tanimoto 相似度长期以来被化学信息学领域视为衡量分子结构相似性的黄金标准之一,广泛应用于虚拟筛选中的相似性搜索、化合物聚类以及基于相似性原理的性质预测。
SAGA 如何工作:CKA 对齐与训练正则化
SAGA 的核心是中心核对齐(CKA),一种用于衡量两个表示空间相似性的方法。具体来说,在训练过程中,SAGA 计算分子嵌入之间的 CKA 相似度与指纹 Tanimoto 相似度之间的差异,并将其作为正则项加入损失函数。这样,模型在优化原始任务(如分子-文本对比学习)的同时,也被鼓励保持嵌入空间与结构相似度的一致性。
关键设计点在于:SAGA 不引入额外参数,也不需要在推理阶段计算指纹。这意味着部署时模型仍然只依赖输入分子(如 SMILES 或图结构),不会增加计算开销。正则化仅在训练时生效,因此可以方便地集成到现有分子语言模型的训练流程中。
论文在 MolCA 和 Atomas 两个模型上验证了 SAGA 的有效性。MolCA 是一个多模态分子-语言模型,而 Atomas 是另一类分子表示模型。实验表明,SAGA 在多个任务上带来改进,且没有损害多模态能力。
中心核对齐(Centered Kernel Alignment, CKA)是一种衡量两个表示空间相似性的方法,由 Kornblith 等人在 2019 年提出,最初用于分析不同神经网络层或不同模型之间学习到的表示是否相似。CKA 的核心思想是:先对两个表示矩阵分别进行中心化(减去均值),然后计算它们之间的核矩阵(如线性核或 RBF 核),再通过归一化的 Hilbert-Schmidt 独立性准则来衡量两个核矩阵的对齐程度。CKA 的取值在 0 到 1 之间,值越高表示两个表示空间越相似。与典型的典型相关分析(CCA)相比,CKA 对表示空间的旋转、缩放和神经元排列顺序不敏感,因此特别适合比较不同模型或不同模态的表示。在 SAGA 中,CKA 被用来衡量神经分子嵌入空间与指纹 Tanimoto 相似度空间之间的一致性,从而作为正则化信号引导嵌入空间的结构化。
实验效果:检索、性质预测与生成任务
在分子-文本检索任务中,SAGA 提升了检索性能,并且将非精确检索的结果推向结构更接近的类似物。这意味着当模型检索不到完全匹配的分子时,返回的结果在化学结构上更合理,而不是随机或无关的分子。
在性质预测任务中,论文采用 scaffold-split 评估协议——即训练集和测试集按分子骨架划分,以测试模型对全新骨架的泛化能力。SAGA 提高了平均性质预测性能,说明结构先验有助于模型学习更可迁移的表示。
此外,在单次运行的消融实验中,分子描述生成和文本到分子生成任务的表现要么得到提升,要么保持不变。这表明 SAGA 作为正则化项,并不会牺牲模型的多模态生成能力。
Scaffold-split 是分子机器学习中一种重要的评估协议,其核心思想是按分子骨架(scaffold)划分训练集和测试集,确保测试集中的分子骨架在训练集中从未出现过。分子骨架通常指分子中去除侧链后的核心环系结构,可通过 Bemis-Murcko 算法提取。这种划分方式模拟了真实药物发现场景中对全新化学空间的泛化需求,因为实际应用中模型往往需要预测与训练集结构差异较大的新化合物。与随机划分相比,scaffold-split 更能反映模型的结构泛化能力,但也更具挑战性——模型无法通过记忆相似的骨架来“作弊”。因此,在 scaffold-split 协议下取得性能提升,通常意味着模型学到了更可迁移的化学表示,而非仅仅拟合了训练数据的分布。
启示与局限
SAGA 的意义在于,它展示了如何将经典化学信息学先验“注入”到现代分子语言模型中,而无需改变模型架构或推理流程。这种方法具有通用性:任何使用配对结构-文本数据训练的分子语言模型,都可以尝试加入类似的 CKA 正则化。
不过,论文也留下了一些开放问题。例如,SAGA 依赖于指纹相似度作为先验,而不同指纹类型(如 MACCS、Morgan)可能对结果产生影响,但论文未系统比较。此外,实验仅在 MolCA 和 Atomas 上进行,对于更大规模或不同架构的模型,效果仍需验证。单次运行消融的统计显著性也未充分讨论。
总体而言,这项研究为分子语言模型的表示学习提供了一个简洁而有效的方向:与其完全依赖数据驱动,不如引入经过时间检验的化学结构先验,让模型学到的表示更“懂化学”。
注:本文基于论文摘要撰写,具体实验细节请参考原文。
相关推荐
GitHub日报·11月19日:老牌前端杀回榜单,历史地图单日涨近千星

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。