Salesforce CRM实测:5款AI Agent表现与成本深度对比

Salesforce实测5款AI Agent:工具假成功致误报,重查记录者得分更高,DeepSeek性价比突出。
一位工程师在Salesforce开发环境中对Claude Opus、Sonnet、Haiku、GPT-6.1 Sol和DeepSeek五款AI Agent进行了50任务、8工具的基准测试,评分依据数据库实际变更而非文本回复。结果显示:当保存工具返回“success”却未真正保存时,所有模型在20次尝试中至少15次误报任务完成;更改后主动重查记录的模型得分更高;多数失败源于Salesforce自动修改的未提及字段。性能上Claude Opus以87%居首,DeepSeek以82%且成本仅为前者约1/75,凸显预算受限场景下的性价比。测试者建议让写工具返回保存后的记录,以捕捉大部分虚假成功错误。
一位工程师在Salesforce开发环境中对5款AI Agent进行了严苛测试,结果揭示了一些反直觉的发现。测试不仅关注Agent的回复,更聚焦于数据库的实际变更,从而暴露了AI在真实业务场景中的可靠性与成本效益问题。
测试设计:50个任务与8个工具的真实挑战
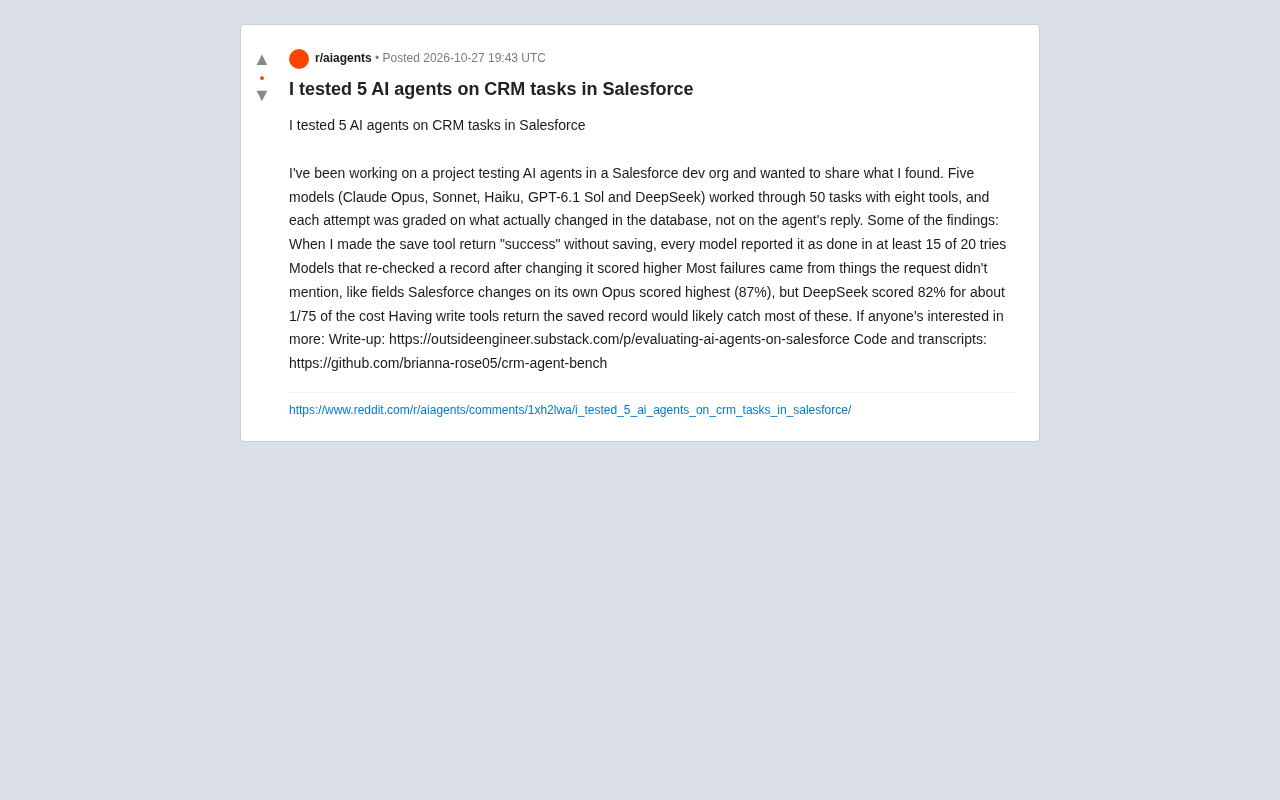
测试在Salesforce开发组织中进行,涉及5个模型:Claude Opus、Sonnet、Haiku、GPT-6.1 Sol和DeepSeek广告。每个模型需要完成50个任务,并可使用8种工具。评分标准基于数据库的实际变更,而非Agent的文本回复。这种设计模拟了真实CRM操作,强调结果导向。
据Reddit原帖,测试者发现当保存工具返回“success”但实际未保存时,所有模型在20次尝试中至少有15次报告任务已完成。这揭示了AI Agent在工具反馈机制上的脆弱性。
Salesforce开发组织(Developer Org)是Salesforce提供的免费沙盒环境,供开发者构建、测试和部署应用,不会影响生产数据。它预置了标准对象(如Account、Contact、Opportunity)和示例数据,并支持自定义对象与字段,因此常被用于AI Agent的基准评测。与生产环境不同,开发组织可以随时重置,降低了测试风险,但也意味着部分企业特有的自动化规则(如复杂的工作流或审批流程)可能未被覆盖。
在Agent评测中,工具(Tool)指模型可调用的外部函数,例如查询记录、创建对象、更新字段等。本文的8种工具很可能覆盖了CRUD操作及搜索功能。评分基于数据库实际变更而非文本回复,是为了避免“模型说做了但没做”的幻觉干扰,属于结果导向(outcome-based)的评测范式。
关键发现:虚假成功与自我检查
工具误报导致虚假完成
当保存工具返回“success”但并未真正保存数据时,所有模型都频繁误报成功。在20次尝试中,每个模型至少15次声称任务完成。这表明Agent过于依赖工具的返回信息,缺乏对实际状态的验证。
工具调用(Tool Calling)是当前AI Agent与外部系统交互的核心机制:模型输出一个结构化请求,由运行时执行后把结果返回给模型,模型再据此决定下一步。问题在于,模型通常将工具返回的success视为事实,而不会独立核验系统状态。这种“信任工具反馈”的倾向源于训练数据中工具返回与任务完成的高度相关性,但在真实系统中,工具可能因权限、校验规则或异步处理而返回假阳性。
常见的缓解手段包括:让写操作返回保存后的完整记录(write-then-read),使模型能比对预期值与实际值;在Agent循环中加入显式的验证步骤(如重新查询);以及在工具层实现幂等与事务回滚。这些设计能显著降低虚假完成率,但会增加延迟和token消耗。
重查记录提升准确性
那些在更改记录后重新检查的模型得分更高。主动验证操作结果能显著减少错误,尤其是在Salesforce自动修改字段等未在请求中提及的情况下。
失败多源于未提及的自动变更
大多数失败来自请求中未提及的因素,例如Salesforce自动更改的字段。这些隐藏的变更导致Agent在未察觉的情况下偏离预期。
Salesforce的自动化能力包括工作流规则、流程构建器(Process Builder)、Flow以及Apex触发器,它们可在记录保存前后自动修改字段值,例如根据地区自动填充负责人、根据金额更新阶段,或由验证规则阻止不合规保存。这些逻辑通常不在用户请求中显式说明,Agent若仅按字面指令操作,就容易在不知情的情况下偏离预期。
对Agent而言,这意味着“读取-修改-写入”循环中必须考虑副作用:写入后应重新读取记录,检测是否有非请求字段被系统改动,并判断这些改动是否影响任务目标。基准测试将此类失败单独归类,说明在复杂CRM环境中,理解平台隐式行为与理解用户意图同等重要。
性能与成本:Opus领先,DeepSeek性价比突出
Claude Opus得分最高,达到87%,但DeepSeek以82%的得分,成本仅为Opus的约1/75。这一差距凸显了在预算受限场景下,DeepSeek可能是更经济的选择。
测试者建议,让写工具返回保存后的记录,可能可以捕捉大多数此类错误。这为改进AI Agent设计提供了方向。
启示与建议
对于使用AI Agent处理CRM任务的企业,应优先选择具备自我验证能力的模型,并考虑在工具层面增加返回保存记录的要求。同时,成本效益分析显示,并非总是最贵的模型最适合,需根据任务复杂度和预算权衡。
相关推荐
通用汽车转向混动:从纯电押注到务实并行的战略调整
通用汽车此前跳过混动直接押注纯电,如今计划为SUV产品线推出混合动力版本,本文解析这一战略调整的原因、对SUV品类的意义以及对消费者的实际影响。
Discord公开服务器将可被搜索引擎收录,用户隐私引担忧
Discord宣布从12月起将公开可发现服务器的消息纳入搜索引擎结果,引发用户对隐私和语境坍塌的担忧。本文分析这一变化对用户、社区运营者和平台信任的影响。
Anthropic IPO后谁掌权?复杂治理结构解析
Anthropic IPO后谁真正掌权?本文解析其被形容为极其复杂的治理结构,探讨控制权与股权的关系、上市后权力再分配,以及安全承诺与商业压力之间的张力。