Sam Altman称本地推理浪费资源,开源社区为何不买账?
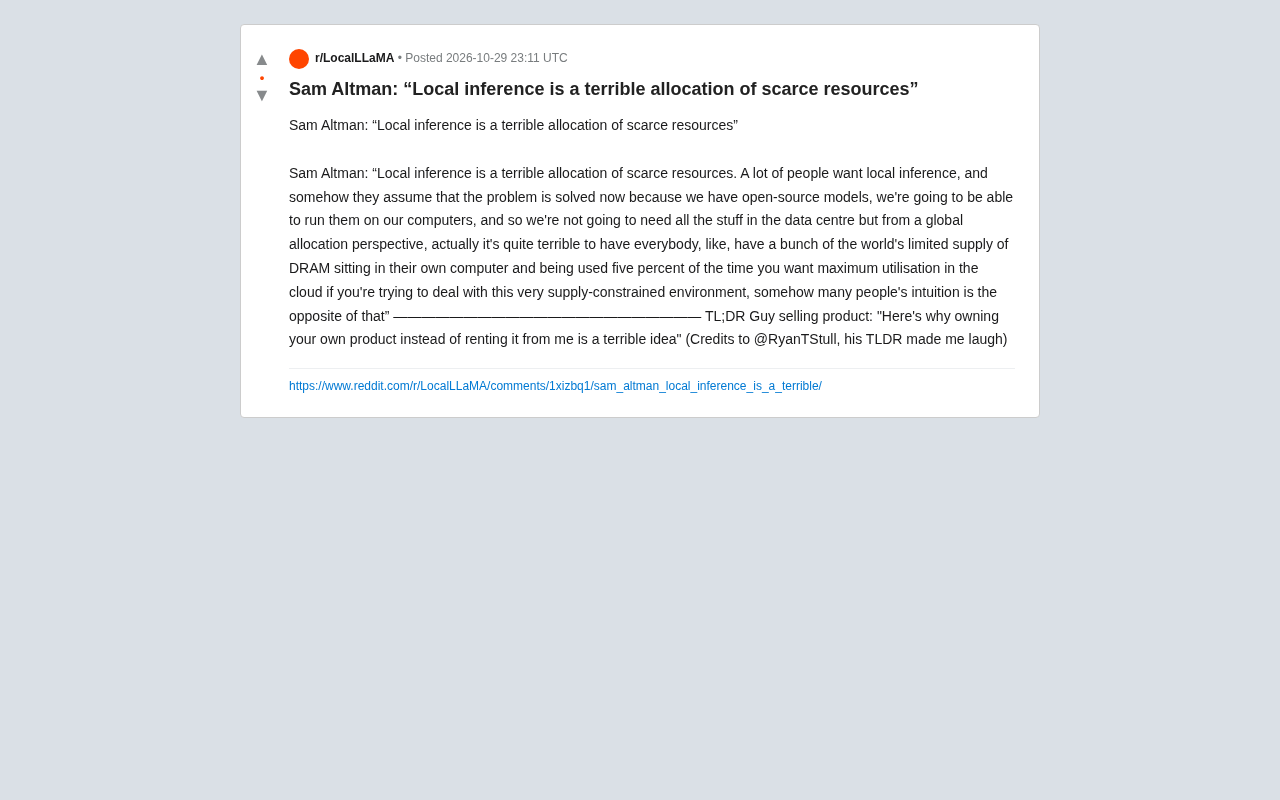
Altman称本地推理浪费稀缺资源,引发开发者关于云与本地的立场之争。
OpenAI CEO Sam Altman 称“本地推理是对稀缺资源的糟糕分配”,理由是个人硬件闲置率高,而云端集中调度能在 DRAM 等供应紧张时实现更高利用率。这一观点在 Reddit 等社区引发强烈反弹,开发者指出开源模型经量化、蒸馏、小型化后,本地推理在隐私、离线、低延迟场景已具备真实工程价值,且其隐性收益被“5% 利用率”的说法忽略。文章认为,争议的实质并非技术对错,而是说话人作为云侧受益者的利益立场问题。真正的启示是混合模式:本地与云端各有适用边界,开发者需要看清两套成本模型各自的边界,而非简单站队。
一句话引爆的争议
OpenAI CEO Sam Altman 最近的一番言论在开发者社区炸开了锅。他直言:“本地推理是对稀缺资源的糟糕分配。”在他看来,许多人因为开源模型的涌现就假定本地推理问题已经解决,认为可以在自己的电脑上运行模型、不再需要数据中心的基础设施——但从全球资源分配的角度看,让每个人把世界上有限的 DRAM 供应囤在自己电脑里、却只用到 5% 的时间,是相当糟糕的选择。在供应受限的环境下,云的 maximum utilisation 才是正解,而很多人的直觉恰好相反。
这段话迅速在 Reddit 等平台引发讨论,有网友毫不客气地总结:“卖产品的人说:为什么拥有自己的产品、而不是从我这里租,是个糟糕的主意。”
Altman 的逻辑:集中利用率的效率账
抛开立场,Altman 的论点有一个清晰的经济学内核:资源利用率。
当前 AI 算力的瓶颈不仅在 GPU,也在内存(DRAM)等核心组件。如果每个用户都在本地跑模型,意味着大量内存被分散持有、大部分时间闲置。相比之下,云端的集中调度可以让同一批硬件服务更多请求,摊薄单位成本。在供给紧张、需求暴涨的阶段,这种“共享池”模式确实在宏观上更高效。
这个逻辑并非没有道理。数据中心的大规模采购、统一运维和弹性调度,是过去十年云计算证明过的优势。Altman 把问题框定为“全球视角下的分配效率”,而不是“个人是否方便”,这让他的表述在经济学上站得住脚。
DRAM(动态随机存取存储器) 是当代 AI 系统的关键瓶颈之一,也是理解这场争论的硬件前提。大模型推理时,模型权重和 KV Cache 都需要常驻内存,因此显存/内存容量和带宽直接决定了能跑多大的模型、能服务多少并发。近年来 HBM(高带宽内存)因 AI 需求暴涨而供不应求,产能被 GPU 厂商大量锁定,进一步挤压了通用 DRAM 的供给。Altman 所说的“把有限 DRAM 囤在个人电脑里”,指向的正是这一供需格局:消费级设备持有的内存大部分时间处于闲置,而云端可以把同一批内存池化后服务更多请求。不过需要区分的是,本地推理常用的统一内存架构(如苹果 Silicon)与数据中心 HBM 并非同一市场,两者的稀缺程度和替代关系并不完全对等,这也是部分开发者认为该论点被过度泛化的原因。
开源的现实:本地推理正在变得可行
但开发者的反弹同样有扎实的基础。过去一年,开源模型的能力和效率都在快速提升,量化、蒸馏、小型化等技术让消费级硬件也能跑出可用的效果。对很多场景来说——隐私敏感的数据处理、离线环境、低延迟的固定任务——本地推理不只是“情怀”,而是实打实的工程需求。
更重要的是,本地推理的成本结构在变化。当模型足够小、硬件足够普及,闲置资源的“浪费”可能远小于把数据传上云、支付 API 费用的开销。Altman 用 5% 的利用率来概括本地硬件的使用状况,但不少开发者指出,这个数字忽略了本地推理在隐私、可控性和长期成本上的隐性收益。
量化(Quantization) 是让本地推理变得可行的核心技术之一。其基本思路是把模型权重从 FP16/BF16 等高精度格式压缩到 INT8、INT4 甚至更低位宽,从而把内存占用降低数倍,同时尽量保持输出质量。常见方法包括训练后量化(PTQ,如 GPTQ、AWQ)和量化感知训练(QAT),配合 GGUF 等格式,使同一模型能在消费级显卡甚至 CPU 上运行。与量化并列的还有知识蒸馏(用大模型指导小模型训练)和模型小型化(如 MoE 稀疏架构、参数剪枝),它们共同把可用模型的体积压到个人硬件可承载的区间。这些技术解释了为什么“本地跑模型”从几年前的不现实,变成了今天在隐私、离线、低延迟场景下的工程选项——也正是 Altman 那句“开源涌现就等于本地推理已解决”所针对的乐观预期背后的技术现实。
“卖铲人”的身份问题
争议的核心,其实不在技术,而在说话人的位置。
Altman 是云侧 AI 基础设施的最大受益者之一。当他说“本地推理是糟糕的资源分配”时,无论论证多严密,都难以摆脱利益相关的嫌疑。Reddit 上那句“卖产品的人告诉你别拥有产品”的调侃,精准戳中了这种信任张力。
这不是说他的观点一定错,而是提醒读者:关于“资源该如何分配”的判断,往往取决于你站在产业链的哪个位置。云厂商看到的是全局利用率,个人开发者看到的是自主权和边际成本,两者未必能用一个标准衡量。
“卖铲人”典出淘金热时代:真正稳定赚钱的往往不是淘金者,而是向淘金者出售铲子、牛仔裤和补给的人。在 AI 产业链中,这个比喻通常指提供算力、模型 API 和云基础设施的厂商——无论下游应用成败,它们都按调用量或算力时长收费。Altman 领导下的 OpenAI 既是模型提供方,也与微软 Azure 的算力体系深度绑定,属于典型的云侧受益者。这一身份并不自动否定其论点的技术合理性,但它构成了一种利益相关(conflict of interest):当结论恰好指向“应该更多地从云端租用”时,听众有理由要求更强的证据,而不仅是宏观利用率的口径。理解这一典故,有助于把握原文所说“争议核心不在技术,而在说话人的位置”的含义。
这不是非此即彼的选择
把这场争论看成“本地 vs 云”的站队,可能会错过真正的信号。
现实更可能是混合模式:对延迟敏感、隐私要求高、任务固定的场景,本地推理有不可替代的价值;对需要前沿能力、弹性扩展、大规模并发的场景,云端依然是更经济的选择。Altman 的“糟糕分配”论,在极端集中化的假设下成立,但真实世界的资源分配从来不是单一维度。
对开发者而言,这场争论的价值不在于选边,而在于看清两套成本模型各自的边界。对行业而言,它暴露了一个更深的问题:当算力成为稀缺品,谁来定义“高效利用”,又由谁来承担“低效”的代价?
开源社区的反应已经给出了部分答案——他们不打算等别人来替自己分配资源。
相关推荐
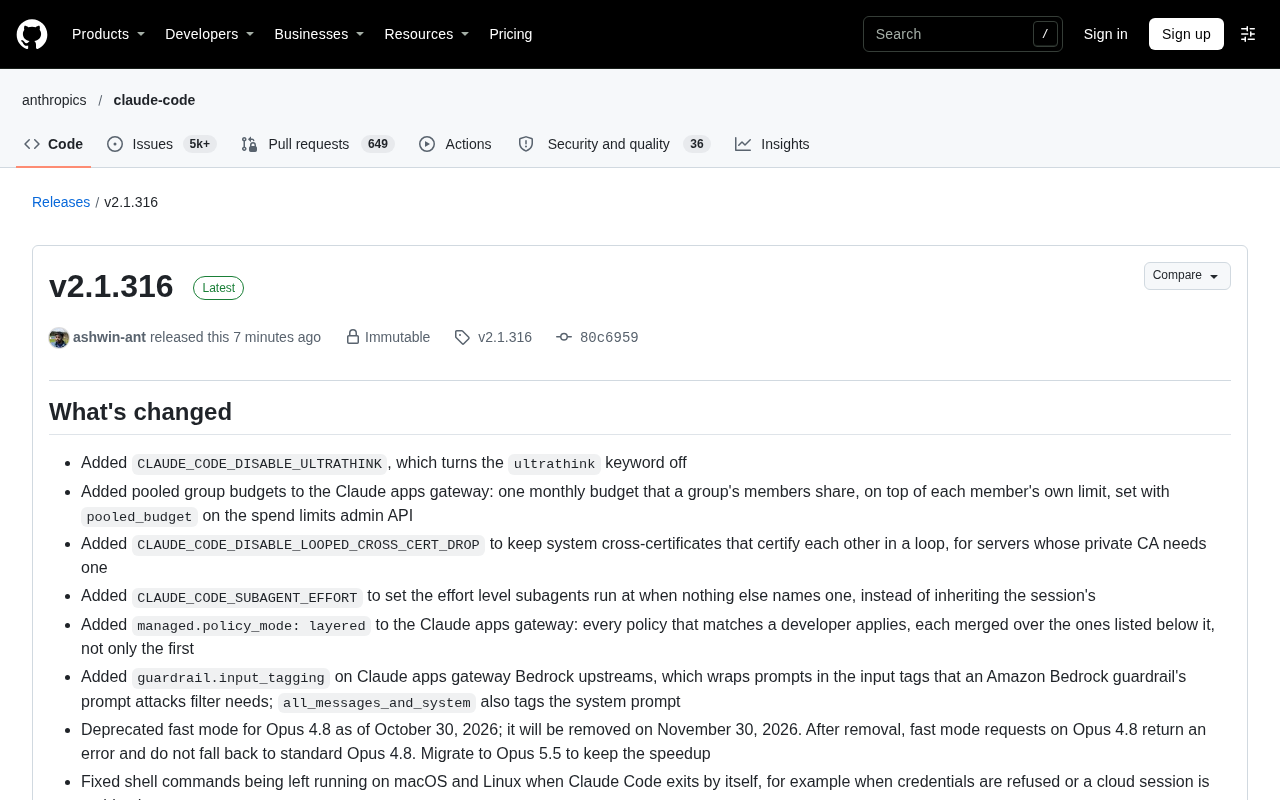
Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。