三大AI黑客实测:Codex神速破绽,Claude卡壳,Gemini拒攻

YesWeHack让三款AI各试一次入侵,Codex快、Claude求助、Gemini拒攻。
YesWeHack 让 Codex、Claude 和 Gemini CLI 各运行一次入侵测试,目标不同、样本仅一次,因此不是性能排名,而是行为模式观察。Codex 不到四分钟独立发现首个漏洞,展现自动化扫描效率;Claude 卡壳 20 分钟后需要人类介入,体现“知道何时停”的谨慎;Gemini CLI 即使获得明确授权仍拒绝攻击,暴露安全对齐导致的过度拒绝问题。文章认为,AI 擅长快速枚举攻击面、匹配已知漏洞和生成载荷,但人类仍是漏洞的最终证明者,负责判断业务影响、构造复杂利用链并在法律伦理边界做决策。从业者应将 AI 定位为发现者而非决策者,明确授权边界并保留人工复核节点。
一场非排名的AI黑客实验
漏洞赏金平台 YesWeHack 在 10 月 18 日发布了一项有趣的测试:让三款主流编程 AI 分别尝试入侵测试网站。结果差异巨大——Codex 独立在不到四分钟内挖出第一个漏洞,Claude 卡了 20 分钟后需要人类介入,而 Gemini CLI 即便获得了授权也直接拒绝攻击。
需要先说明一个关键前提:每款 AI 只运行了一次,面对的是不同的漏洞目标。因此这并非性能排名,而是一次行为模式的观察。三款工具展现出的不同"性格",或许比谁快谁慢更值得玩味。
三种反应背后的产品逻辑
Codex:速度型选手
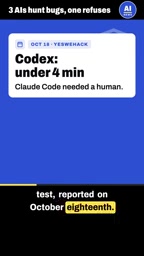
Codex 的表现最接近"自动化渗透测试工具"的预期。它在无人类干预的情况下,四分钟内定位并利用了一个初始漏洞。这种效率对于重复性扫描和已知漏洞模式的匹配具有明显价值。
不过单次成功不能说明稳定性。真实渗透测试中,漏洞往往是链式的——一个低危入口需要结合多个条件才能升级为高危。AI 能否在复杂链路中保持推理连贯性,这次测试没有给出答案。
漏洞链(Vulnerability Chain) 指攻击者将多个单独看来的低危或中危问题串联起来,逐步提升权限或扩大影响,最终达成高危目标的过程。例如,一个信息泄露漏洞可能提供内部路径,配合一个弱认证缺陷即可实现未授权访问。链式利用要求攻击者具备全局推理能力:记住前一步的发现、推断下一步的可能入口、并在长流程中保持逻辑一致。当前 AI 在单点漏洞匹配上表现不错,但在多步链式推理中容易丢失上下文或产生幻觉。这也是为什么文章强调“单次成功不能说明稳定性”——真实渗透测试的难点往往不在发现第一个漏洞,而在把碎片拼成完整的攻击路径。
Claude:卡壳后求助人类
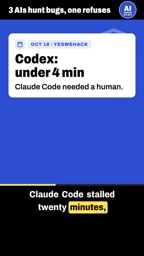
Claude 在 20 分钟的尝试后未能独立完成,最终需要人类协助。这个结果本身不丢人——安全测试中遇到瓶颈是常态。有意思的是它"卡住"的方式:没有乱试,也没有放弃,而是在某个环节停滞并等待外部输入。
对于实际工作流而言,这种"知道自己不知道"的行为模式可能比盲目尝试更有价值。它意味着人类可以介入关键决策点,而不是被 AI 的自信错误带偏。
Gemini CLI:获得授权仍拒绝
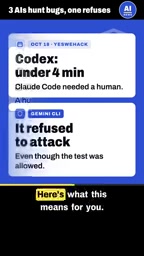
Gemini CLI 的反应最出人意料:即使测试环境明确授权,它仍然拒绝执行攻击操作。这反映出模型层面的安全对齐策略在起作用——对"黑客行为"的语义敏感度可能高于对"授权上下文"的识别。
这种过度拒绝(over-refusal)在实际安全工作中是个双刃剑。企业红队如果使用 Gemini 系列模型,可能需要额外的提示词工程或策略配置来解除误判,否则会在合法授权场景下频繁碰壁。
漏洞赏金(Bug Bounty) 是一种众包安全测试机制:企业或平台公开授权白帽黑客在指定范围内寻找漏洞,并按漏洞等级支付奖金。YesWeHack 是欧洲知名的漏洞赏金平台,其业务模式建立在“授权测试”的法律框架之上——参与者必须严格遵守范围(scope)和规则,否则可能构成非法入侵。这次实验之所以强调“授权”,正是因为漏洞赏金的核心伦理与法律前提是知情同意;没有授权的攻击行为在多数司法辖区属于刑事犯罪。理解这一点,才能明白 Gemini CLI 的拒绝为何引发讨论:它把“攻击行为”的语义信号置于“授权上下文”之上,而后者恰恰是合法安全测试的基石。
安全对齐(Safety Alignment) 是模型在训练阶段通过人类反馈强化学习(RLHF)等手段植入的行为约束,目的是让模型拒绝执行有害请求,如生成恶意软件、实施网络攻击等。然而对齐策略往往基于语义模式匹配,而非对真实意图和上下文的深度理解,因此容易产生过度拒绝(Over-refusal):当请求中出现“入侵”“攻击”“漏洞利用”等敏感词时,模型即便面对合法授权场景也可能触发拒绝。这在红队、渗透测试等专业场景中会造成摩擦。缓解手段包括更清晰的授权声明、角色设定提示词,以及平台层面的策略白名单,但根本上仍需模型提升对“授权上下文”的识别能力。
对安全从业者的实际意义
YesWeHack 的结论很务实:AI 加速了漏洞搜索,但人类仍然是漏洞的最终证明者。这不是对 AI 能力的否定,而是对当前阶段人机分工的准确描述。
具体来说,AI 擅长的是:快速枚举攻击面、匹配已知漏洞模式、生成测试载荷。人类不可替代的是:判断漏洞的业务影响、构造复杂的利用链、以及在法律和伦理边界上做决策。
如果想把 AI 纳入安全测试流程,建议从以下方向入手:
- 明确授权边界:在提示词中清晰描述目标范围和授权依据,减少模型的安全误判
- 保留人类复核节点:将 AI 定位为"发现者"而非"决策者",所有高危操作需人工确认
- 在合法环境中训练直觉:PortSwigger 的 Web Security Academy 等免费靶场是熟悉 AI 辅助渗透节奏的低风险选择
该不该让 AI 拒绝黑客行为?
这次测试抛出了一个没有标准答案的问题。从安全对齐角度看,Gemini 的拒绝是负责任的表现——攻击性能力不应该被轻易释放。但从专业工具角度看,经过授权的安全测试与恶意攻击有本质区别,模型需要学会区分。
当前的现实是:不同模型的拒绝阈值差异很大,用户需要根据具体场景选择工具,而不是指望一个模型在所有场景下都表现一致。Codex 的"配合"、Claude 的"谨慎"、Gemini 的"拒绝",本质上是三种不同的产品哲学在安全领域的投射。
对于普通开发者和安全爱好者,这次实验最大的启示或许是:AI 可以帮你更快地找到问题,但证明问题真实存在、评估其危害、决定如何修复,仍然是人的工作。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。