三个00后用中国开源模型抢OpenAI客户,18个月估值32.5亿

三个前OpenAI的00后用中国开源模型为企业训练专属模型,一年半估值涨至32.5亿美元。
三个斯坦福同学、前OpenAI员工创立Applied Compute,不造更大的通用模型,而是以通义千问、Kimi、GLM等中国开源模型为底座,用企业自有数据通过强化学习训练专属模型并部署在企业自有云上,成本可低至顶级大模型的十分之一。DeepSeek R1的发布被视为转折点,让三人看到开源模型够强够便宜、缺的只是企业级基础设施。公司成立不到18个月年化收入超1亿美元,估值达32.5亿美元。法律AI公司Harvey用GLM5.1训练的智能体在自有评测中超过GPT5.5与Claude Opus4.8,DoorDash、英伟达、微软等亦为客户。创始人认为未来企业会按场景混用贵模型与便宜模型,护城河仍待检验。
从OpenAI离职的00后,为何押注中国开源模型?
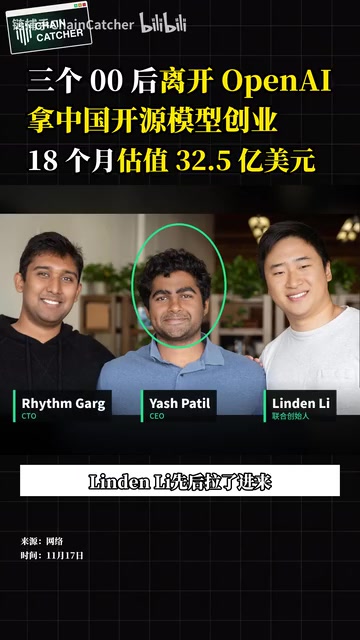
三个斯坦福同学、前OpenAI员工,用中国的开源大模型做底座,专门帮企业训练专属模型,成立不到18个月年化收入超过1亿美元,估值32.5亿美元——这是Applied Compute(素材中亦写作Obsidic Compute)的故事。三位创始人最大的25岁,最小的23岁。CEO Yash Patel在斯坦福读书时恰逢GPT上线,他直接给Sam Altman发邮件表达参与意愿,20岁进入OpenAI,参与了后来的Codex;同学Rhythm Garg参与了推理模型OE的研发;Lyndon Lee是华裔,初中和高中都在上海读。
转折发生在DeepSeek广告发布R1那天。素材引用投资人Mark Anderson的说法,称这是硅谷的「斯普特尼克时刻」——美国被打了个措手不及。当时三个人正在太浩湖滑雪,一整天都在讨论DeepSeek。别人担心中国模型追上来,他们看到的却是机会:中国开源模型已经够强够便宜,缺的只是一套把它们调教成企业专用模型的基础设施。
不造更大的通用模型,而是做企业专属模型
五个月后,三人从OpenAI离职创业。他们的模式很清晰:不去造一个更大的通用模型,而是拿开源模型做底座——比如阿里的通义千问广告、月之暗面的Kimi——用企业自己的数据和业务流程,通过强化学习训练出专属模型,放在企业自己的云上跑。
打个比方,通用大模型像一个什么都懂的外部顾问,但不了解你的公司;他们训练出来的模型更像一个只为你干活的内部员工。
这套模式的成本优势非常突出。Patel表示,在一些场景下他们的模型能比顶级大模型便宜十倍。资本也看懂了:2025年6月种子轮估值1亿美元,2026年4月达到13亿美元,这个月新一轮3.5亿美元融资后估值32.5亿美元,一年半涨了30多倍。收入涨得更猛——成立半年时年化收入1280万美元,现在已经超过1亿美元。
强化学习与专属模型训练
文中提到的「通过强化学习训练出专属模型」,指的是在预训练好的开源基座模型之上,利用企业自有数据与业务反馈信号进行后训练(post-training)。常见做法包括监督微调(SFT)与基于人类或规则反馈的强化学习(RLHF/RLAIF):前者让模型学会企业特定的表达与流程,后者通过奖励信号引导模型在特定任务(如合同审查、菜单生成)上优化输出质量。与从头预训练一个通用大模型相比,这种方式算力需求低得多,且能针对垂直场景打磨准确率,这也是能在成本上比顶级通用模型便宜一个数量级的关键原因。同时,模型部署在企业自有云上,数据不出域,满足了金融、法律等行业对合规与隐私的硬性要求。
中国开源模型在美国公司的考卷上赢了
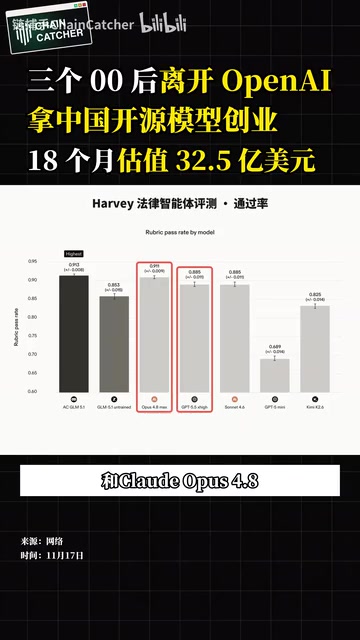
最能说明问题的是法律AI公司Harvey的案例。他们用智谱的GLM5.1做底座训练了一个法律智能体,在Harvey自己的法律评测里,得分超过了GPT5.5和Claude Opus4.8,成为当时表现最好的模型。一个中国开源模型经过专门训练,在美国公司的考卷上赢了美国最顶尖的两家大模型。
其他客户也很亮眼:DoorDash用它帮餐厅入驻时自动生成准确的菜单;英伟达用它给自家的开源模型做后训练;微软也是客户,CEO纳德拉还专门跟Patel做过一场对谈。
关于GLM系列与「开源」口径
文中提到的GLM5.1来自智谱(Zhipu AI),其GLM系列是国内较早对标国际主流大模型的产品线,并陆续以开放权重(open weights)方式发布,允许企业下载部署与二次训练。需要说明的是,业内所说的「开源模型」多指权重可获取、许可允许商用与微调的开放权重模型,未必完全符合OSI的严格开源定义。正因权重可下载,企业才能在自己的环境中做后训练并保留数据控制权——这正是Applied Compute模式得以成立的前提。Harvey评测中的「考卷」则指其自建的法律领域基准,属于垂直场景的专项测试,成绩反映的是特定任务上的表现,而非全面能力。
贵的模型和便宜的模型混着用
Patel很清醒。他不认为企业会抛弃OpenAI和Anthropic,未来更可能是贵的模型和便宜的模型混着用,看场景挑。开源模型人人都能用,他们的护城河在哪儿,也还需要时间检验。
但这个故事最耐人寻味的地方在于:三个从OpenAI出来的年轻人,被一个中国模型点醒,用中国的开源模型跟老东家抢起了企业客户。中国开源模型能否成为全球AI的底座?答案或许就在这些「只为你干活的内部员工」身上。
(注:素材中公司名、人名存在音译差异,本文以素材表述为准。)
背景补充
「斯普特尼克时刻」的由来
这一说法源自1957年苏联发射人类第一颗人造卫星「斯普特尼克1号」,美国由此意识到在太空竞赛中落后,随后催生了NASA与大规模科研投入。此后该词被广泛借喻为「令整个行业警醒、被迫重新评估竞争格局的标志性事件」。文中投资人用它形容DeepSeek R1的发布:一个中国团队以远低于外界预期的成本推出性能强劲的推理模型,让硅谷重新审视开源路线的成本结构与竞争态势。需要指出的是,这类比喻强调的是心理冲击与战略转向,而非严格的技术排名,R1的意义更多在于证明了高强度推理能力可以用更开放、更廉价的方式获得。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。