三个Skill让AI Agent自己提PR并合并:Soul Loop、Full Send与Full Stop实战

B站UP主t3.gg分享三个AI编程Skill,让Agent自主完成从修改到PR合并的闭环。
t3.gg从重复劳动中提炼出Soul Loop、Full Send和Full Stop三个Skill,用于解决AI编程助手在代码评审、自主合并和接管PR时的瓶颈。Soul Loop通过三轮评审预算和范围约束防止蔓延,并用GPT-5.1 Codex做彻底评审;Full Send设计合并闸门与证明机制,确保Agent在验证通过后自主合并,32次使用中27次零事故;Full Stop是安全版本,干到可合并为止但永不合并,配合Takeover保留原贡献者署名。此外,多Agent编排和订阅复用提升了评审多样性,核心收获是工作流思维而非照搬技能文件。
AI编程助手已经能写代码了,但真正的瓶颈往往不在写代码本身,而在于如何让Agent自主完成从修改到合并的闭环。B站UP主t3.gg分享了他日常高频使用的三个Skill——Soul Loop、Full Send与Full Stop,它们不是精心设计的理论框架,而是从反复出现的重复劳动中固化下来的工作流。这三个Markdown文件正在改变他写代码的方式,也让Agent能够自己提PR并完成合并。
从重复劳动中长出来的Skill
t3.gg在视频中坦言,这些Skill并非先有绝妙点子再硬塞进工作流,恰恰相反——是他发现自己一遍又一遍在做某些事,才把这些行为变成了技能。在做T3 code项目时,差不多一半的PR最终都会用到这三个技能中的一个,而那些最终能合入的PR几乎都至少用了其中一个。
他把所有Skill放在一个叫Fli的仓库里,按类型分文件夹管理:有些只在Claude Code里用,有些只在特定机器上用,还有一些希望几乎所有机器都同步。这种集中管理让多台机器之间的认证、MCP配置和技能保持同步变得可行。
一个容易被忽视的细节是Skill的description字段。t3.gg强调,description并不是描述这个技能是什么,而是给模型的触发器提示,告诉它什么时候该用。比如Soul Loop的description就写“用户说Soul Loop时使用”,除非明确点名或别的技能提到它,否则不会被拉进来。
Claude Code 与 Codex 的 Skill 机制
文章中的 Skill 指的是在 Claude Code 和 OpenAI Codex 等 AI 编程助手环境中,通过 Markdown 文件定义的、可被模型识别并调用的工作流指令集。每个 Skill 包含名称、description(触发器提示)和具体步骤约束。当用户输入与 description 匹配时,模型会自动加载该技能并遵循其规则执行任务。这种机制允许开发者将重复性的操作流程(如评审、合并、接管)固化为可复用的模块,从而扩展 Agent 的自主能力边界。Skill 文件通常存放在特定目录(如 .claude/skills 或项目根目录),并可通过版本控制同步到多台机器。
Soul Loop:让GPT-5.1 Codex做代码评审
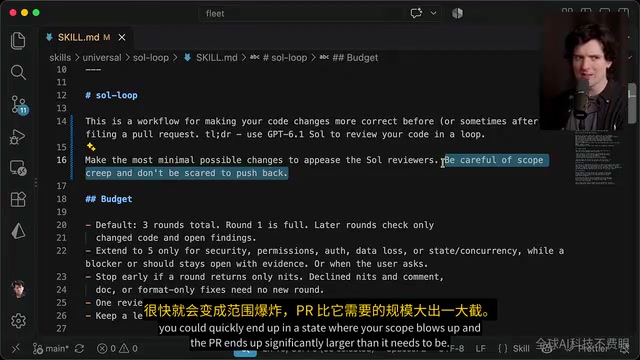
Soul Loop的核心逻辑很简单:代码你写,搜来审,对的就改,不对的就顶回去;当你俩意见一致或者预算用完就停。目标是拿到满足意图的最小改动,评审是让它变对,不是让它变大。
t3.gg在技能里加了明确的预算控制:总共三轮,第一轮全量过,后面几轮只看改动过的代码和还没关掉的问题;只有涉及安全、权限、数据丢失等潜在风险时才延到五轮。如果某一轮只剩小毛病就早点停,纯评论文档这类不重要的内容直接拒掉。同时规定一次只能有一个评审,Soul不该自己起子agent,也不该自己找评审,否则嵌套会飞快膨胀。
“小心范围蔓延,别怕顶回去”这句话被t3.gg视为特别重要的补充。多个意见不同的Agent互相炒很容易导致范围爆炸,PR比需要的规模大出一大截,这个小小的约束能挡住很多这种情况。
在模型搭配上,他发现Opus 5.5是更好的合作者,整体更聪明、代码写得好太多;但GPT-5.1 Codex更彻底,像条罗维纳咬住问题不松口,所以特别喜欢拿它做评审。这套工作流让大量PR在上了GitHub之后免于陷入无限评审循环,当Macroscope、Graphite、CodeRabbit等AI代码评审工具看到代码时,通常已经很扎实了。
Full Send:从当前状态一路干到PR合并
Full Send的触发条件很明确:用户要求Full Send时触发,说明用户没在盯这条线程,想要Agent把活从头到尾自主干完。如果用户没有明确要求,就不能自作主张当成完全自主。
t3.gg在技能里写明了授权内容,因为某些模型(尤其是OpenAI的模型)在合并这件事上特别紧张,除非上下文里明确写着用户给了明确许可。他专门加了一段:授权你在合并闸门通过之后合并这个PR,并在Rebase之后用Force with Lease强推自己的分支。
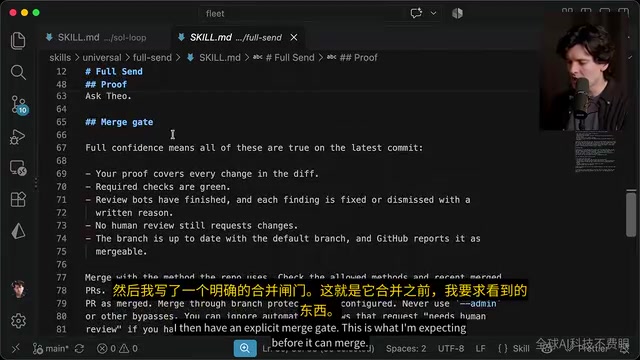
合并闸门是这个技能最核心的部分,要求证明覆盖每一处改动、所有必须过的检查全绿、所有评审机器人都跑完且问题要么修了要么写了理由驳回、没有人类评审还在要求修改、分支跟默认分支同步、GitHub报告可以合并。证明部分要求模型自己找到某种方式验证改动真的生效:先复现原来的故障,应用修复,然后看着同一个复现过程跑通;跑一遍仓库CI会跑的检查;如果行为原本没有测试而仓库有测试环境,就补一个不修复必然失败的针对性测试;UI和运行时行为则把应用跑起来自己看一眼。
另一个关键设计是提问闸门。模型得知到用户在无视这条线程时,必须用Harness的提问工具,而不是在普通消息里问一句——因为普通消息根本看不见,线程看起来还像干完了。在Claude Code里用Ask User Question,在Codex里用Request User Input,问题里要带上PR链接、被什么卡住、推荐的选项。t3.gg设了闸门写着“除非否则别问”,因为不加这段模型什么都来问。
他在有限时间窗里用了32次Full Send,其中27次自己合掉,一眼都没再看。这听起来有点疯,但背后的逻辑是:你得建好的验证系统让Agent自己能确认东西行不行,还得建好的安全网,真炸了也能在影响大部分用户之前抓到并修好。T3 code每6小时发一个Nightly,一旦弄坏什么反馈马上就来。
合并闸门与证明机制
合并闸门(Merge Gate)是 Full Send 技能中的核心质量关卡,它要求 Agent 在合并 PR 前必须满足一系列可验证的条件:证明覆盖每一处改动、所有必须过的检查全绿、所有评审机器人的问题已修复或驳回、无人类评审要求修改、分支与默认分支同步、GitHub 报告可合并。证明机制则强制 Agent 展示证据,例如复现原始故障、应用修复、重新运行复现过程确认通过;运行仓库 CI 检查;为无测试的修复补写针对性测试;或运行应用进行 UI 和运行时行为验证。这种设计将“信任”转化为可验证的证据链,确保 Agent 的自主操作具备可审计性和可靠性。
Full Stop:干到能合并为止,但永远别合并
Full Stop是照着Full Send重做的,只改了一个大地方:一直负责到PR准备好让用户合并为止,不停修、不停验证、不停审,但永远别合并。t3.gg自嘲这个技能基本上整个就是一坨垃圾,大概应该叫Full Slop,但它存在的原因是他太喜欢Full Send那套流程,碰上更吓人的改动时特别想念它——不想让它们合并,但别的活都干完,等它来烦的时候东西已经能发了。
这个技能很快成了高频使用的技能。t3.gg说开播时有人发PR让他看,几乎每一个他打开后第一句就是“你自己搞定,Full Stop”。有人在推特私信里报bug还附上两个修复PR,他懒得从头看,直接复制粘贴消息说“接手,落地,Full Stop”。
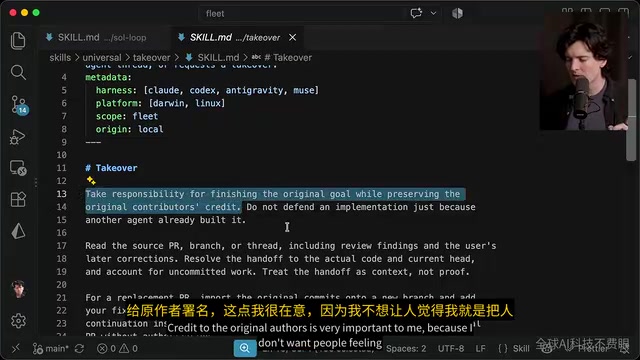
配套的Takeover技能则处理另一类场景:接手已有的工作,当用户要求接手一个PR、分支或Agent线程时使用,负责把原本的目标做完,同时保留原贡献者的署名。t3.gg很在意这一点,不想让人觉得他就是把人家PR一关然后把点子抄了,而是想让提最初那个PR的人拿到该有的功劳,只是让团队里一个信得过的人把他推到终点。
多Agent编排与订阅复用
t3.gg还展示了T3 Code Nightly的Orchestrator VR功能:让Agent和线程在T3 Code里调用别的Agent、别的Harness、别的线程。他让Claude Code跑Opus,同时把GPT-5.1 Codex和Gemini的模型以各自原生Harness拉进来并行评审。不同模型训练方式不一样,就像找三个经历不同的人审同一个PR,发现独有问题的概率更高。他认为OpenAI的模型最彻底,能比别人查出更多东西;Gemini有时能挖出古怪的坑,但编造的比真找出来的还多。
关于订阅复用,他推荐搭一个CLI proxy把所有认证集中到一处,这样里面能访问的所有模型都能在任意工具里用。但需要留意:把Claude的模型拿到别处用时,如果系统提示词不是Claude Code那套,Anthropic会非常不高兴;OpenAI则不管Token花在哪。他自己是Codex订阅用在Codex上,Claude订阅用在Claude上。
原生 Harness 与 CLI Proxy
Harness 指运行 AI 模型的原生工具环境,例如 Claude Code 用于运行 Anthropic 模型,Codex 用于运行 OpenAI 模型。不同模型在各自原生 Harness 中能发挥最佳性能,并支持该环境特有的功能(如提问工具、文件操作等)。CLI Proxy 则是一个中间层服务,将不同服务的认证信息(如 API Key、OAuth Token)集中管理,使任意工具都能通过代理调用已授权的模型。这解决了多工具间认证碎片化的问题,但需注意服务条款:例如将 Claude 模型用于非 Claude Code 环境可能违反 Anthropic 的使用政策,而 OpenAI 对此相对宽松。开发者应合理配置代理,避免账号风险。
工作流思维才是真正的收获
t3.gg最后强调,希望观众学到的不是去抄他的Markdown文件,而是看到他怎么给自己遇到的问题找解法。他在搭建越来越抽象的工作流,参与的那一层跟以前不一样了,某种意义上成了自己的管理者。想把Agent用到极致,就得分析自己的流程,搞清楚哪些事敢信它们、哪些不敢,然后把这些编码进技能里。
他甚至提到了一个正在酝酿的新项目T-Stack,暗示这些技能未来可能会放进某个仓库。对于想尝试的开发者来说,起点不必是完整的三个Skill——从自己反复对模型说的那句话开始,把它变成一个带触发器和边界约束的技能文件,就已经迈出了第一步。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。