SCIM日志功能上线:直击身份供给调试痛点
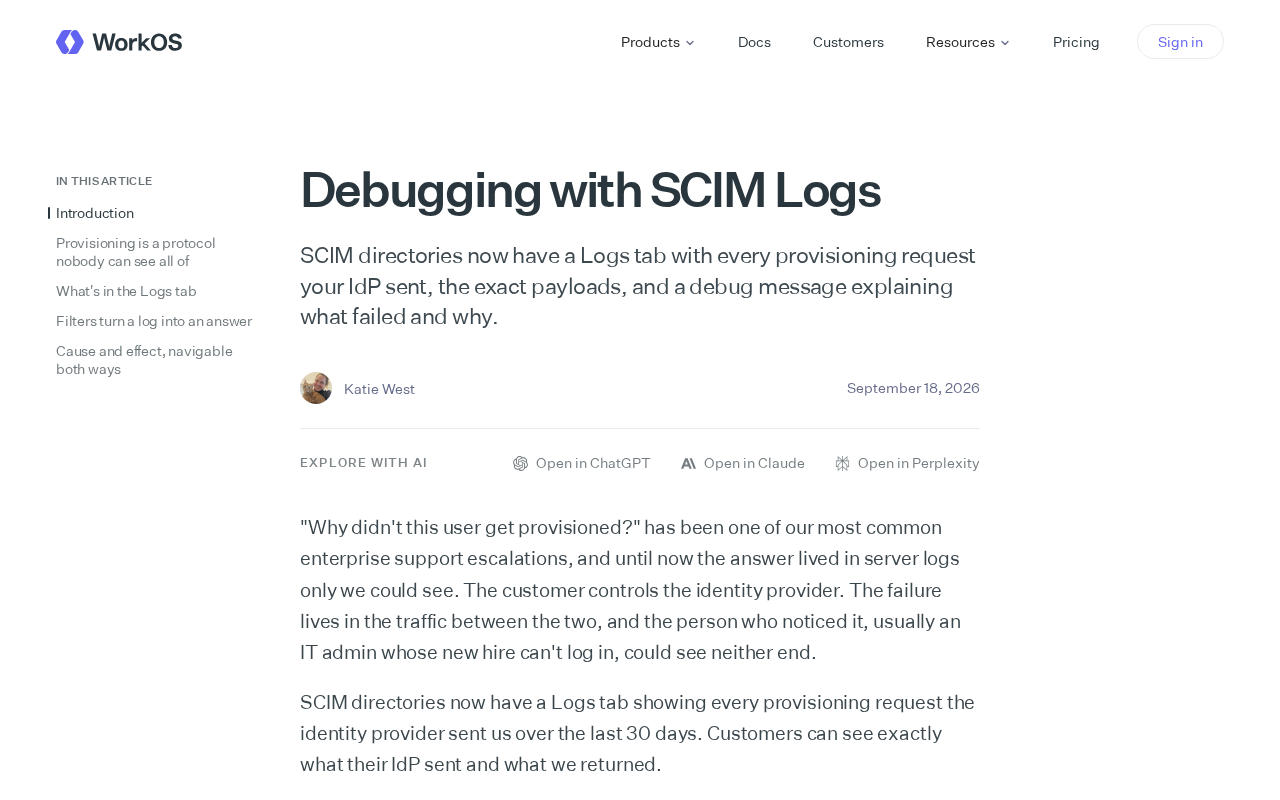
SCIM目录新增日志标签页,通过完整请求记录与可读错误说明解决身份供给调试长期不透明的痛点。
SCIM身份供给长期因缺乏可观测性而令运维团队头疼——失败时只有模糊状态,无法直接查看IdP发送了什么。此次新增的Logs标签页通过三个核心能力填补了这一缺口:完整记录每一次供给请求的时间线、暴露精确的JSON请求体payload,以及为每条失败记录附加人类可读的调试说明。这使属性映射错误、字段格式不符等高频故障的定位从"靠猜测"变为"有据可查"。从更大背景看,这反映出身份供给工具正向"可观测性优先"演进,将被动响应投诉的排障模式转变为主动监控。不过,日志中包含员工PII数据,日志保留周期、访问权限与敏感信息脱敏等合规细节仍是企业落地时需要重点评估的因素。
SCIM调试为何一直是运维噩梦
在企业身份管理体系中,SCIM(System for Cross-domain Identity Management,跨域身份管理系统)承担着自动化用户供给(provisioning)的核心职责。当身份提供方(IdP)向下游应用同步用户创建、更新、停用等操作时,任何一个环节的失败都可能导致员工无法登录、权限错配,甚至安全隐患。
长期以来,SCIM集成的调试过程被诟病为“黑盒操作”。管理员往往只能看到一个模糊的失败状态,却无从得知IdP到底发送了什么请求、请求体(payload)的具体内容,以及失败背后的真正原因。排查一次同步异常,常常需要在IdP控制台、目标应用日志和网络抓包之间来回切换,效率极低。
SCIM协议由IETF于2015年通过RFC 7642/7643/7644正式标准化,定义了一套基于REST和JSON的通用接口,用于在不同系统之间自动同步用户与群组数据。典型的供给链路是:企业在Okta、Azure AD、OneLogin等IdP中变更员工状态(入职、转岗、离职),IdP随即通过SCIM API将变更推送给Salesforce、GitHub、Slack等下游应用。这一链路的复杂性在于,协议规范与各厂商的实际实现之间存在大量差异——attribute mapping(属性映射)的字段名不一致、必填字段定义各异、错误响应格式五花八门,都是集成失败的高发地带。由于推送是IdP主动发起的异步操作,接收端一旦静默拒绝或返回模糊错误,管理员在IdP侧几乎无从察觉,这正是"黑盒"体验的根源所在。
新增Logs标签页带来了什么
根据原始信息,SCIM目录现在新增了一个专门的Logs(日志)标签页,直接把调试所需的关键信息集中呈现。这一改动看似简单,但对一线运维和集成开发者而言意义重大。
完整记录每一次供给请求
新的日志页面会记录IdP发送的每一个供给请求。这意味着管理员不再需要依赖IdP侧的有限日志,而是可以在接收端直接查看请求的时间线,快速定位是哪一次同步出了问题。对于批量用户变更场景,这种逐条可追溯的记录尤其有价值。
暴露精确的请求负载
日志中包含了确切的请求体(exact payloads)。SCIM协议基于JSON进行数据交换,用户属性映射错误、字段缺失、格式不符是最常见的失败根源。能够直接查看原始payload,就等于把“IdP以为自己发了什么”和“系统实际收到了什么”摆在了同一张桌子上,属性映射类问题的定位时间会大幅缩短。
SCIM的数据交换格式遵循RFC 7643定义的Schema体系,核心资源类型包括User和Group,每个属性都有严格的数据类型与多值规则。实践中最容易出错的场景包括:IdP将externalId映射到错误字段、phoneNumbers等多值属性的type标签与目标系统预期不符、以及PATCH操作中op值大小写不一致(标准要求小写,但部分IdP发送大写)。这类问题在没有原始payload的情况下几乎只能靠逐行比对文档来猜测,能够直接查看接收端记录的完整JSON请求体,意味着可以将IdP实际发送的内容与SCIM Schema定义逐字段核对,将原本数小时的排查压缩到分钟级。
给出可读的调试信息
最实用的一点是,每条记录都附带一条解释失败原因的调试信息(debug message)。这把原本晦涩的HTTP状态码和协议错误,转化为人类可读的说明——告诉你什么失败了、为什么失败。对于不熟悉SCIM规范细节的管理员来说,这类明确的错误提示能显著降低排查门槛。
对企业身份集成实践的影响
这项功能反映出身份供给工具正在向“可观测性优先”的方向演进。过去,SCIM集成更多被当作一次性配置任务,配好即忘;一旦出问题,往往要等到用户投诉才被动响应。而完整的请求日志加上失败解释,实际上把被动排障变成了主动可观测。
对于负责多应用SSO与自动化供给的IT团队,这种透明度意味着更快的故障恢复、更少的跨团队甩锅,以及在上线新集成时更平滑的联调体验。开发者在对接SCIM接口时,也能借助日志验证自己的实现是否符合预期,而不是靠猜测。
值得关注的局限
需要说明的是,原始信息量较为有限,仅描述了功能的存在与核心能力,并未提及具体的日志保留周期、访问权限控制、是否支持导出或告警集成等细节。这些恰恰是企业级场景中同样重要的考量因素。此外,日志中包含用户属性的完整payload,也意味着需要关注其中可能涉及的敏感信息与合规处理方式。
总体来看,为SCIM目录补上日志调试能力是一次务实且必要的改进,它直接回应了身份供给领域长期存在的可观测性缺口,让原本靠经验和猜测的调试工作有了确切的数据支撑。
在合规层面,SCIM payload中通常包含姓名、邮箱、部门、职级乃至电话号码等员工个人信息,属于GDPR、CCPA等法规下的个人可识别信息(PII)。日志系统若未对这些字段做脱敏处理,或缺乏基于角色的访问控制(RBAC)限制谁可以查看原始payload,则可能引入新的数据泄露风险。企业在启用和使用此类调试功能时,通常需要评估日志的访问审计、留存期限与自动清除策略,并确认其是否符合内部的数据最小化原则。这也是为何日志保留周期与权限控制,并非锦上添花的附加功能,而是影响该能力能否在受监管行业落地的关键变量。
相关推荐
AI聊天机器人与语音助手:企业实际落地的价值与局限
AI聊天机器人和语音助手正帮助企业自动化线索管理与重复客户沟通。本文剖析它们在预约、客服、线索筛选中的实际价值,以及落地过程中的常见局限,探讨AI如何协作而非替代人力。
Claude Code 原生支持 AGENTS.md:AI 编程配置迈向标准化
Anthropic 的 Claude Code 将原生支持 AGENTS.md 配置文件,推动 AI 编程工具配置走向标准化。本文解析 AGENTS.md 的作用、与 CLAUDE.md 的关系及其对开发者工作流的影响。
ICLR投稿量突破4.7万?学术会议爆炸式增长背后的隐忧
一位研究者晒出ICLR投稿编号47647引发热议。本文分析AI顶会投稿量爆炸式增长的原因、由此引发的同行评审危机,以及对研究者的现实影响。