Scrapling:全能Python网页抓取框架,单请求到大规模爬取

Scrapling 是一个快速走红的 Python 网页抓取框架,主打从单请求到全面爬取的一体化体验。
Scrapling 是 D4Vinci 开发的 Python 网页抓取框架,在 GitHub 上已获得超过 92,000 颗星和 9,700 多次 fork,单日新增 892 颗星,社区关注度极高。其设计哲学是“不害羞”,鼓励用户从简单请求起步,逐步扩展到复杂爬取,试图在易用性和扩展性之间取得平衡。项目通过 Discord 和 X 平台运营社区,适用于数据科学、AI 训练数据准备和竞品分析等场景。与 Scrapy、BeautifulSoup 等传统工具相比,Scrapling 宣称的一体化设计可能降低配置复杂度,但实际性能仍需实践检验。文章同时提醒使用者遵守 robots 协议和相关法律法规,并建议从官方文档和小规模试用入手。
为什么Scrapling值得关注
在GitHub上,一个名为Scrapling的Python网页抓取框架正迅速走红。该项目由D4Vinci开发,目前拥有超过92,000颗星和9,700多次fork,单日新增892颗星,显示出极高的社区关注度。Scrapling的定位是“处理从单个请求到全面爬取的一切”,旨在成为网页抓取领域的终极工具。
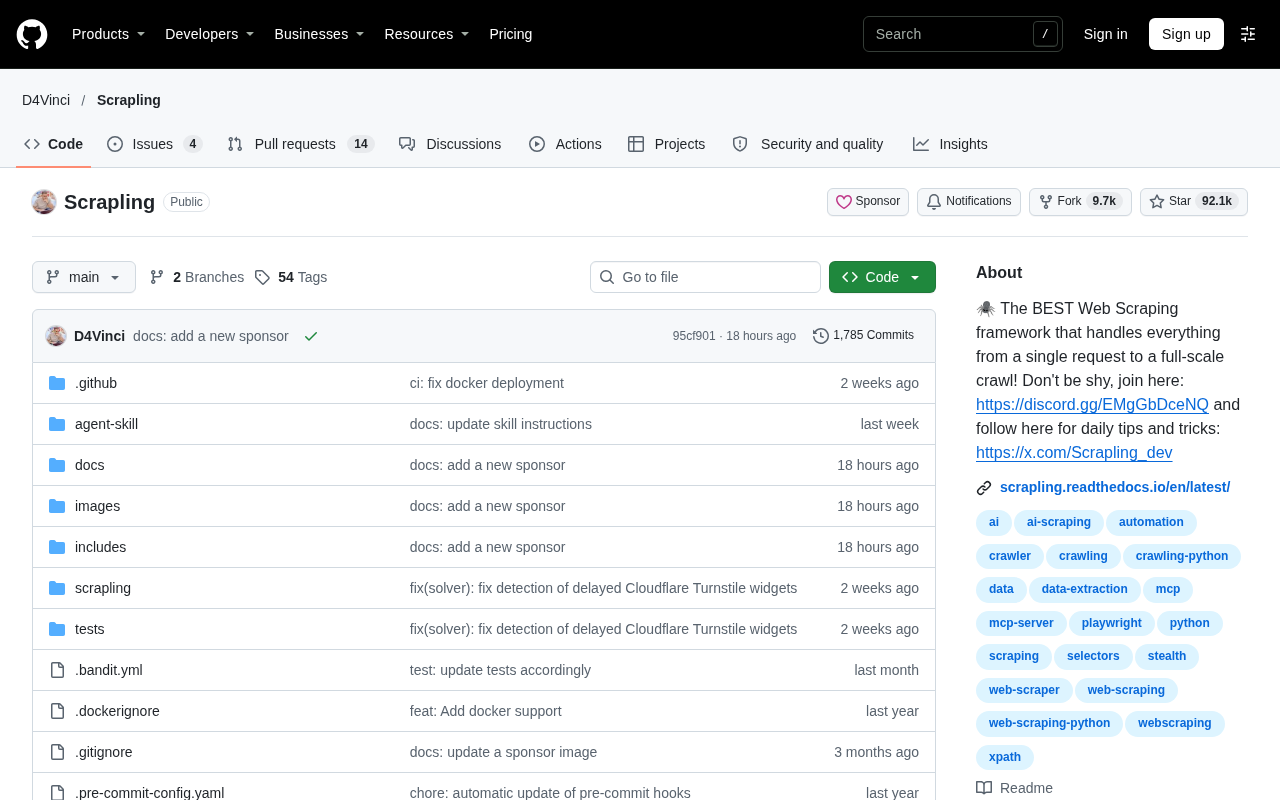
网页抓取是数据采集、竞品分析和AI训练数据准备中的常见需求,但现有工具往往在易用性和扩展性之间难以平衡。Scrapling试图解决这一痛点,提供统一的工作流。
核心功能与设计理念
Scrapling的设计哲学是“不害羞”(Don't be shy),鼓励用户从简单请求开始,逐步扩展到复杂爬取。它基于Python,充分利用了异步编程和现代解析技术。根据项目描述,Scrapling能够处理从单个HTTP请求到大规模分布式爬取的各种场景,而无需切换不同的库或框架。
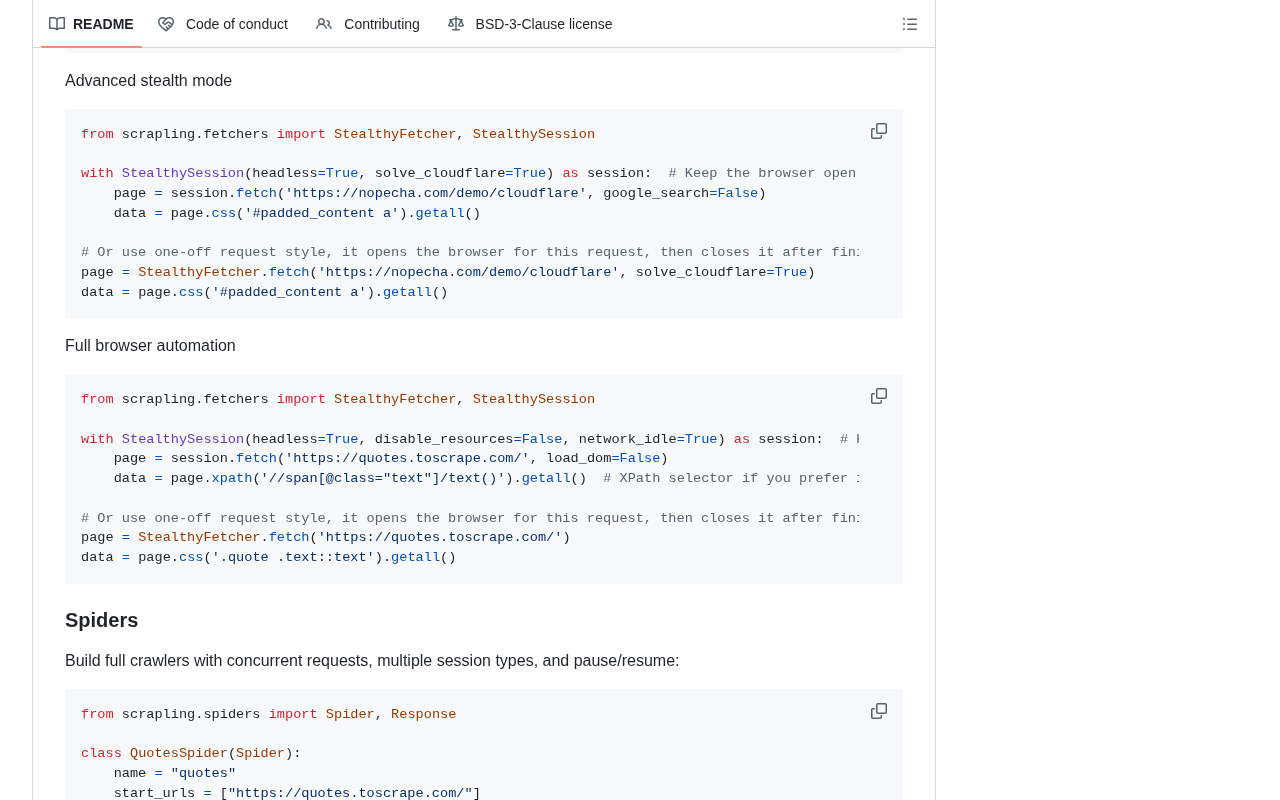
虽然原始素材未详细列出具体功能,但从其定位可以推断,Scrapling可能包含请求管理、反爬绕过、数据解析和并发控制等模块。这种一体化设计减少了开发者在多个工具间切换的成本,尤其适合需要快速原型验证又希望平滑过渡到生产环境的团队。
异步编程在网页抓取中指的是使用 async/await 语法和事件循环,让程序在等待网络响应时能并发处理其他请求,从而大幅提升吞吐量。传统同步爬虫(如基于 requests 的脚本)每个请求都会阻塞线程,难以高效处理大量 URL;而异步框架(如 aiohttp、httpx)可以在单线程内管理数百个并发连接。Scrapling 强调异步,意味着它更适合现代高并发抓取场景,但也要求开发者理解协程的基本用法。
反爬绕过是网页抓取中的常见挑战,网站会通过 IP 黑名单、请求头检测、验证码、JavaScript 渲染等方式阻止自动化访问。常见应对手段包括代理轮换、User-Agent 伪装、无头浏览器(如 Playwright)渲染以及请求频率控制。Scrapling 若定位为“一体化”工具,很可能内置了部分反爬策略,但用户仍需注意合规边界,避免滥用。
社区与生态
Scrapling拥有活跃的社区支持。项目提供了Discord频道(https://discord.gg/EMgGbDceNQ)供用户交流,并在X(原Twitter)上通过@Scrapling_dev分享每日技巧。这种双平台运营有助于快速响应用户反馈和传播最佳实践。
92,000+的星标数表明Scrapling已获得广泛认可,但高关注度也意味着更高的期望。开发者需要持续维护和更新,以保持框架的竞争力。对于潜在用户而言,庞大的社区意味着更丰富的教程、插件和问题解答资源。
适用场景与竞争分析
Scrapling适用于多种场景:数据科学家需要快速抓取网页数据进行分析;AI工程师需要构建训练数据集;企业需要监控竞争对手价格或内容更新。与Scrapy、BeautifulSoup等传统工具相比,Scrapling宣称的“一体化”可能减少配置复杂度,但实际性能需经实践检验。
说个细节,网页抓取领域法律和伦理问题日益突出,Scrapling的使用者应遵守目标网站的robots协议和相关法律法规。框架本身的中立性不代表使用场景的合法性。
Scrapy 是 Python 生态中最知名的爬虫框架,采用基于 Twisted 的异步架构,提供调度器、中间件、管道等完整组件,适合构建大型分布式爬虫,但学习曲线较陡、配置繁琐。BeautifulSoup 则是轻量级 HTML 解析库,常与 requests 搭配使用,上手简单但缺乏并发和请求管理能力。Scrapling 宣称的“一体化”试图在两者之间找到平衡:既提供简单请求的便捷性,又支持向全面爬取平滑扩展。不过,Scrapy 的成熟生态和稳定性和 Scrapling 的易用性仍需在实际项目中权衡。
robots 协议(robots.txt)是网站根目录下的文本文件,用于告知爬虫哪些路径允许或禁止抓取,是爬虫伦理的基本规范。遵守 robots 协议虽无直接法律强制力,但常被作为判断爬虫是否“善意”的依据。此外,网页抓取还需注意《计算机欺诈与滥用法》(CFAA)等法规、网站服务条款以及数据隐私问题(如 GDPR)。开发者应确保抓取行为不侵犯版权、不造成服务器过载,并避免收集个人敏感信息。
未来展望
Scrapling的快速崛起反映了市场对高效抓取工具的旺盛需求。随着AI和大数据应用普及,网页抓取作为数据入口的重要性只增不减。如果Scrapling能持续迭代,解决大规模爬取中的稳定性、反爬和分布式协调问题,它有望成为Python生态中的主流选择。
对于开发者,建议从官方文档和社区案例入手,小规模试用后再评估是否迁移现有爬虫项目。关注其GitHub仓库和社交媒体账号,可及时获取更新动态。
相关推荐

Claude Code + Agent:打造AI全自动测试闭环
B站课程解读:测试开发如何用 Claude Code 终端型 Agent 打造 AI 全自动测试闭环。对比终端型与设备型 Agent 的权限边界,讲清企业级项目为何选 Claude Code 而非 Open Claude 类工具,并梳理 Node.js 环境准备与 DeepSeek 模型搭配的落地路径。

与AI智能体共事,你需要钢铁般的神经
AI智能体越自主,使用者的心理负担反而越重。本文从Hacker News讨论出发,分析智能体协作中的黑箱焦虑、行为漂移与监控疲劳,并给出沙箱隔离、权限控制、任务粒度管理等降低认知负荷的实用思路。

为替代Adobe Acrobat,我自建开源PDF阅读器Folio
开发者因不满Adobe Acrobat臃肿,自建开源PDF阅读器Folio,轻量快速、免费可定制。了解这款替代工具的设计思路与适用场景。