SCRIBE:让大脑语义研究从词袋走向上下文

SCRIBE用开源大模型集成生成可解释的词级语义表示,并在行为与脑成像中验证其与人类语义判断和大脑活动的一致性。
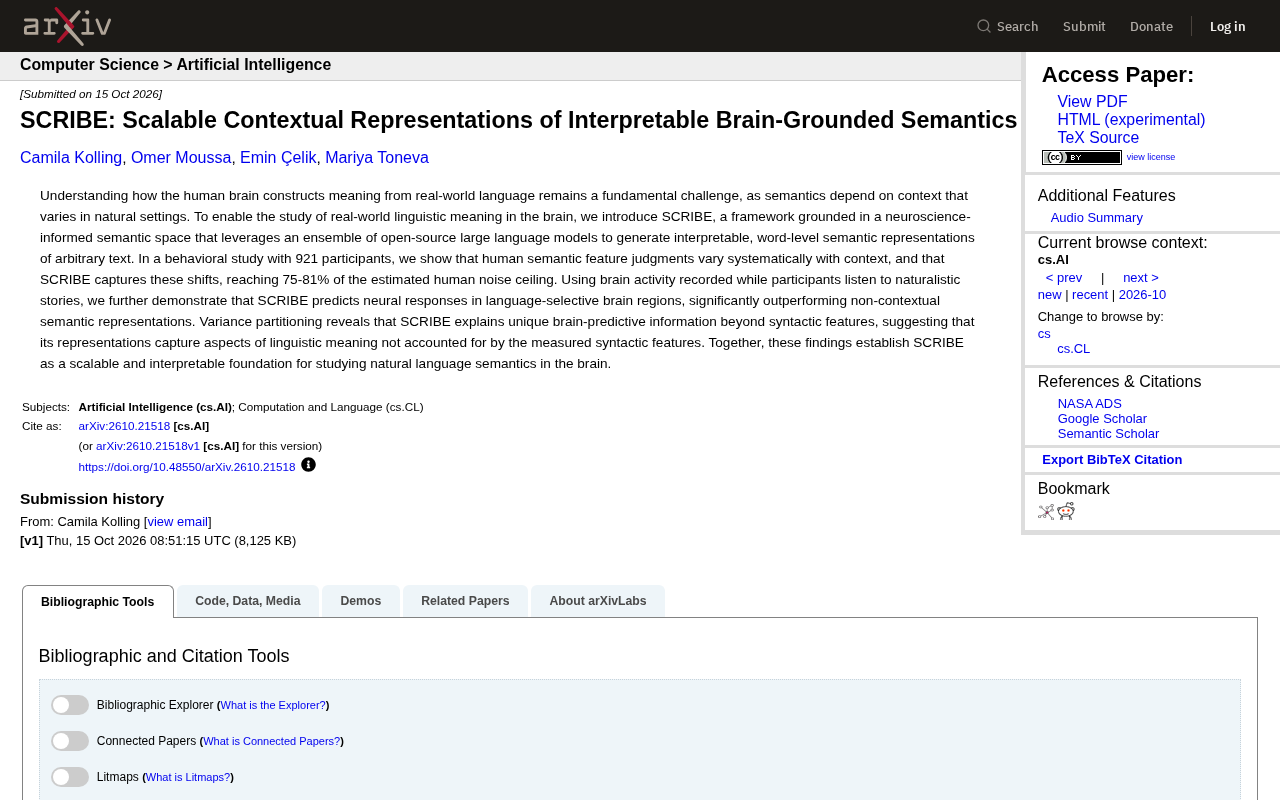
SCRIBE 旨在解决语言神经科学中语义表示随上下文动态变化的问题。它利用开源大语言模型集成生成可解释的词级语义特征表示,而非固定词向量。在 921 人的行为实验中,SCRIBE 追踪了同一词语在不同语境下的语义特征偏移,达到人类噪声上限的 75%–81%。在自然叙事故事的脑活动数据中,SCRIBE 显著优于非上下文语义表示,方差分解显示其在已测句法特征之外仍能解释独特的脑预测信息。该方法论强调可解释性而非单纯预测精度,通过将模型输出约束到人类可理解的语义空间并用外部神经数据验证,为 AI 与神经科学交叉研究提供了新路径。
语言神经科学长期面对一个尴尬:实验室里用孤立的词或句子研究语义,但真实世界的语言意义几乎完全由上下文决定。一个词在不同语境下激活的语义特征并不相同,而传统语义模型往往给出固定的词向量,无法反映这种动态变化。SCRIBE 试图解决这个问题——它用开源大模型集成生成可解释的词级语义表示,并在行为和脑成像两个层面验证了这些表示与人类语义判断和大脑活动的一致性。
语义不是词典条目,而是随上下文漂移的
SCRIBE 的核心出发点是:语义特征判断会随语境系统性地变化。研究团队招募了 921 名参与者进行行为实验,让他们对词语的语义特征进行评分。结果显示,同一个词在不同上下文中的语义特征评分存在稳定且可预测的偏移。SCRIBE 生成的上下文相关表示能够追踪这些偏移,达到人类噪声上限的 75%–81%。噪声上限是行为实验中衡量测量可靠性的上限估计,达到这个水平意味着模型已经捕捉到人类语义判断中大部分可解释的变异。
这一结果本身并不令人意外——大模型在语义任务上表现优异已不是新闻。关键在于 SCRIBE 的设计目标不是追求预测精度,而是可解释性。它输出的不是黑箱向量,而是词级的、可对应到具体语义特征的表示。这使研究者能够追问:大脑在理解语言时,到底在编码哪些语义维度?
噪声上限(noise ceiling)是行为与神经影像研究中的关键统计概念。它的逻辑是:任何测量都包含噪声,因此模型预测与观测数据之间的相关性不可能无限接近1。研究者通常通过重复测量同一被试或同一刺激来估计测量内部的可靠性,从而算出理论上可达到的最大预测水平。如果模型的预测精度已经逼近噪声上限,就说明它已经捕捉到了数据中所有可解释的变异,进一步提升精度只能靠降低测量噪声而非改进模型。SCRIBE 报告中“达到人类噪声上限的75%–81%”意味着它的表示已能解释人类语义判断中大部分可靠变异,剩余差距主要来自实验本身的测量误差,而非模型缺陷。这一指标在认知神经科学中被广泛用于公平比较不同模型的预测能力。
用脑活动验证:上下文表示确实更好
行为实验只能说明 SCRIBE 与人类判断一致,不能说明它反映了大脑实际的计算方式。研究团队进一步使用自然叙事故事 listening 任务中的脑活动数据,检验 SCRIBE 对语言选择性脑区神经反应的预测能力。
结果是,SCRIBE 显著优于非上下文的语义表示。换句话说,要预测大脑在听故事时的反应,考虑上下文比只给固定词义更有效。这为“大脑语义处理本质上是上下文依赖的”提供了神经层面的证据。
更细致的是方差分解分析。研究者将脑预测能力拆解为不同成分,发现 SCRIBE 在句法特征之外仍能解释独特的脑预测信息。这意味着它的表示捕捉到了句法无法覆盖的语义层面。当然,这里的“句法特征”是研究者选取的特定测量集,不代表所有可能的句法信息,所以这个结论应理解为:在已测量的句法维度之外,SCRIBE 有额外贡献。
方差分解(variance partitioning)是一种多元统计方法,用于量化多个预测变量各自对因变量的独立贡献及其共享部分。在脑成像分析中,研究者常将脑活动的时间序列同时回归到多组特征(如语义、句法、音韵等)上,然后通过比较不同模型组合的预测性能,计算出每组特征解释的独特方差与共同方差。SCRIBE 研究中,研究者利用这一方法将脑预测能力拆解,发现语义表示的独特贡献在控制句法特征后依然显著。需要注意的是,方差分解的结果高度依赖所选取的特征集合和模型形式,因此“独特贡献”只能解释为在特定测量框架内的增量信息,并不等于大脑中语义与句法在解剖或功能上完全分离。
为什么“可解释”比“更准”更值得关注
SCRIBE 的方法论选择值得注意。它没有训练一个新模型,而是用一组开源大语言模型集成来生成语义表示。这种做法降低了复现门槛,也让语义表示的来源更透明。对于脑语义研究来说,可解释性比单纯的预测提升更有价值,因为研究目标不是建一个更好的脑活动预测器,而是理解大脑如何表征意义。
当然,SCRIBE 也有其边界。它依赖大模型集成的语义空间,而这个空间本身是否与大脑的语义组织完全对齐,仍是一个开放问题。行为实验中的噪声上限估计也依赖于具体实验设计和参与者群体。此外,自然叙事 listening 任务虽然比传统实验更接近真实语言使用,但仍然是一种受控场景。
大语言模型集成(LLM ensemble)指将多个不同架构或训练数据的大语言模型输出进行组合,以提升表示的鲁棒性和泛化能力。SCRIBE 没有训练单一模型,而是让一组开源大模型分别对同一语境下的词语生成语义特征预测,再通过聚合策略形成最终表示。这种做法的优势在于:单个模型的偏差可以被其他模型稀释,得到的语义空间更稳定;同时,由于所有成员模型都是开源的,任何研究者都可以复现或替换其中的组件。但集成也带来新的解释负担——最终表示的性质取决于成员模型的选择和聚合权重,如果成员模型共享类似的训练偏差,集成也无法消除这些系统性偏差。因此,SCRIBE 的可解释性建立在“语义特征空间”这一中间层上,而非直接解剖某个模型的内部神经元。
对 AI 与神经科学交叉研究的启示
SCRIBE 的意义可能超出脑语义研究本身。它展示了一条路径:用大模型生成可解释的中间表示,再用神经数据验证这些表示是否与大脑计算对齐。这种方法论可以迁移到其他认知领域——只要研究者能够定义可解释的特征空间,并用行为或神经数据检验其与人类认知的对应关系。
对于关注 AI 可解释性的研究者来说,SCRIBE 也提供了一个反向视角:可解释性不一定来自对模型内部机制的解剖,也可以来自将模型输出约束到一个人类可理解的语义空间中,再用外部数据验证其有效性。这种“外部对齐”式的可解释性,在脑科学这类有丰富测量手段的领域尤其可行。
SCRIBE 目前是一个研究框架,不是产品,但其开源路线和可解释设计思路,对于构建更透明、更贴近人类认知的语言模型具有参考价值。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。