Sentry 深度解析:开发者优先的错误追踪与性能监控平台

Sentry 是以开发者为核心的开源错误追踪与性能监控平台,支持实时归因与自托管部署。
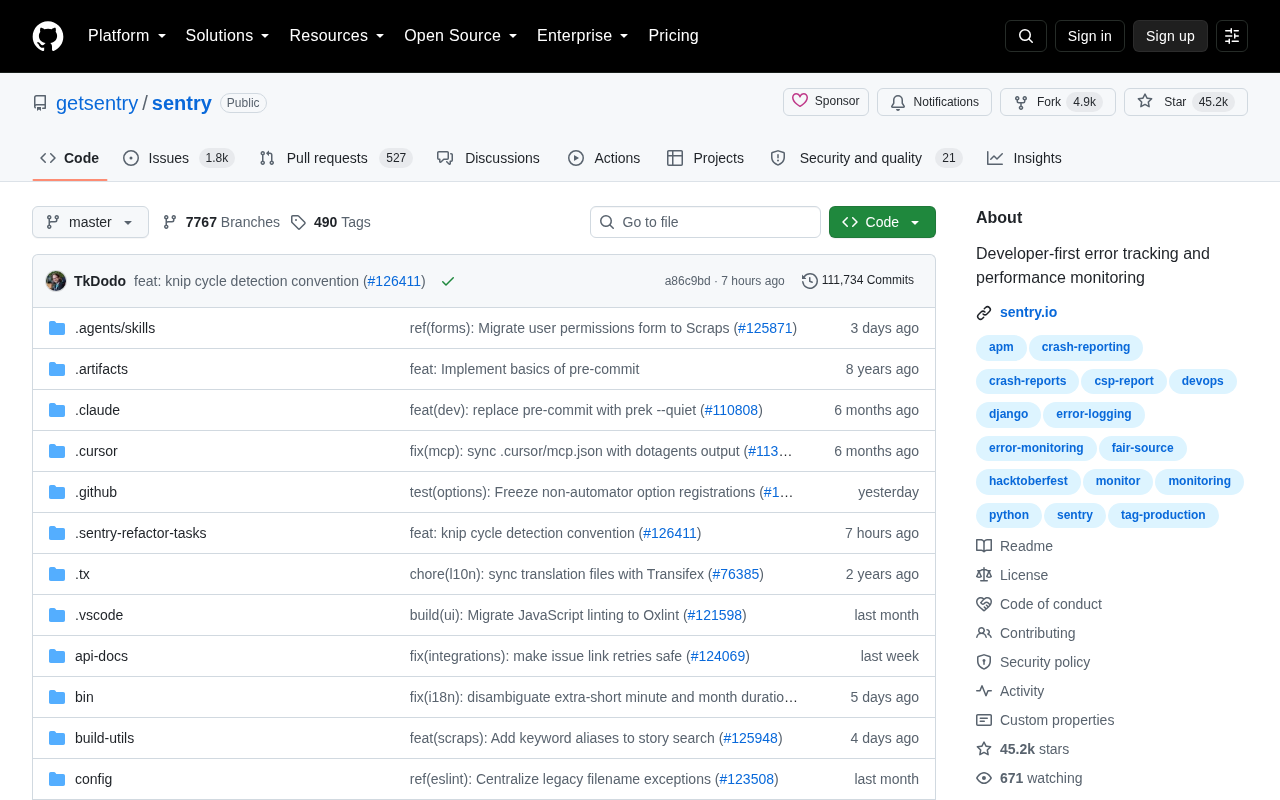
Sentry 是一款「开发者优先」的应用监控平台,核心解决生产环境中的错误追踪与性能监控两大问题。它能实时捕获异常并提供堆栈跟踪、代码行级归因等完整上下文,通过指纹算法自动聚合去重,让团队基于影响面数据排定修复优先级。在性能侧,Sentry 以分布式追踪技术追踪请求完整生命周期,识别慢查询和接口瓶颈。项目主体由 Python 编写,提供覆盖主流语言的 SDK,既可使用 SaaS 服务,也支持通过 Docker Compose 完整私有化部署,满足数据合规需求。凭借广泛的语言支持、灵活的部署方式和活跃的社区,Sentry 在 GitHub 已累积超过 45,000 Stars,成为可观测性领域最受开发者认可的开源方案之一。
Sentry 深度解析:开发者优先的错误追踪与性能监控平台
在现代软件开发中,应用上线只是开始,真正的挑战在于如何及时发现并定位生产环境中的异常。Sentry(getsentry/sentry)作为一款以「开发者优先」(Developer-first)为核心理念的错误追踪与性能监控工具,目前在 GitHub 上已累积超过 45,000 Stars,单日新增 214 Stars,是开源可观测性领域最受关注的项目之一。
什么是 Sentry
Sentry 本质上是一个应用监控平台,专注于解决两类核心问题:错误追踪(Error Tracking) 和 性能监控(Performance Monitoring)。当你的应用在生产环境抛出异常时,Sentry 能够实时捕获这些错误,并提供完整的上下文信息——包括堆栈跟踪、请求参数、用户操作路径、运行环境等,帮助开发者快速定位问题根源,而不是依赖用户反馈或翻阅零散的日志文件。
该项目主体使用 Python 编写,目前拥有 4,898 个 Forks,活跃的社区贡献和持续的更新使其成为企业级监控方案的重要选择。它既可以作为 SaaS 服务使用,也支持开发者自行私有化部署,兼顾了便捷性与数据自主可控的需求。
「开发者优先」意味着什么
Sentry 最鲜明的标签是「Developer-first」,这不仅是一句口号,而是贯穿产品设计的核心哲学。传统的监控工具往往面向运维团队,关注的是服务器指标和系统健康度。Sentry 则把视角拉回到写代码的人身上。
当错误发生时,Sentry 会直接将异常关联到具体的代码行、提交记录(commit)甚至引入问题的开发者。这种细粒度的归因能力,大幅缩短了从「发现问题」到「修复问题」的链路。开发者无需在海量日志中大海捞针,而是能够直接看到「哪一行代码、在什么条件下、影响了多少用户」。
错误追踪的核心价值
错误追踪是 Sentry 的立身之本。它会自动对相似的异常进行聚合去重,避免同一个 Bug 产生成千上万条重复告警。同时,它记录了错误发生的频率趋势、受影响的用户数量和设备分布,让团队能够基于数据对问题进行优先级排序,优先处理影响面最大的缺陷。
Sentry 的异常聚合机制基于「指纹(Fingerprint)」算法:系统会对每条异常的堆栈帧、异常类型、错误消息等特征进行哈希计算,将具有相同指纹的事件归并为同一个「Issue」。这一机制解决了传统日志监控的核心痛点——一次线上事故可能在数分钟内触发数万条日志,但在 Sentry 中只呈现为一个带有「发生 N 次、影响 M 用户」统计数字的单一条目。除了自动指纹,团队还可以通过自定义指纹规则或手动合并 Issue 来处理边缘情况,例如因动态参数导致误判为不同问题的同类错误。与此同时,Sentry 的「Source Maps」功能对前端开发者尤为关键:JavaScript 在生产环境通常经过压缩混淆,Source Maps 能将压缩后的报错位置还原为可读的原始代码行号,使前端异常的定位效率与后端持平。
性能监控的延伸
随着可观测性需求的演进,Sentry 从单纯的错误追踪扩展到性能监控领域。它能够追踪请求的完整生命周期,识别慢查询、接口瓶颈和前端渲染延迟等性能问题。这意味着开发者不仅能知道「什么崩了」,还能知道「什么变慢了」,形成对应用质量的全方位洞察。
Sentry 的性能监控以「分布式追踪(Distributed Tracing)」为技术基础,其核心数据单元是「Transaction(事务)」和「Span(跨度)」。一个 Transaction 代表一次完整的操作(如处理一个 HTTP 请求),其内部由多个 Span 组成,每个 Span 对应一段具体的耗时操作——数据库查询、外部 API 调用、缓存读写等。这种层级结构以瀑布图形式可视化后,可以直观展示哪个环节拖慢了整体响应。在微服务架构下,Sentry 通过在请求头中传播 Trace ID,将跨越多个服务的调用链串联成一条完整的追踪记录,让开发者无需在多个系统间手动关联日志即可定位跨服务的性能瓶颈。这一能力与 OpenTelemetry 标准兼容,便于与已有的可观测性基础设施集成。
为什么它能获得 4.5 万 Stars
Sentry 的持续热度背后有几个关键因素值得剖析。
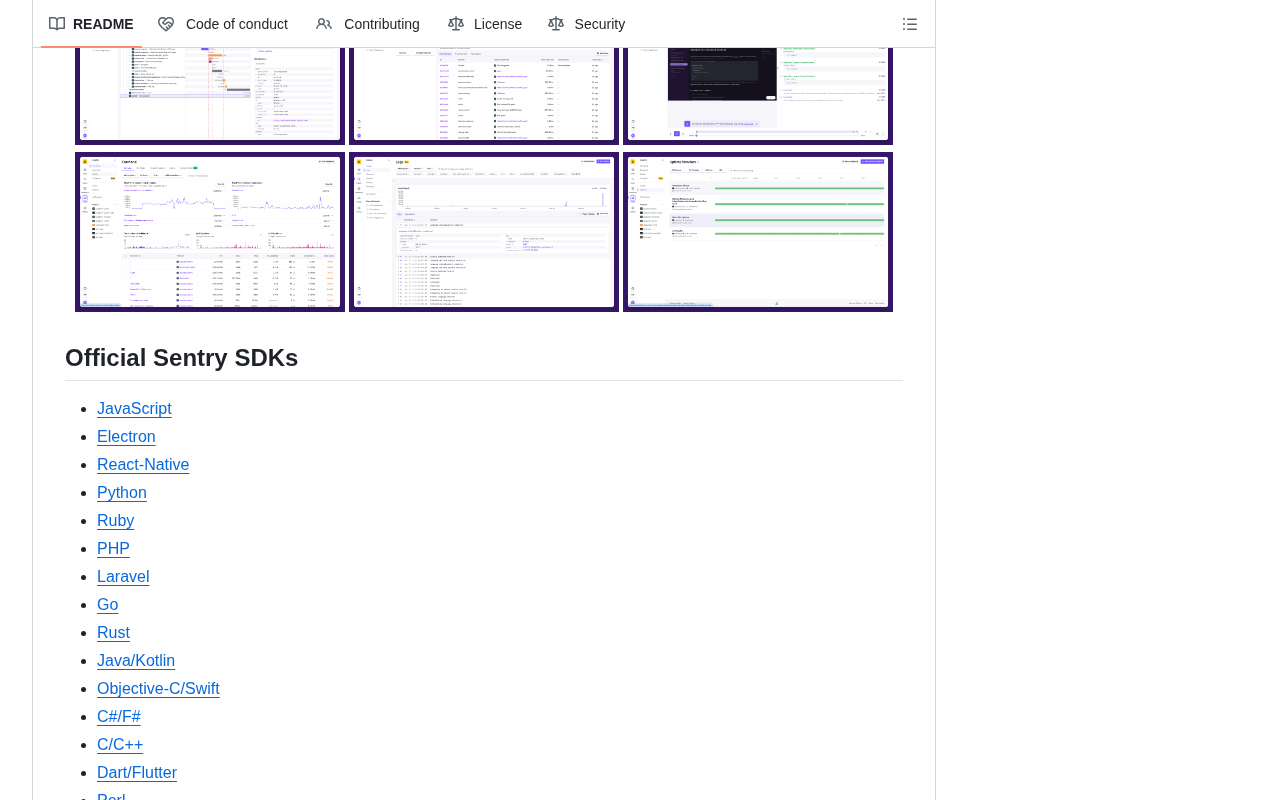
多语言生态支持 是其一。Sentry 提供了覆盖主流编程语言和框架的 SDK,无论是 JavaScript、Python、Java、Go 还是移动端的 iOS/Android,开发者都能以极低的接入成本集成监控能力。这种广泛的兼容性使其能够服务于从初创团队到大型企业的各类技术栈。
开源与自托管的灵活性 是其二。在数据合规和隐私日益重要的当下,很多企业不愿将敏感的错误数据交给第三方 SaaS。Sentry 的开源属性允许团队在自己的基础设施上完整部署整套系统,掌握数据主权的同时享受企业级监控能力。
活跃的社区与迭代速度 是其三。单日新增 214 Stars 的增长速度,反映出项目依然保持着强劲的生命力。持续的功能更新和社区贡献,使 Sentry 能够快速响应现代开发实践的变化。
适用场景与价值
对于任何运行着线上服务的团队来说,Sentry 都值得纳入技术选型的考量。它特别适合以下场景:需要快速响应生产故障的敏捷团队、对代码质量有高要求的工程文化、以及因合规需求必须私有化部署监控系统的企业。
从工程效率的角度看,Sentry 真正解决的痛点是「信息滞后」。在没有成熟监控工具的情况下,一个线上 Bug 可能要等到用户投诉才被发现,而定位问题又要耗费大量时间翻查日志。Sentry 把这个过程压缩到了实时告警加精准归因,让开发团队能够以更主动的姿态维护应用稳定性。
总结
Sentry 之所以能在竞争激烈的可观测性赛道中占据一席之地,根本原因在于它始终站在开发者的立场思考问题。它不只是一个告警工具,更是贯穿「发现—定位—修复」全流程的工程效率平台。对于重视应用质量和开发者体验的团队而言,Sentry 提供了一套成熟、灵活且社区活跃的解决方案,无论是直接使用 SaaS 还是私有化部署,都能有效提升故障响应能力。
背景补充
自托管 Sentry 的主要方式是官方维护的 self-hosted 仓库,底层依赖 Docker Compose 编排一套包含 PostgreSQL、Redis、Kafka、ClickHouse 等多个组件的服务栈。ClickHouse 承担事件数据的高速写入与查询,Kafka 则负责在数据摄入层提供缓冲与削峰。这意味着自托管对服务器资源有一定要求,官方建议最低配置为 4 核 CPU 与 16 GB 内存,生产级部署通常需要更多资源并配合定期的数据清理策略控制磁盘占用。对于资源有限的小型团队,也可以选择只启用错误追踪功能以降低资源消耗,或使用社区维护的 Kubernetes Helm Chart 在容器集群上部署以获得更好的弹性扩展能力。
相关推荐

Claude Code本地化部署全解析:用本地模型玩转Vibe Coding
深入解析Claude Code本地化部署原理:如何用Ollama、vLLM等推理引擎将本地模型包装成API服务,让Claude Code脱离云端运行,摆脱token成本。涵盖显卡配置、模型选型与量化技巧。

Normalizing Trajectory Models:让少步生成重拾精确似然框架
Normalizing Trajectory Models(NTM)将扩散模型反向过程的每一步建模为条件归一化流,实现少步生成下的精确似然训练,兼顾速度与概率框架完整性,突破蒸馏与一致性训练的局限。

LangGraph生产级实战:五年Agent架构经验的沉淀
一位五年Agent开发老兵开源LangGraph生产级参考项目并撰写博客系列,分享从条件树到图状态机的架构演进经验,剖析LangGraph在可维护性与团队协作上的真正价值。