SereneDB:融合搜索与分析的开源数据库,为Agentic AI而生

SereneDB 是一款兼容 Postgres 与 Elasticsearch 的开源引擎,主打将全文检索与分析查询合二为一。
SereneDB 是一款宣称历经 12 年打磨的开源数据库引擎,核心价值主张是将全文检索与分析型查询整合到单一系统,从而消除企业普遍需要同时维护 Elasticsearch 与 ClickHouse 两套系统及其之间 ETL 管道的成本。它同时兼容 Postgres 与 Elasticsearch 协议,允许开发者在不改写应用逻辑的前提下迁移现有工作负载。官方公开的基准测试显示其索引 10 亿条日志耗时不到 8 分钟、磁盘占用约为对比系统的十分之一,并以 Apache 2.0 开源。项目还专门强调了对 Agentic AI 工作负载的适配,契合 AI Agent 同时依赖快速检索与实时分析的技术需求。对于有意采用的团队,建议先以自身真实负载做小规模验证,再决定是否深度引入。
近日在 Product Hunt 上登上开源分类的 SereneDB,用一个颇具野心的定位吸引了开发者社区的注意:一个能同时胜任超快全文检索与快速分析的开源数据库引擎。它宣称经过 12 年开发打磨,兼容 Postgres 与 Elasticsearch,并在公开基准测试中超越了 Elasticsearch、ClickHouse 以及 Postgres 的搜索扩展。
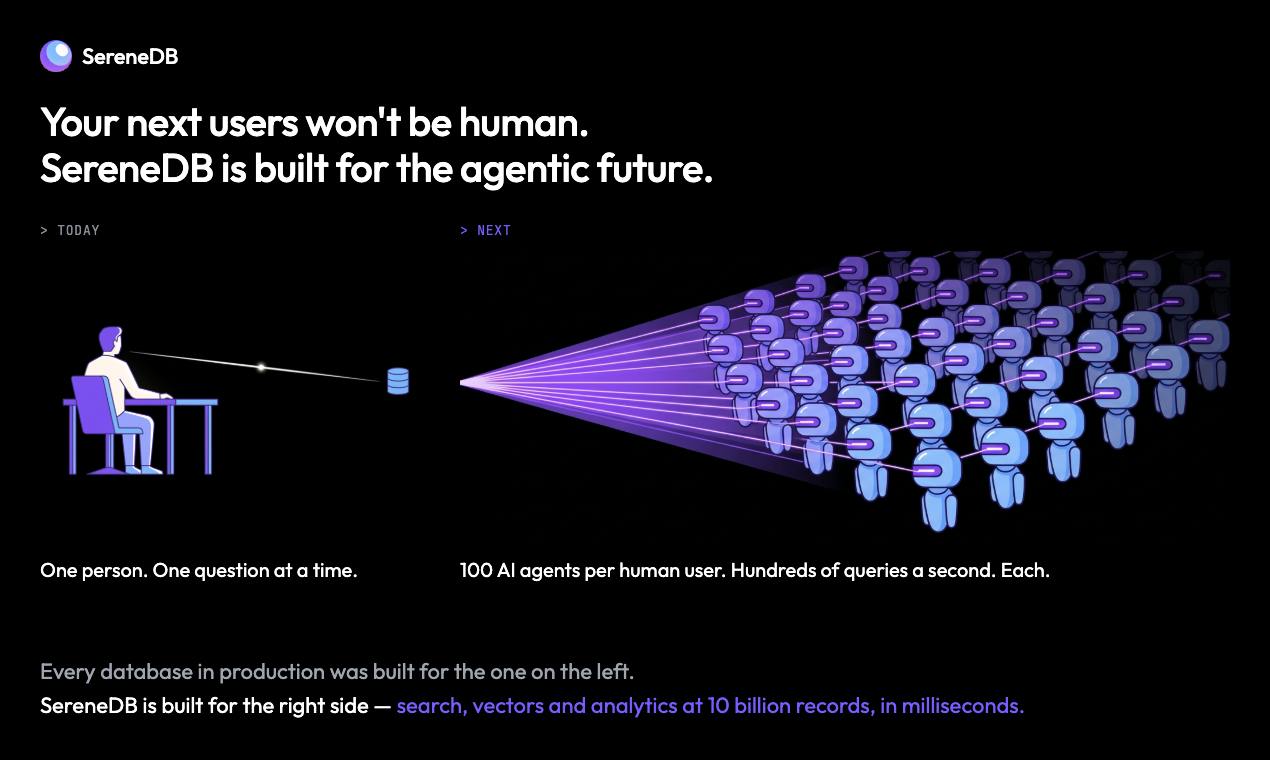
一个引擎解决两类问题
长期以来,企业在处理数据时往往要维护两套系统:一套负责全文检索(如 Elasticsearch),一套负责分析型查询(如 ClickHouse 或列式数据库)。两套系统之间通常需要复杂的 ETL 管道来同步数据,这不仅增加了运维成本,也带来了数据一致性和延迟的问题。
SereneDB 的核心卖点正是打破这一格局——把全文检索与快速分析融合到单一引擎中。用官方的话说,你可以「保留你的 SQL、你的驱动、你的 Elastic 客户端,然后砍掉第二套系统以及它们之间的 ETL」。这种「二合一」的思路对于希望简化技术栈的团队而言,具有实际的吸引力。
兼容性是落地的关键
真正让这个项目区别于众多「重新发明轮子」式数据库的,是它对现有生态的兼容。SereneDB 同时兼容 Postgres 与 Elastic 协议,意味着开发者理论上无需重写应用逻辑,就能把已有的查询、驱动和客户端迁移过来。这种「无痛迁移」的承诺,往往是决定一个新数据库能否被采用的分水岭——技术再先进,如果迁移成本过高,也难以在生产环境中落地。
ETL(Extract, Transform, Load)管道是数据工程中的基础概念,指将数据从一个系统抽取、转换格式后写入另一个系统的流程。在双系统架构中,ETL 不仅意味着额外的基础设施成本,还会引入数据延迟——数据从写入 Elasticsearch 到出现在 ClickHouse 中往往需要数分钟甚至数小时。这种延迟在需要实时决策的 AI Agent 场景中尤为棘手。更深层的问题是数据一致性:两套系统之间如果同步失败或产生漂移,会导致对同一数据集的检索结果与分析结果出现矛盾,排查此类问题的成本往往远超系统本身的维护成本。
基准测试数据看点
性能是 SereneDB 主打的另一张牌。根据官方公布的公开基准测试,其亮点包括:
- 在全文检索和分析场景中,性能优于 Elasticsearch、ClickHouse 和 Postgres 搜索扩展;
- 索引 10 亿条日志耗时不到 8 分钟;
- 磁盘占用约为对比系统的十分之一。
值得肯定的是,官方将基准方法论和原始结果全部公开,这在数据库性能宣传普遍「报喜不报忧」的行业环境中,是一种相对负责任的做法。当然,任何厂商自测的基准都需要保持审慎——不同的数据分布、查询模式和硬件配置都可能显著影响结果。对开发者而言,最稳妥的方式仍是结合自身负载做实际验证。
磁盘占用约为对比系统十分之一这一数字,背后通常涉及存储格式的设计差异。Elasticsearch 为支持实时检索会维护大量倒排索引和段文件,ClickHouse 则采用列式压缩存储,而一个针对两类场景同时优化的引擎若能共用底层存储结构,理论上可以避免同一份数据被分别索引两次的空间浪费。不过,磁盘占用的减少有时也意味着在写入速度或查询灵活性上有所取舍,评估时需结合具体场景权衡。
面向 Agentic AI 的定位
SereneDB 的标语中特意强调了「Agentic AI ready」。在 AI Agent 逐渐成为应用开发主流范式的当下,这一定位并非空洞的营销词。Agent 系统通常需要频繁地检索海量非结构化文本(如日志、文档、知识库),同时又要对这些数据进行实时分析和聚合。一个既能做快速全文检索、又能做分析查询的统一引擎,恰好契合了这类工作负载的特征。
换句话说,SereneDB 试图成为 AI Agent 的数据后端——让 Agent 在单一系统中完成「查得快」与「算得快」两件事,而不必在多个数据存储之间来回搬运数据。
Agentic AI 指能够自主规划、调用工具并迭代执行多步骤任务的 AI 系统,与传统单轮问答式 AI 有本质区别。典型的 Agent 工作流程包括:从知识库或日志中检索相关上下文(依赖全文检索),对检索结果进行统计分析或异常检测(依赖分析查询),再将结果反馈给模型进行下一步推理。这一模式要求底层数据系统既能处理非结构化文本的语义/关键词搜索,又能高效执行聚合、过滤等分析操作。传统做法是在向量数据库(用于语义检索)、Elasticsearch(用于全文检索)和分析数据库之间各取所需,而统一引擎的价值就在于减少跨系统的网络往返和数据序列化开销,对响应延迟要求极高的 Agent 场景尤为关键。
开源与社区
SereneDB 采用 Apache 2.0 许可证开源,这对企业采用是重要的信号——宽松的许可意味着更低的合规风险和更高的可定制空间。项目在 Product Hunt 上获得 105 个赞、排名第 5,分类涵盖 Open Source、Developer Tools、GitHub 与 Database,显示出社区对开源数据库工具的持续兴趣。
项目由包括 Andrey Abramov 在内的团队打造。对于一个宣称经历了 12 年开发的项目来说,其技术积累值得关注,但真正的考验将来自更广泛的生产环境采用和第三方独立评测。
值得关注但需理性评估
SereneDB 描绘了一幅诱人的图景:一个引擎、双重能力、兼容主流生态、开源免费,还专为 AI Agent 优化。如果这些承诺都能在真实场景中兑现,它有潜力成为简化数据基础设施的有力选项。
不过,数据库是极其看重稳定性和长期可靠性的基础软件,新项目要真正赢得信任需要时间。建议感兴趣的团队先在非核心业务上做小规模试点,用自己的数据和查询模式验证官方基准的可复现性,再决定是否深度采用。对于正在为 AI Agent 构建数据后端、或苦于维护检索与分析双系统的团队来说,SereneDB 至少提供了一个值得放进候选清单的新选择。
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。