shadcn/improve:用最强模型审计代码库,让廉价模型执行计划

shadcn/improve 用强模型审计写计划、廉价模型按计划执行,降低 AI 编程成本。
文章介绍了 GitHub 开源项目 shadcn/improve 的核心思路:将 AI 编程流程拆分为「强模型审计」与「廉价模型执行」两个阶段。强模型(如 Claude Opus)通读代码库、识别问题并输出结构化可执行计划;廉价模型(如 Claude Haiku)按计划逐条修改代码。这种分工类似架构师写设计文档、工程师按文档实现,既保留了高质量决策,又大幅降低 token 成本。文章还分析了该模式对团队协作的启示:计划本身可作为 PR 描述或技术债清单,执行阶段边际成本低,且廉价模型因不需理解全局而降低胡编乱造风险。同时也指出其依赖计划质量,建议审计后人工快速过一遍计划再执行。项目星标已破万,适合中大型代码库的重构与技术债清理。
为什么需要「强模型审计 + 廉价模型执行」的分工
随着 AI 编程工具普及,一个现实矛盾越来越突出:最聪明的模型(如 Claude Opus、GPT-4 级别)能深入理解代码库并给出高质量重构方案,但成本高昂;而便宜模型(如 Haiku、GPT-3.5 级别)执行简单任务尚可,却难以独立完成复杂分析。
GitHub 上开源项目 shadcn/improve 提出了一个优雅的解决思路:让最强大的模型审计代码库并撰写执行计划,然后交给更便宜的模型去逐条落地。这个项目在 GitHub 上已获得超过 1 万颗星,单日新增 333 星,说明切中了开发者的真实痛点。
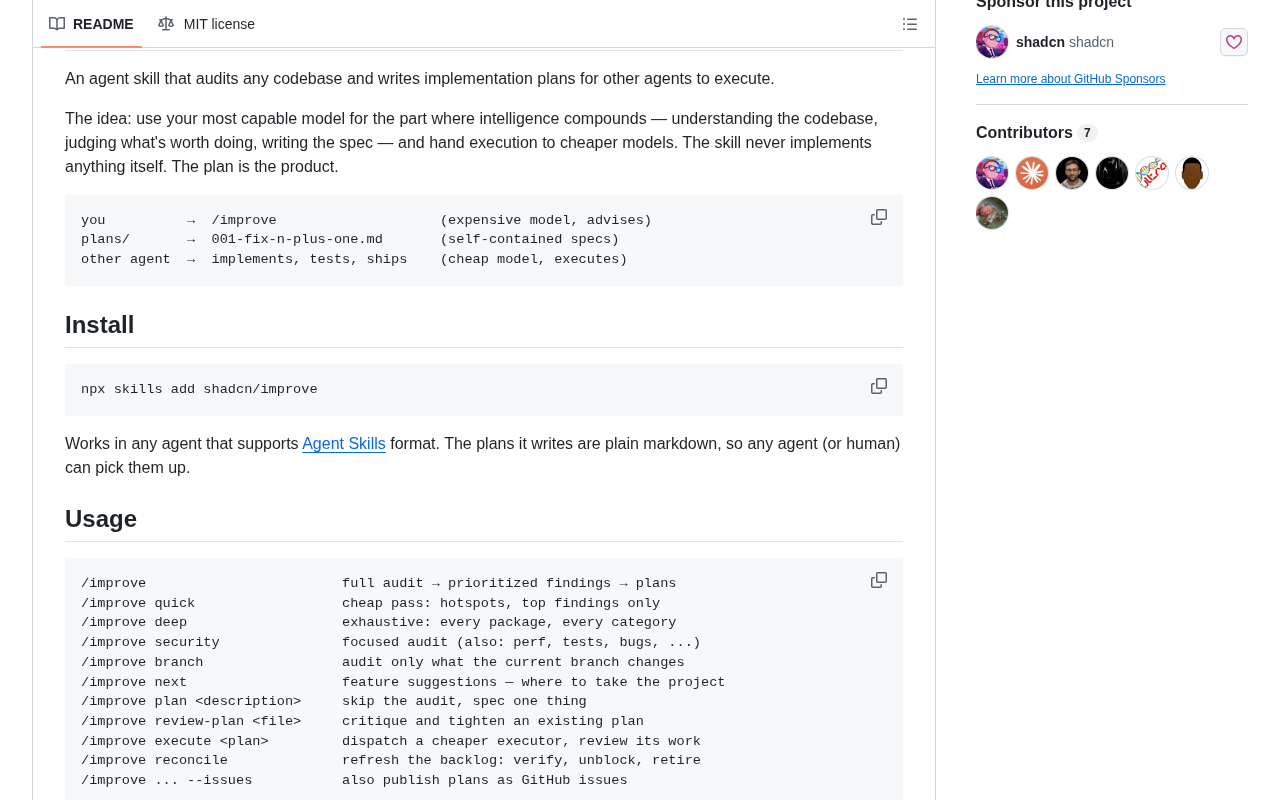
核心理念:把「思考」与「执行」拆开
传统用法中,开发者往往直接让一个中等模型完成「分析 + 修改」全流程,结果要么质量不佳,要么反复调试消耗大量 token。shadcn/improve 将流程拆成两个阶段:
- 审计阶段:使用你最强的模型(如 Claude Opus)通读代码库,识别问题、提出改进方向,并输出结构化、可执行的计划文件。
- 执行阶段:将计划交给成本更低的模型(如 Claude Haiku 或其他轻量模型),按步骤完成代码修改。
这种分工类似软件工程中的「架构师写设计文档,工程师按文档实现」。强模型负责高价值的判断与规划,廉价模型负责机械性执行,整体成本显著降低,同时保留了高质量决策。
模型级联(Model Cascading) 是这里分工思路的理论基础:将任务按难度分层,把高难度部分交给大模型、低难度部分交给小模型,从而在保证质量的前提下压缩推理成本。与「模型路由(Model Routing)」按输入内容动态选择模型不同,级联更强调任务阶段的先后依赖——前一阶段的输出(计划)成为后一阶段的输入(执行约束)。实践中常见的变体包括:审计阶段用强模型生成计划并附带验收标准,执行阶段用小模型逐条完成,再由一个轻量校验步骤(可用规则脚本或小模型)检查是否符合计划。级联的效果取决于阶段边界是否清晰、计划是否足够具体,否则小模型容易在模糊指令下产生偏差。
项目特点与使用方式
shadcn/improve 以开源形式发布,语言栈与 shadcn 生态保持一致。从仓库描述看,它并非一个复杂的框架,而是一套可复用的工作流与提示词集合,帮助你把「审计—计划—执行」串起来。
典型使用流程包括:
- 在项目根目录运行审计命令,选择你当前可用的最强模型;
- 模型生成一份或多份改进计划,描述具体要改什么、为什么改、如何验证;
- 切换至廉价模型,按计划逐条执行,并可分批次提交。
由于项目刚发布不久,具体 CLI 参数和集成方式建议直接查阅仓库 README。但仅从设计理念看,它已经为「AI 编程成本优化」提供了一个可落地的范式。
结构化计划文件通常指以 Markdown 或 YAML 形式描述的任务清单,每条包含:目标文件/函数定位、问题描述、修改意图、验收方式(如测试命令、预期行为)。这种格式的价值在于把「自然语言建议」转成「可执行规格」,使廉价模型无需理解全局架构即可按条目操作,也便于人类 review 与版本管理。计划文件的粒度建议控制在单条改动可独立验证的范围,避免一条计划覆盖多个文件导致执行阶段难以定位失败原因。同时,计划中应显式列出不在本次范围内的改动,防止执行模型自行扩大修改面。
对开发工作流的实际影响
这种模式对团队协作有几点启示:
计划即文档。强模型产出的计划本身可读性强,能作为 PR 描述或技术债清单,方便人类 review。
成本可控。审计阶段 token 消耗大,但只跑一次;执行阶段重复性高,用便宜模型批量处理,边际成本大幅下降。
质量下限有保障。便宜模型不需要「理解全局」,只需按步骤操作,降低了胡编乱造的风险。
当然,这种分工也依赖计划的质量——如果强模型遗漏关键上下文,执行阶段可能跑偏。因此建议在审计后人工快速过一遍计划,再交给廉价模型执行。
技术债(Technical Debt) 指为短期速度而做出的次优设计选择所积累的长期维护成本,如重复代码、缺失测试、不一致的命名与风格、过时的依赖等。技术债的特点是分散且数量大,逐条人工处理成本高,恰好适合「强模型一次性识别 + 廉价模型批量修复」的模式。审计阶段可以把技术债按影响面与修复难度排序,形成优先级队列;执行阶段则按批次处理低风险项,高风险项留待人工介入。这种分层处理能避免廉价模型在涉及架构调整的改动上做出错误判断。
适合谁用
如果你经常用 AI 辅助重构、清理技术债、统一代码风格,或者维护一个中大型代码库,shadcn/improve 的思路值得借鉴。它不绑定特定模型厂商,你可以根据预算灵活选择「审计模型」与「执行模型」的组合。
项目目前星标数已破万,社区关注度高,后续很可能衍生出更多工具集成。对于关注 AI 编程效率与成本的开发者,这是一个值得跟踪的开源项目。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。